- AI

- AI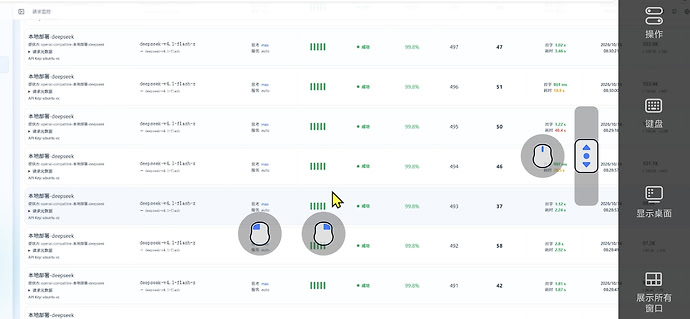
- AI目前我自己部署在4台spark的deepseek v4.1flash 可以到做散文单流7~80tps 多流200+tps 多并发单流会下降到30~40tps一流 上下文看需求可以调整目前我是600k上下文,权重量化程度对标官方混合量化,不是那种q1~q3的精度。(两台部署的glm5.3f exl3 fp4~fp8的 在单流40~60tps,多流应该有一百多) 这个方案适合小团队用
- AI