- zzutmebwd2026-09-03
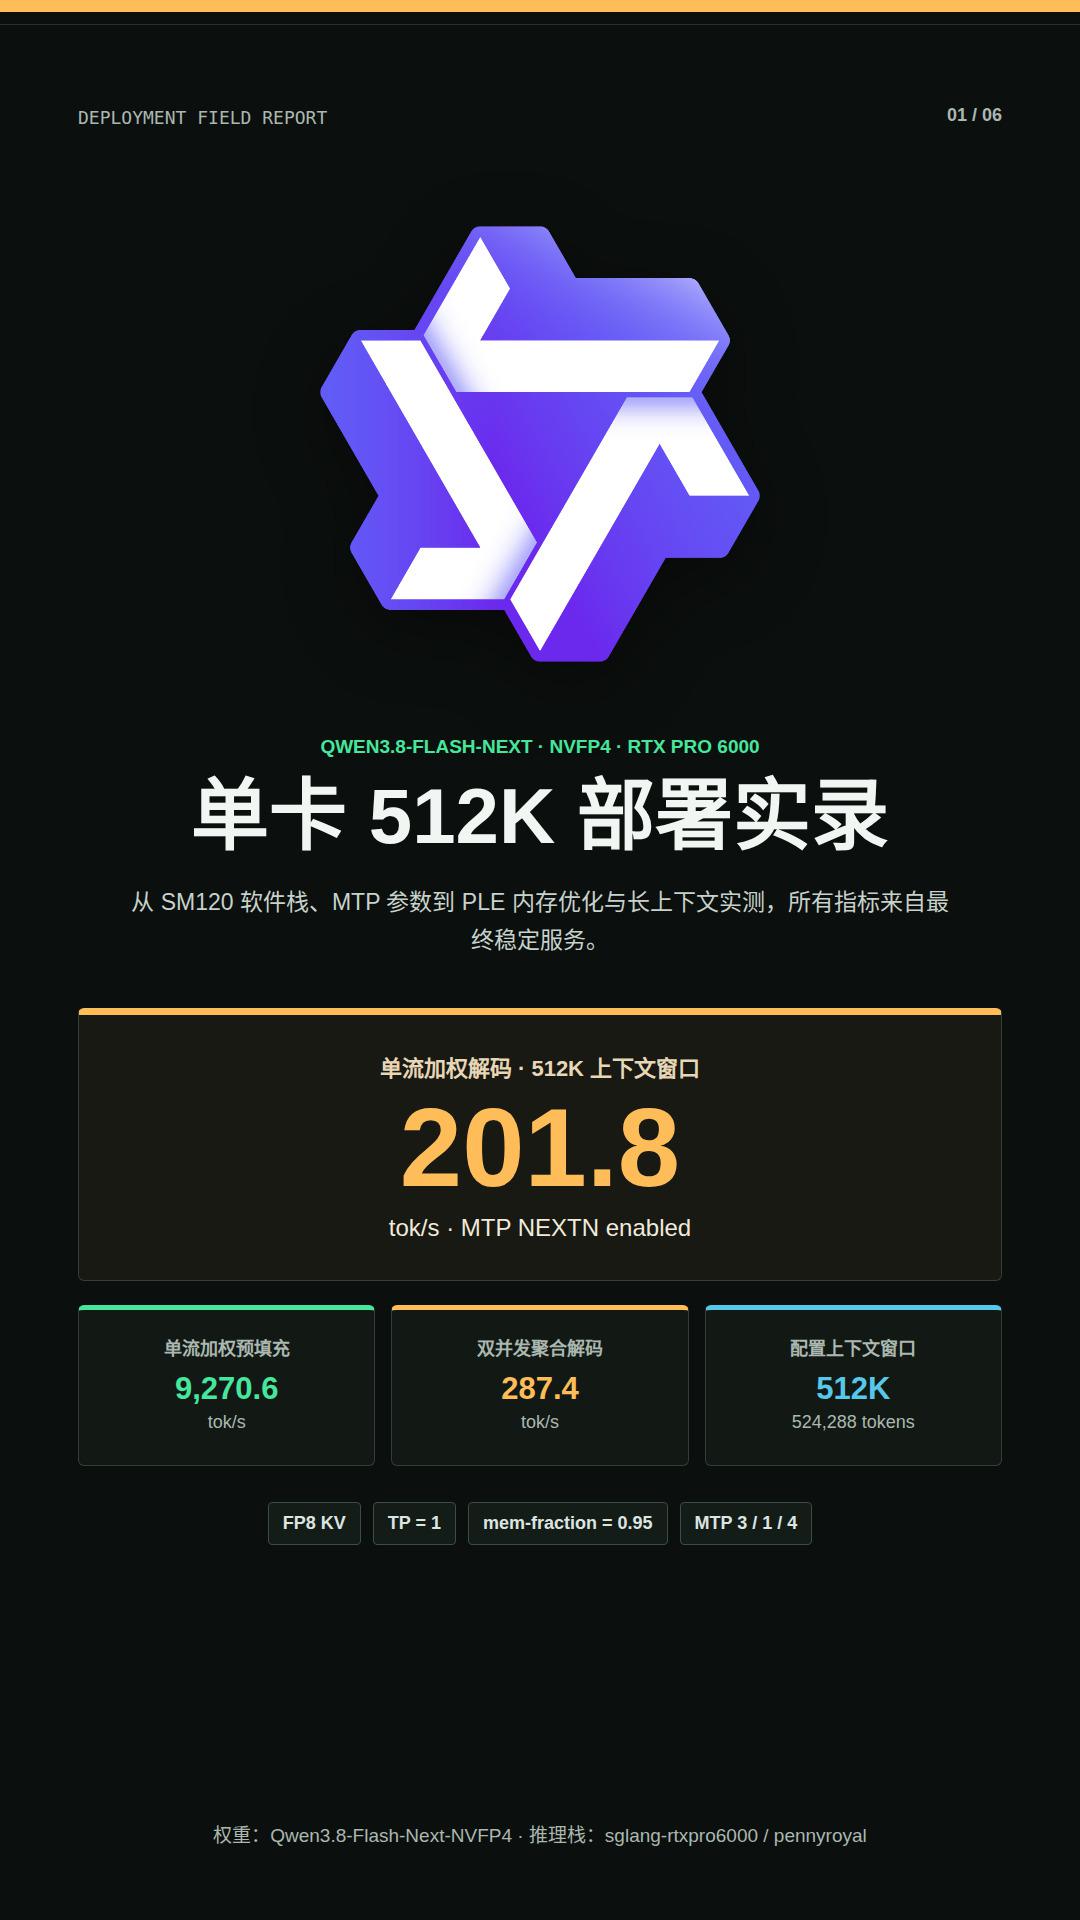
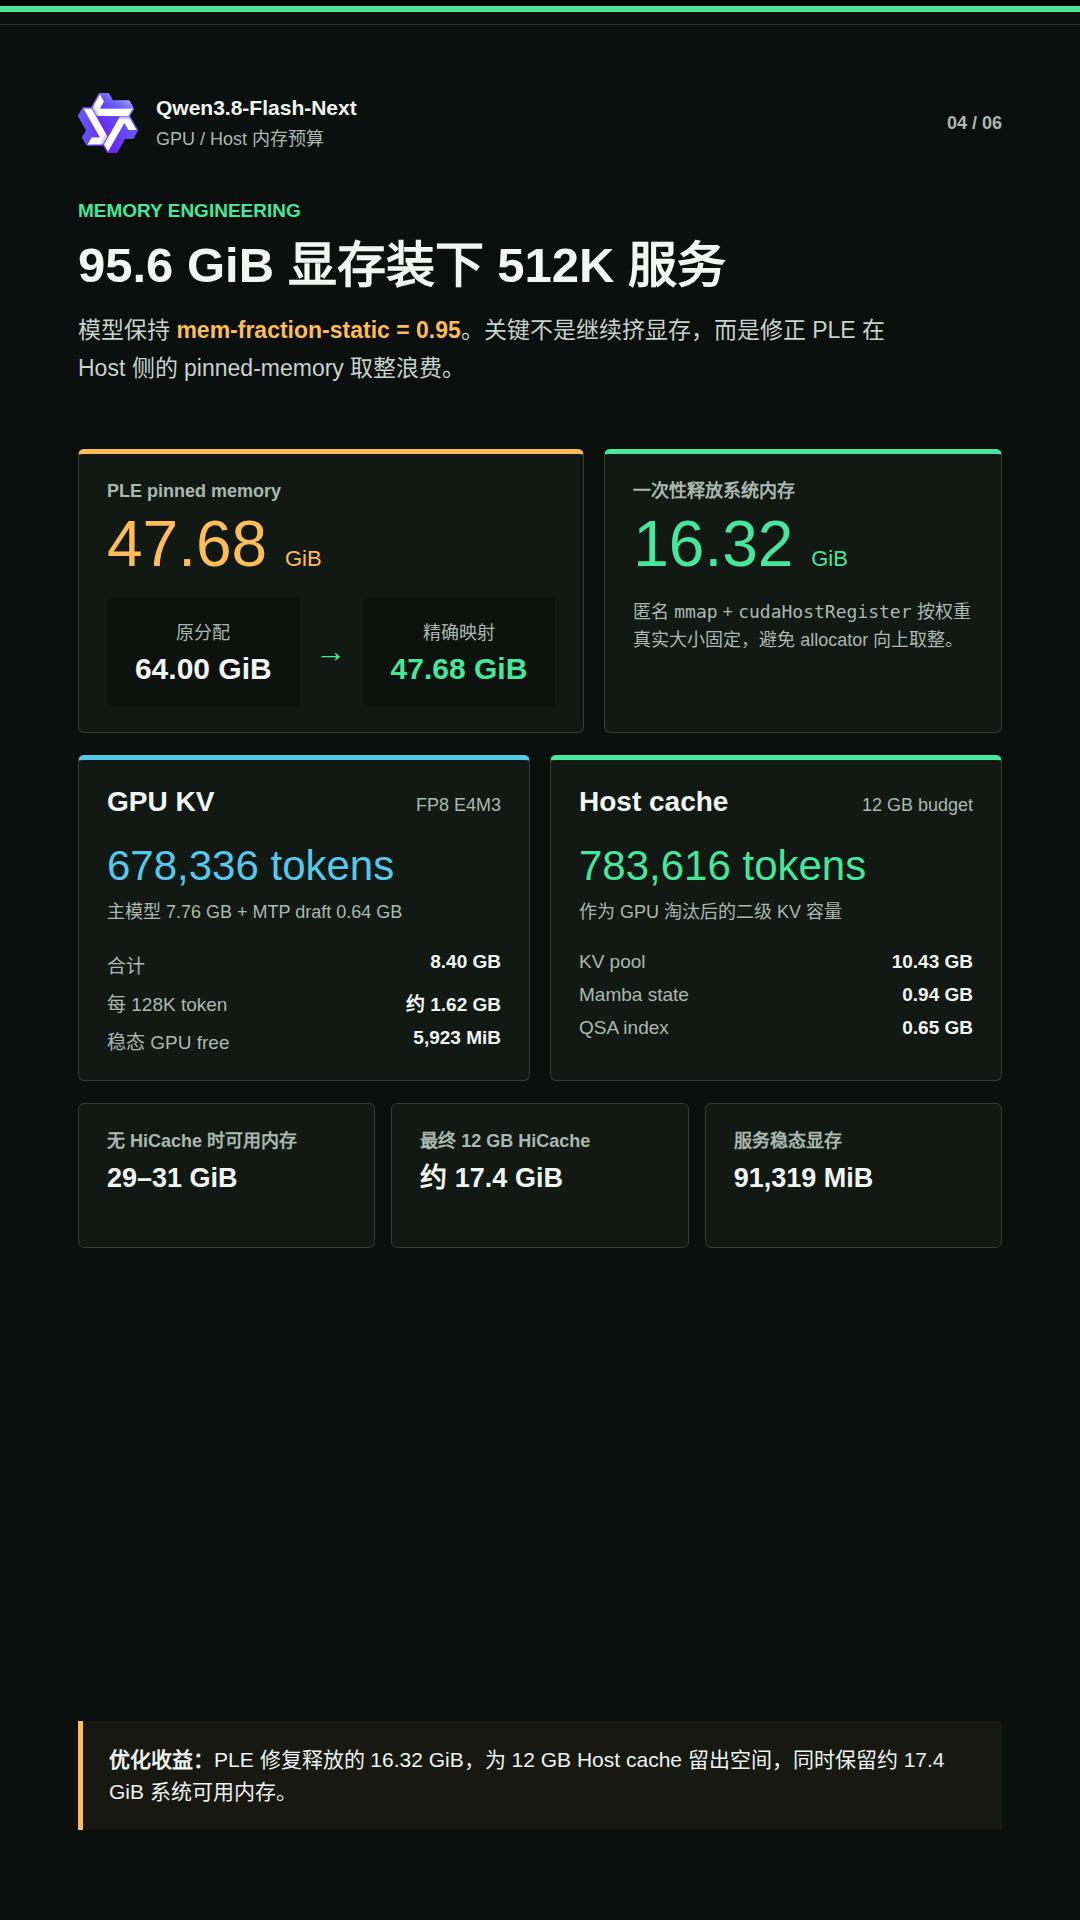
速度飞快,智力够用,十分好用,唯一的问题是占用了 60G 内存和 92G 显存,影响跑 ocr tts 和 asr 。
用了 12 年 V2EX 今天刚知道传一张图居然要收 20 币...
主楼 - JasonYip2026-09-03
好羡慕 现在这个卡好贵啊 token 自由了
- piapia2026-09-03
这卡年初才 6w 多吧
- kekxv2026-09-03
ocr 直接让 qwen 识别按照格式返回就好了啊
- SiWXie2026-09-03
羡慕,好奇能部署 glm 5.3 flash 吗?
- honjow2026-09-03
羡慕死了
- zzutmebwd2026-09-03
- zzutmebwd2026-09-03
- marvin5202026-09-03
羡慕 token 自由
- coefu2026-09-03
- zzutmebwd2026-09-03
- coefu2026-09-03
蟹,bro 。
老师傅给你们一个便宜方案,有点 hack 。
找个 双 pcie 主板,最好能四通道,2*v100 32G ,m.2 16G 傲腾 M10 ,64G mem 。
1w 以内的解决方案。
绝招:装 Linux ,把傲腾 m10 映射成 vram cache ,v100 支持 GPUDirect Storage ,可以走 pcie 直接 读傲腾,绕过 cpu/mem 搬运。pcie3.0x16 30GB/s ,傲腾 16GB 容量。因为 傲腾夸张的 4k 随机读写和 mem 一个性能,所以,可以把 kvcache ( Q8 量化,1M context ) offload 到 M10 。engram offload 到 mem ,64G vram 放模型权重。
挤一挤,也能用。😂
- coefu2026-09-03
@zzutmebwd 不是人人都买得起 pro6000 ,🦀,bro 。
- wises2026-09-03
- coefu2026-09-03
- coefu2026-09-03
- xiaomushen2026-09-03
- c0xt30a2026-09-03
OP 是怎么设置
partial_rotary_factor和factor到 512K ctx 的? - catazshadow2026-09-03
- coefu2026-09-03
@catazshadow 这只是 idea ,我没去实践过,理论上看起来能跑通。
- zzutmebwd2026-09-04
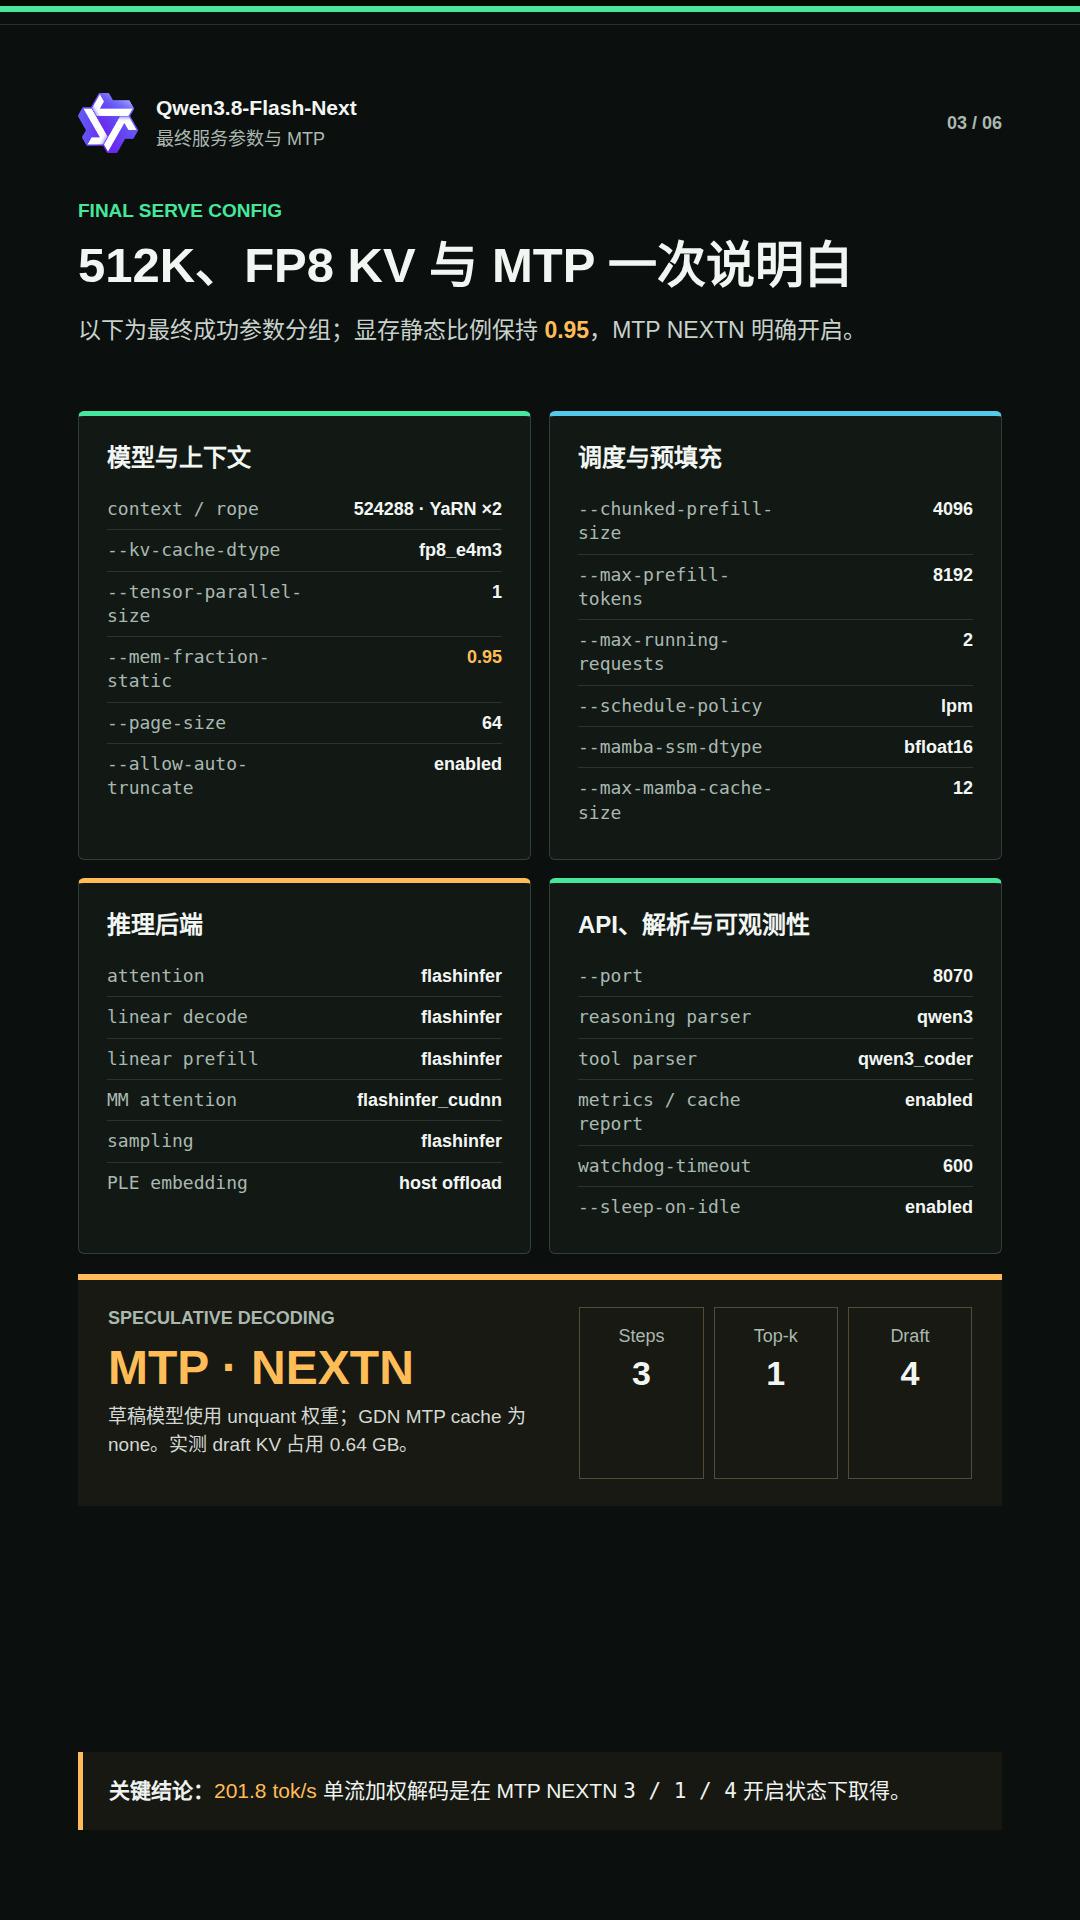
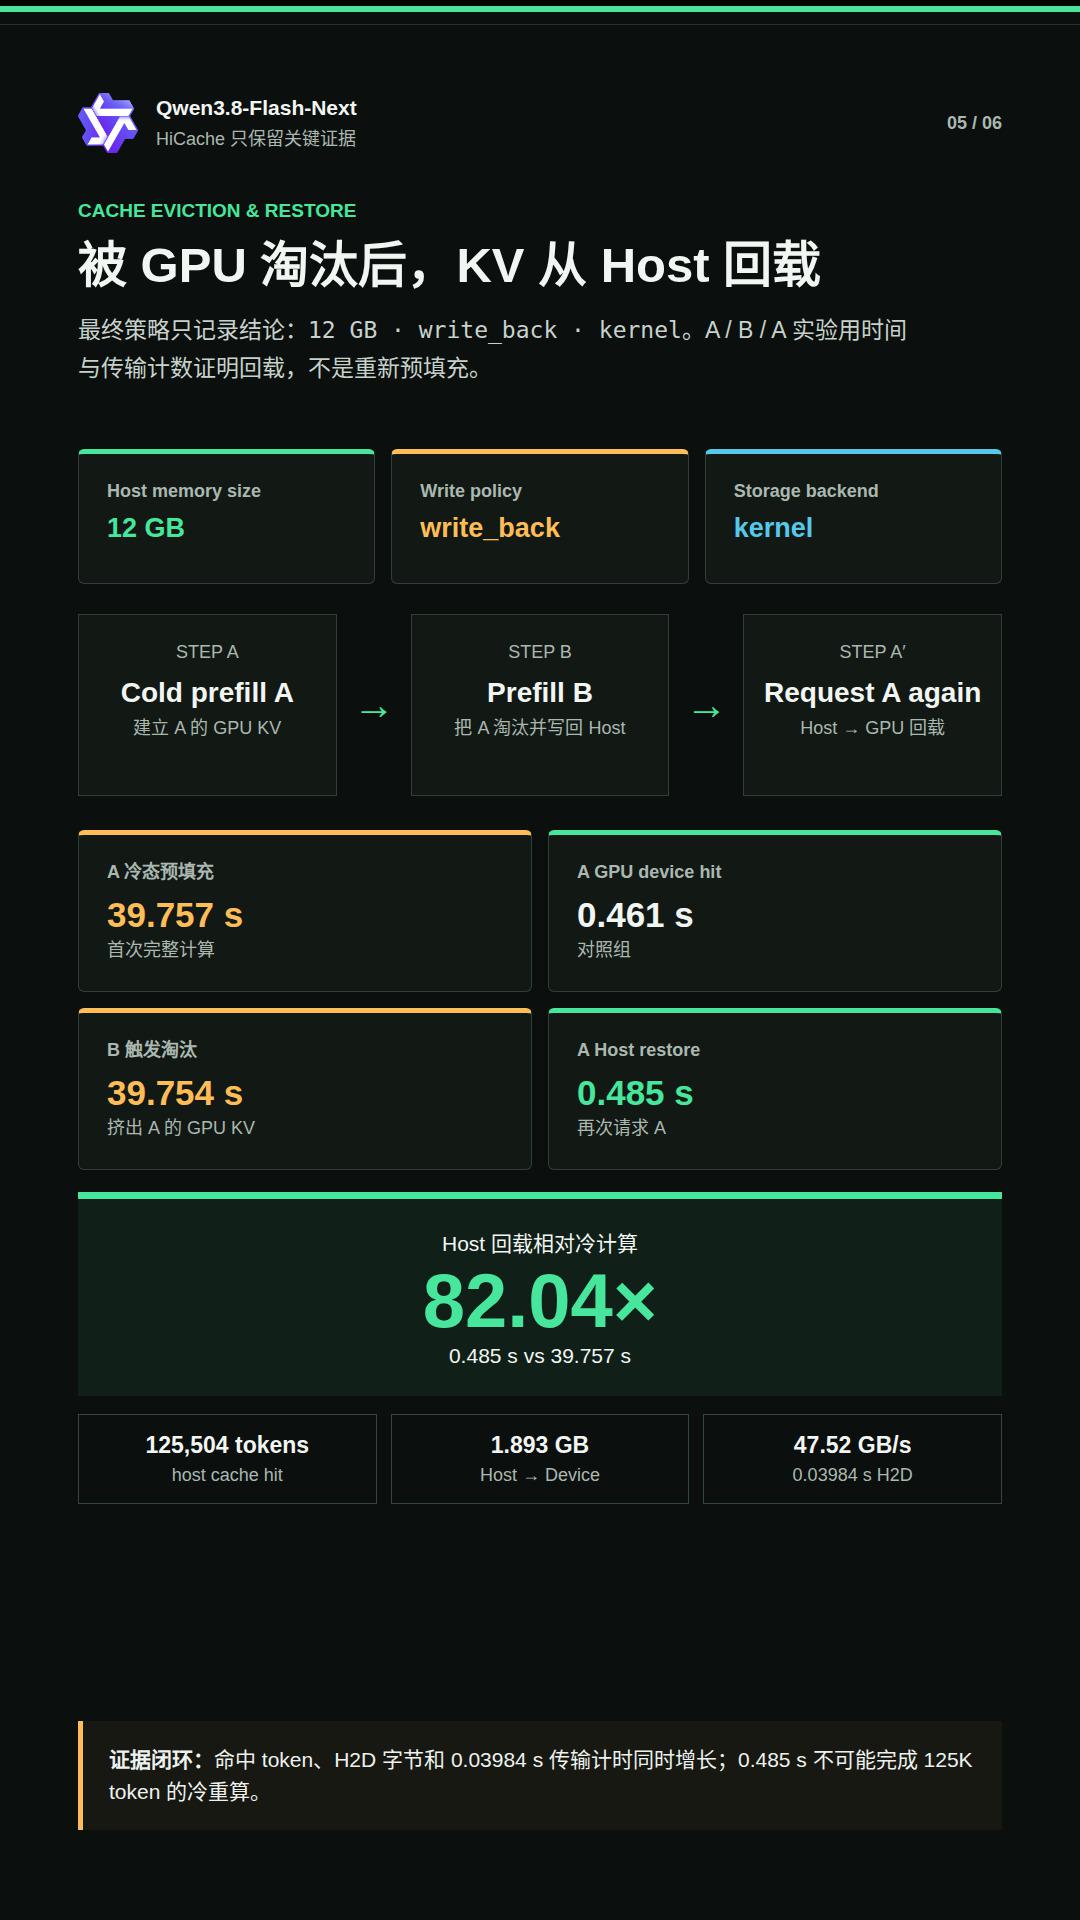
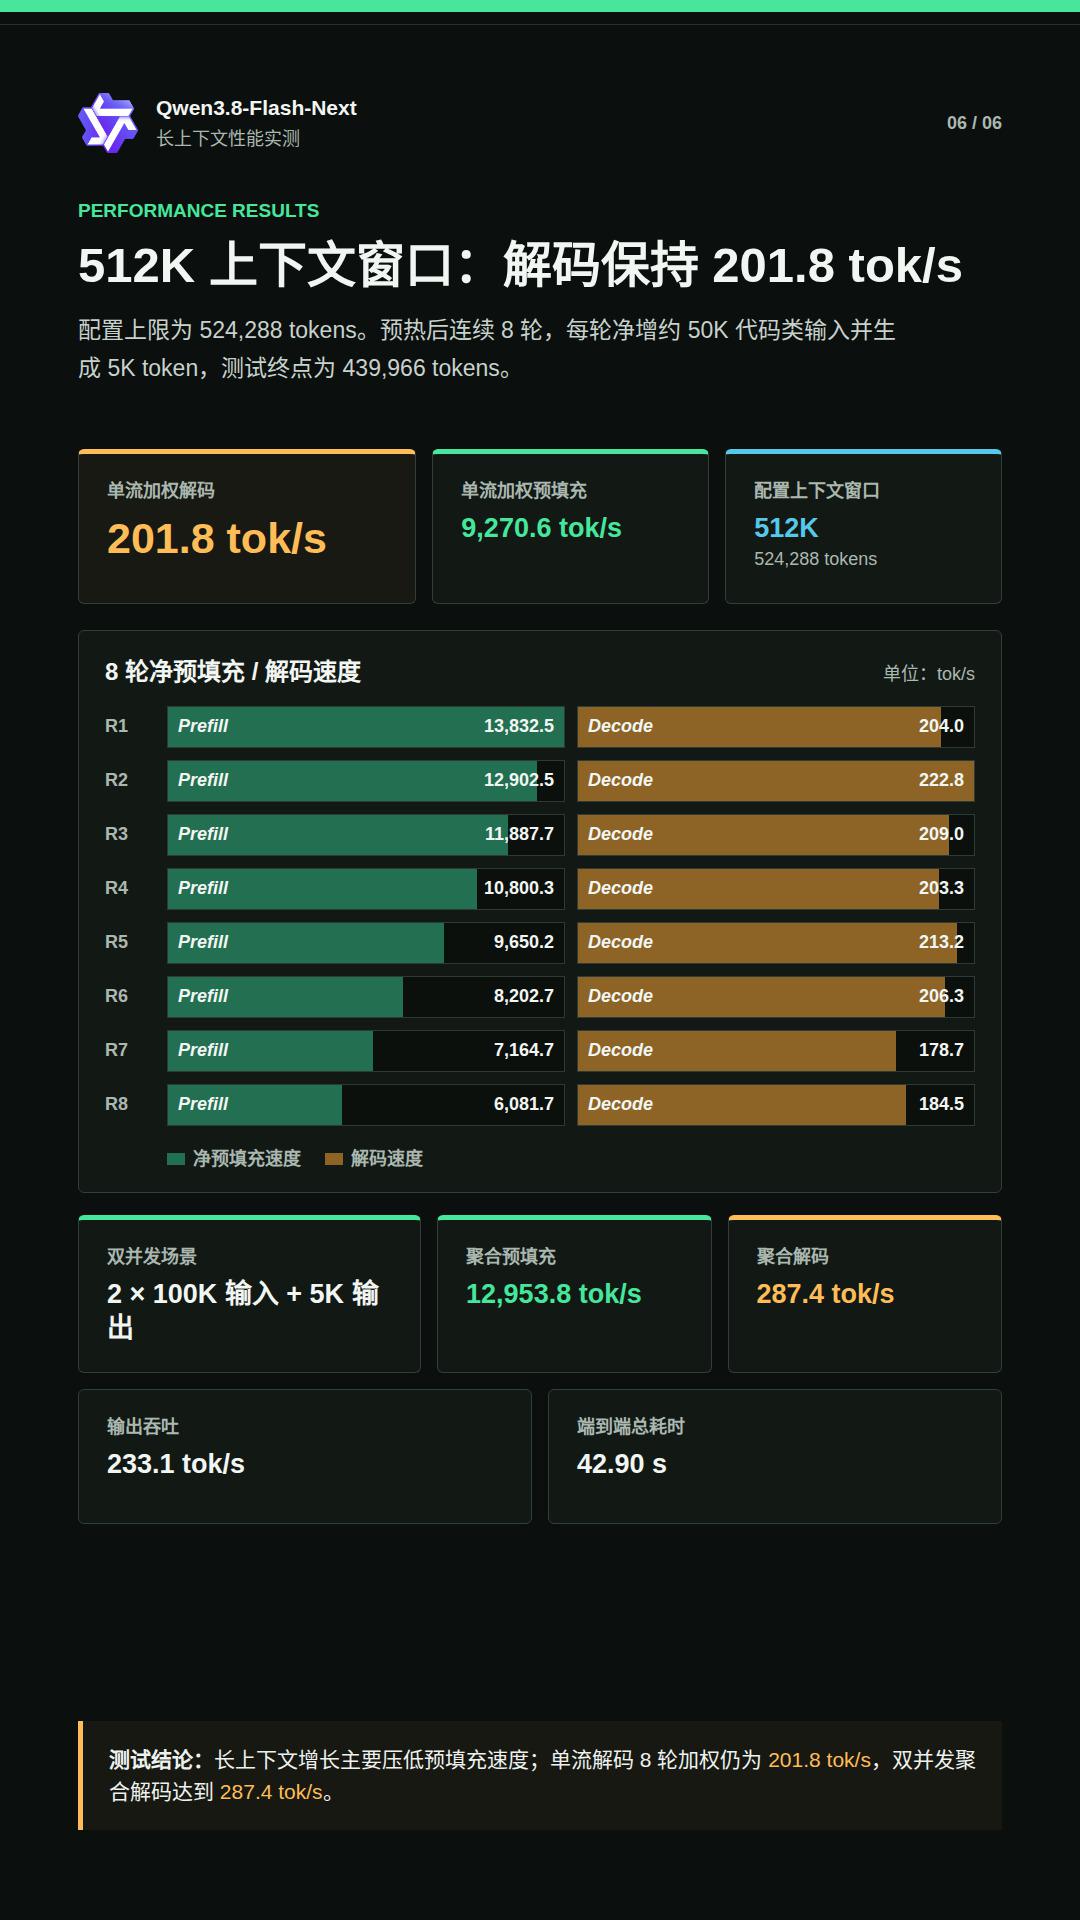
@c0xt30a 当前 long 模式( systemd 默认跑的 serve-flash-next.sh )是这样设置的:
通过 SGLang 的
--json-model-override-args覆盖到text_config.rope_parameters:```json
{"text_config":{"rope_parameters":{
"mrope_interleaved":true,
"mrope_section":[11,11,10],
"rope_type":"yarn",
"rope_theta":10000000,
"partial_rotary_factor":0.25,
"factor":2.0,
"original_max_position_embeddings":262144
}}}
``配合命令行--context-length 524288`。要点拆解:
-partial_rotary_factor=0.25是模型原生值(只有 25% 的 head dim 带 RoPE ,这个不是为扩长改的,只是随 override 一起显式声明,防止 SGLang 读不到 config 里的 rope 字段)
-factor=2.0是扩长手段:原生original_max_position_embeddings=262144( 256K ),YaRN ×2 → 524288 ( 512K )
-rope_theta=1e7、mrope_interleaved+mrope_section [11,11,10]保持不变,与原生配置一致
- 权重文件本身 config.json 里 rope 字段是空的( NVFP4 转换版没带),所以才需要 json-model-override-args 注入,两套脚本( serve-flash-next.sh / serve-flash-next-test.sh )里这段 override 相同
- fast 模式则不带这组 override ,直接用原生 256K注意 factor 不是自己拍脑袋设的缩放率——262144×2.0=524288 ,与
--context-length严格对应;两者不一致时 SGLang 会在 rope 外推区间外产生质量断崖。 - zzutmebwd2026-09-04
@coefu 我认为至少需要一张 4090 48G 或者 dgx spark 128G 才能收获一个可用的速度(prefill > 1000 decode > 40) ,再低就没意义了,长程 agent 任务的单流输入输出量巨大,任务总时长会拉长到不可用的程度。我认为在智力达到一定程度后,速度更为重要。昨天一个论文审计任务的会话数据供您参考:
会话编号:20260903_204118_09742f
统计时间:2026 年 9 月 3 日 20 时 41 分 21 秒至 21 时 10 分 05 秒,总持续时间 28 分 44 秒。
该会话共完成 94 次模型调用,全部与 SGLang 请求日志成功匹配。累计处理输入 5,755,742 tokens ,其中缓存命中 5,359,296 tokens ,实际新增预填充 396,446 tokens ,缓存命中率 93.11%。
净新增上下文的加权预填充速度为 11,357.44 tok/s 。单请求预填充速度中位数为 7,560.8 tok/s ,P10 至 P90 范围为 2,335.6 至 12,391.9 tok/s 。短增量请求受固定调度开销影响,因此单请求中位数低于按新增 token 加权后的总体速度。
Hermes 记录的总生成量为 156,358 tokens ,SGLang 记录为 156,487 tokens ,两者差异来自结束符等特殊 token 。加权单请求解码速度为 159.21 tok/s ,单请求解码速度中位数为 162.0 tok/s ,P10 至 P90 范围为 141.8 至 218.3 tok/s 。
SGLang 调度批次的单流解码速度中位数为 153.3 tok/s 。期间只有 3 个双并发批次,双并发聚合解码中位数为 248.1 tok/s ,不适合作为该会话的主要性能口径。
MTP 投机解码的接受长度中位数为 2.5 ,P10 至 P90 范围为 2.0 至 3.2 ,非结构性代码任务 MTP 命中率明显偏低。请求排队时间中位数为 2.09 毫秒,P90 为 3.82 毫秒,最大 15.03 毫秒,未出现明显排队拥塞。
- catazshadow2026-09-04
- coefu2026-09-04