- 🐟2026-08-04
 主楼
- pp2026-08-04
有没有地方, 可以免费试用一下的
- 初九猫2026-08-04
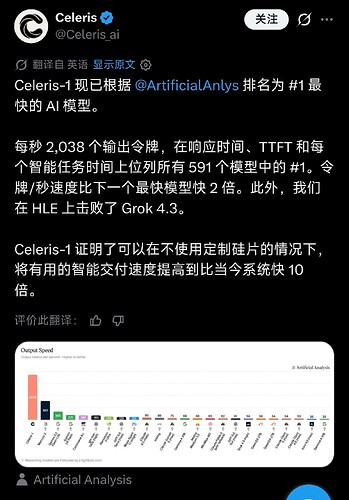
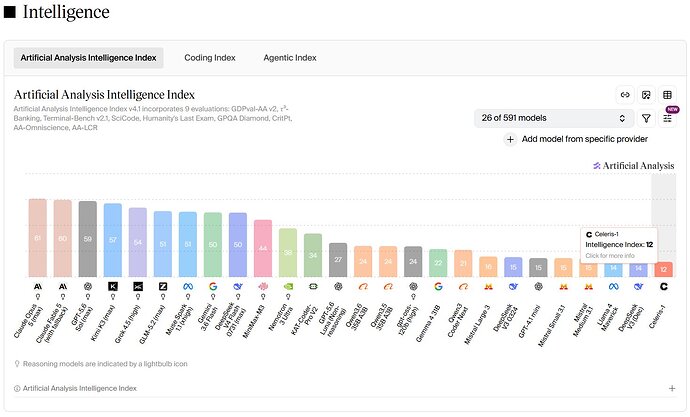
现在最快但也是最蠢(甚至还不如V3)的模型,我怀疑把v4FG制成硬件都比它强
- 🐟2026-08-04
- BOOSTMEISTER_2014_DH2026-08-04
- wazou_pau2026-08-04
这个第一是speed第一,感觉有点炒作,要看具体模型大小和其它准确度指标来判断吧
- 🐟2026-08-04
taalas 都没消息了说是……
- beautifulrem2026-08-04
又快又蠢的话,我去用扩散模型不得了?
- ningyuan2026-08-04
又快又蠢那不是纯拉屎嘛,真有人嫌屎太少了?
- CardKado2026-08-04
tps高还是很实用的,比如沉浸式翻译等场景不怎么要模型能力但是很吃速度。
OpenRouter上能看到同一个模型不同供应商的速度,定制硅片的供应商(如Cerebras或者Groq)的速度能到大几百tps,翻译大篇幅文本的时候基本能秒出。
我在这种场景下的主力还是gpt-oss-120b就是这个原因^-^
- 一个合格的复读机2026-08-04