- watermelon22026-08-12
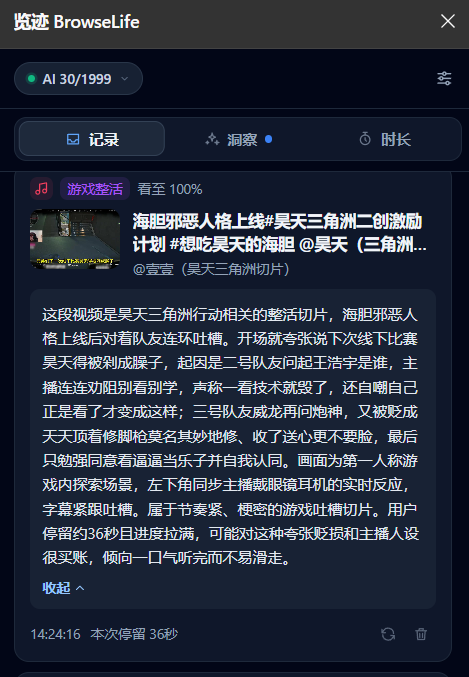
我们现在最多是提示词生成ai视频,但是有没有一种完整的、有内容有主旨的视频传给大模型,然后他们能识别出文字概括发生了什么呢?
这个方向有企业研究吗?是不是一片空白啊?如果真的实现了这种功能,能为我们带来什么?我实在想象不出对人类有什么帮助。
要是真能实现的话,佬们能不能猜一下大概会用什么技术路线实现的?
主楼 - 金陵雪2026-08-12
已经有了啊,马斯克之前还发过grok理解视频能力的推文
- Jimmyhuang2026-08-12
已經可以讀取視頻的AI了吧,感覺這也不是瓶頸,現在多模態AI很常見了
- watermelon22026-08-12
- hui4552026-08-12
视频本质上是多帧的图片组成,在技术层面就是识别多张连续图片,不是什么难事
- hwang2026-08-12
支持多模态的模型都有啊,怎么会是一片空白?
- bailing2582026-08-12
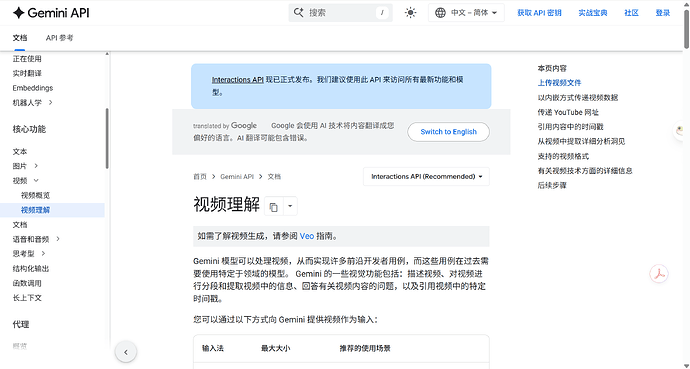
gemini和豆包现在都支持视频理解啊,本身就相当于是每秒抽帧ocr画面和字幕,再加上音轨asr,不是什么特别困难的技术
- watermelon22026-08-12
如果是十秒左右的视频,他们的识别是不是相当于每帧图像识别的文字拼接 ^-^
- woa2026-08-12
感觉这个技术上可行, 可能还是算力问题吧
- 白芸汐2026-08-12
还有音频的,视频本来就是视觉和听觉的组合,两个都抽出来也是能理解在干什么的
- sxjeru2026-08-12
每帧其实不太可能,成本太高,像 Gemini 默认是每秒提取一帧画面。
- 白芸汐2026-08-12
- Shigure_init2026-08-12
你用gemini试试,理解视频能力很强,唯一缺点就是长视频注意力问题
- He1102026-08-12
Gemini 、 Gemma 都可以吧
 Sirhexs2026-08-12
- gentingincubus2026-08-12
没有难度 毕竟视频也是一帧一帧的 关键还是算力 上下文 和费用吧。为什么都在搞直接生成视频而不是去剪辑一段已有的素材,光是读取都耗费很多算力,更别说去修改 改完不满意又要重复改,影视里面改几十次是很平常的事,那成本都爆炸了。
- zoffy2026-08-12
这玩意老早就有了吧。sd 生成视频那么夯,你猜如果反向理解会不会也很夯
- bigbigken2026-08-12
这不就是多模态吗?gemini还有qwen都有这种模型啊
- edmond_XU2026-08-12
已经有了,京东的开源大模型,JOYai
- Lemonade2026-08-12