- 777er2026-08-05
本帖使用社区开源推广,符合推广要求。我申明并遵循社区要求的以下内容:
- 我的帖子已经打上 开源推广 标签: 是
- 我的开源项目完整开源,无未开源部分: 是
- 我的开源项目已链接认可 LINUX DO 社区: 是
- 我帖子内的项目介绍,AI生成、润色内容部分已截图发出: 是
- 以上选择我承诺是永久有效的,接受社区和佬友监督: 是
以下为项目介绍正文内容,AI生成、润色内容已使用截图方式发出
https://github.com/wangwq7/cpa-glm-vision-bridge
之前花时间vibe了一个视觉模型桥接的cpa插件,能实现非视觉模型的识图效果。不用mcp,不用skill,直接在cpa里安装插件,配置好主模型和视觉模型,然后暴露一个模型名称给外部调用即可。
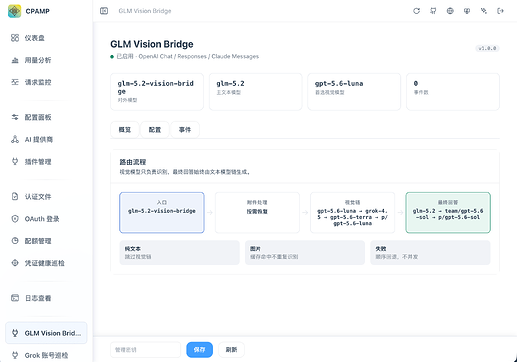
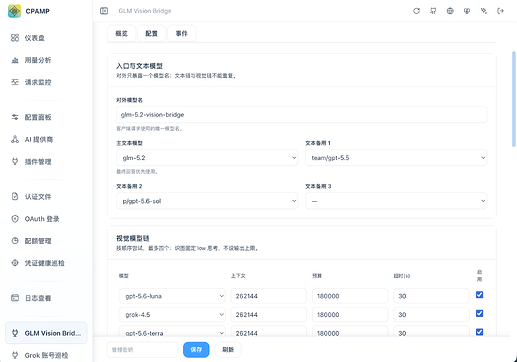
也支持请求记录查看,了解bridge的全过程
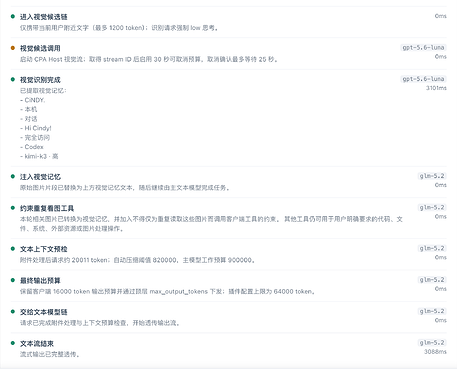
和 MCP、Skill 这种方式相比,它的识图由网关统一处理,不需要主模型判断什么时候调用工具,也不依赖客户端是否支持工具调用。配置好以后,基本不用管。
另外还支持多个视觉模型备用。一个模型失败了会自动换下一个;相同图片也可以直接走缓存,避免重复识别。
主楼 - huolian2026-08-05
这个插件是简单的仅判断是否需要识图,还是能够判断是否需要调用视觉能力,因为还有其他场景也会需要用到视觉能力
- 777er2026-08-05
- banshan2026-08-05
这个挺好,速度快,相当于代码就处理了
- amdyes2026-08-05
需要,发出来吧佬,最好可以直接在商店安装
- huolian2026-08-05
比如有时候模型需要视觉能力去处理除了图片之外的任务,比如去分析网页,设计网页的时候可能是需要视觉能力的,主要是我也在vibe一个让codex驱动opencode的东西,正好也在想办法解决当opencode中的deepseek需要视觉能力的时候,能否让codex去提供对应能力的问题
- 咸鱼大仙2026-08-05
佬可以的,我现在就是cpa套一层ccx做图片转述,但还是会遇到模型在codex里使用view_image工具然后把完整base64塞进上下文爆掉的问题,能解决么,最好能在图片转述完成后把图片路径给替换掉,避免模型自发去硬盘再看一次
- 777er2026-08-05
这个前几个版本我也遇到了,目前已经解决了。
- 咸鱼大仙2026-08-05
那期待发布,这样我就不用多套一层ccx了
- Anthony4552026-08-05
期待一下,支持佬,什么时候发布下、呀
- 777er2026-08-05
等等我吧 之前自己用写的太乱了 还有些小无关痛痒但是影响判断的小bug 修改好了就发
- 适才相戏耳2026-08-05
pi能用吗?pi插件能装吗?佬。
- 777er2026-08-05
可以的,这个 cpa 的插件,只要用 cpa 网关都可以
- 咸鱼大仙2026-08-06
佬,用上了,效果不错,不过最好能新增支持声明多个公共模型和改名,方便已有的客户端不用改配置直接切换。gpt luna实际上是dsv4f,sol是glm等,方便使用
- green2026-08-06
期待佬友发布,之前用 mcp 感觉好慢
- 777er2026-08-06
- wilsons2026-08-06
- rainoffallingstar2026-08-06
应该是直接识别附件里面有没有带图片吧
然后直接把消息流转给指定多模态模型?
ds → luna截胡-> ds
看起来是这个设计吗
可以做成模型名单
拉一堆需要移植视觉的模型名单
在CPA里面的识别改成
消息附件带图片+模型名字模糊命中?
- Lucifer_Morningstar2026-08-06
流程看了一遍,有几个问题想问下(不太熟悉所以有些问题比较小白也请原谅)
1、视觉模型候选依赖其它模型进行选定吗
2、我的理解就是在遇到图片的时候就让主llm选定能够支持图片的llm进行识别,中间如果过大有压缩,最后将副llm的结构给主llm,这样对吗
- 777er2026-08-06
好想法,这样就不用来回切换了。我回头让gpt改一下