- Dowad2026-08-13
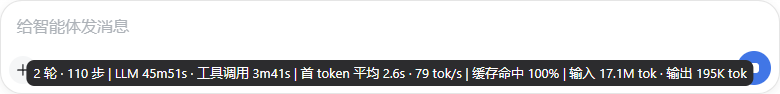
- 速度,在 dsh 中,速度竟然比 pi 中还快。在我这里 75 vs. 39 tok/s; 感觉有魔法优化,猜测类似 SSD truncate 加速那种
- “创造模式”用于创建 Preset, 创建 preset 是一等公民,比常规的 不同 systemprompt 的多agent 高很多。
- 先跑通 web / headless, 这可以让它很快速的接入到其他的基础设施中。比如我已经搭好的 open-code-review 流程,我可以把review编排那段从 alibaba/ocr 直接换成 dsh headless
综上,我踏马宣布 挽尊成功。
另外,第一个说“发错模型”的人是嘲讽 拉完了 的,怎么还真的有人以为是发错模型了?
主楼 - 无邪气2026-08-13
- BHznJNs2026-08-13
- 速度,在 dsh 中,速度竟然比 pi 中还快。在我这里 75 vs. 39 tok/s; 感觉有魔法优化,猜测类似 SSD truncate 加速那种
这不是扯淡吗,同样是调 API,换个 harness 还能影响接口速度?
- loujohn2026-08-13
有缓存吧,缓存高了输出应该会变快?
- 宇宙宙长2026-08-13
我也觉得,难不成还有啥功能,能检测用的是不是dsh,一看是dsh接口,给这个key路由到高速通道
- BHznJNs2026-08-13
也不是不行,不同的客户端有不同的 user agent,检测是自家的客户端提高速度,就是变相劣化其他用户的体验了呗?
- Dowad2026-08-13
- Dowad2026-08-13
第一个想到的也是这个。但这样做推不了上限,不可能用超多的算力表演算力不足。
- Dowad2026-08-13
你可以试一下我扯的这个‘淡’是不是,再回来一起扯
- 后皇嘉树2026-08-13
大概率是计算 tps 的方式不同
- 宇宙宙长2026-08-13
感觉这个如果真上的话,应该会当做高峰期的一个优先级,高峰期的时候,优先供给给自家,正常时期不做优化 感觉好像也行
- Dowad2026-08-13
有可能,虽然肉眼看快很多,但如果输出的重复内容是直接引用的之前的,就不会重新output一遍,就能在同样的output速度下造成吐的很快的现象。
- merenguesL2026-08-13
我用的pi+官网和opencode-go的d4f,轻轻松松100+tokens每秒啊?tps真的和harness没关系,只和provider有关系
- Dowad2026-08-13
我的flash也是100+啊,用dsh 140+