- GPLer-linuxdo2026-08-14
前言
截止目前为止,vLLM 官方版本都不支持在 30 系上运行 DeepSeek V4 系列(vllm-project/vllm/issues/40851)
关于 DeepSeek V4 Flash,站内已经有很多部署成功的案例了,DGX Spark、RTX Pro 6000、H800 等等,8 卡 A100 也有一篇四月份的,但是用的是 llama.cpp,看上去性能不太理想,只有 14 token/s 左右,属于玩具级别。
之前就注意到有一些第三方的 vLLM/SGLang 版本解决了 A100/A800 不能跑的问题,但不确定实际效果怎么样,正好手头有闲置的算力,因此进行了实验,本文为实验结果。
本人比较熟悉 vLLM,而且 vLLM 这个版本可以使用原版模型,不需要量化或者 gguf,因此就只测试了这个。
抛砖引玉,测试方法比较粗糙,欢迎大家交流指正。
测试环境
GPU: 4 x A800 80GB (sm_80)
Engine: lazymio/vllm-backport:v0.2.0-sm80 on Docker
Model: deepseek-ai/DeepSeek-V4-Flash-0731 (官方原版模型)
测试于 2026/08/11 进行,目前最新 vllm-backport 最新版本出到了 v0.5.0,出于 GPU 资源协调原因短期内不一定能测
速度测试
简单的速度测试脚本```
import json, time, urllib.requestdef bench(n=3, max_tokens=1000):
payload = {
"model": "deepseek-v4:flash-0731",
"messages": [{"role": "user", "content": "写一篇关于人工智能的短文"}],
"max_tokens": max_tokens,
"chat_template_kwargs": {"thinking": True, "reasoning_effort": "high"},
}
req = urllib.request.Request(
"http://localhost:8000/v1/chat/completions",
data=json.dumps(payload).encode(),
headers={"Content-Type": "application/json"},
)
for i in range(n):
t0 = time.time()
with urllib.request.urlopen(req, timeout=600) as r:
d = json.load(r)
dt = time.time() - t0
toks = d["usage"]["completion_tokens"]
print(f"req{i+1}: tokens={toks} time={dt:.2f}s tps={toks/dt:.1f}")bench()
基础参数```
--tensor-parallel-size 4
--max-model-len 393216
--gpu-memory-utilization 0.90
--enable-prefix-caching
--enable-prompt-tokens-details
--enable-expert-parallel
--kv-cache-dtype fp8_ds_mla
--reasoning-parser deepseek_v4
--tool-call-parser deepseek_v4
--enable-auto-tool-choice
```> 三次平均速度: 59.4 tps

开启 DSpark

额外参数```
--speculative-config '{"method":"dspark","num_speculative_tokens":5}'
--kv-cache-memory 17179869184
```不加 --kv-cache-memory 的话因为 dspark 空间没预留够会 OOM

> 三次平均速度: 82.8 tps (加速比例 1.39x)

添加 wtdcode/vllm-backport 仓库推荐参数1 (省显存?)

额外参数```
--compilation-config '{"cudagraph_mode":"PIECEWISE"}'
```> 三次平均速度: 30.0 tps (相较基础参数,输出速度接近砍半)

添加 wtdcode/vllm-backport 仓库推荐参数2 (稳输出?)

额外参数```
--hf-overrides '{"head_dtype": "float32"}'
```> 三次平均速度: 58.8 tps (相较基础参数,输出速度基本不变)

最终配置```
--tensor-parallel-size 4
--max-model-len 393216
--gpu-memory-utilization 0.90
--enable-prefix-caching
--enable-prompt-tokens-details
--enable-expert-parallel
--trust-remote-code
--kv-cache-dtype fp8_ds_mla
--reasoning-parser deepseek_v4
--tool-call-parser deepseek_v4
--enable-auto-tool-choice
--hf-overrides '{"head_dtype": "float32"}'
--speculative-config '{"method":"dspark","num_speculative_tokens":5}'
--kv-cache-memory=14872904807
```四卡每张显存占用约 78.40 GB

GPU KV cache size: 710,018 tokens

Maximum concurrency for 393,216 tokens per request: 1.81x

> 三次平均速度: 84.7 tps (加速比例 1.42x)

上下文试了下拉个 512k 没什么问题,拉 1M 会爆显存,推荐 8 卡尝试

并发测试

简单并发测试脚本```
"""并发能力测试:1/2/4/8/16 并发,每档 12 个请求,每个 max_tokens=256(无 thinking,贴近普通调用)"""
import json
import time
import urllib.request
from concurrent.futures import ThreadPoolExecutor

URL = "http://localhost:8000/v1/chat/completions"
PAYLOAD = {
    "model": "deepseek-v4:flash-0731",
    "messages": [{"role": "user", "content": "写一篇关于人工智能的短文,介绍它的发展历史"}],
    "max_tokens": 256,
}

def one_request(i):
    req = urllib.request.Request(
        URL,
        data=json.dumps(PAYLOAD).encode(),
        headers={"Content-Type": "application/json"},
    )
    t0 = time.time()
    with urllib.request.urlopen(req, timeout=600) as r:
        d = json.load(r)
    dt = time.time() - t0
    toks = d["usage"]["completion_tokens"]
    return dt, toks

def bench(concurrency, total_reqs):
    t0 = time.time()
    with ThreadPoolExecutor(max_workers=concurrency) as ex:
        results = list(ex.map(one_request, range(total_reqs)))
    wall = time.time() - t0
    lats = [r[0] for r in results]
    toks = sum(r[1] for r in results)
    tps = toks / wall
    p50 = sorted(lats)[len(lats) // 2]
    p95 = sorted(lats)[int(len(lats) * 0.95) - 1]
    print(
        f"并发={concurrency:2d}  请求={total_reqs}  总耗时={wall:6.2f}s  "
        f"总tokens={toks}  吞吐={tps:6.1f} tps  "
        f"延迟 p50={p50*1000:6.0f}ms p95={p95*1000:6.0f}ms max={max(lats)*1000:6.0f}ms"
    )
    return tps

print("=== DeepSeek-V4-Flash 并发测试(每请求 max_tokens=256)===")
for c in [1, 2, 4, 8, 16]:
    bench(c, 12)
print("=== 完成 ===")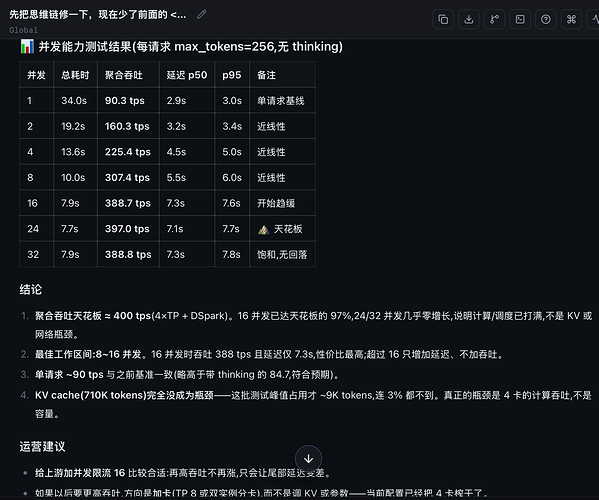
并发极限差不多就 400token/s,16 线程,每个用户就 25 token/s 了,30 系还是老了
鹈鹕测试
提示词```
创建一个HTML,内容是SVG绘制一个鹈鹕骑自行车的2D动画。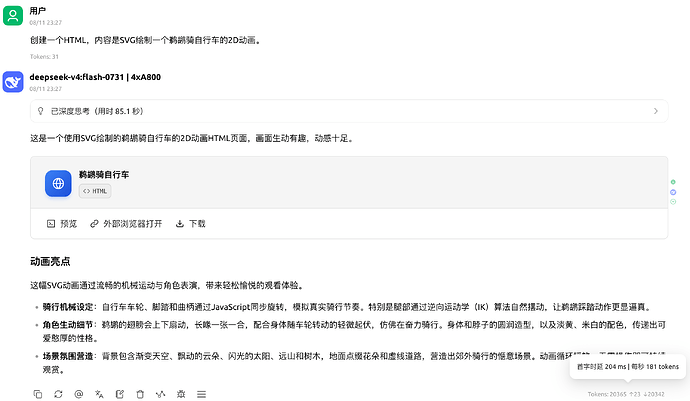 Cherry Studio 能测到 180 token/s,3倍提升,DSpark 恐怖如斯 输出结果 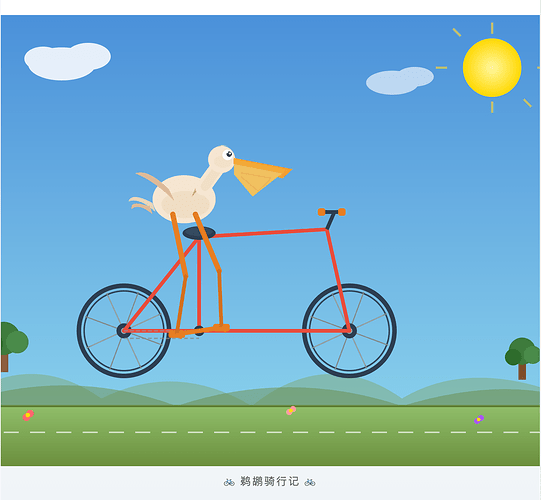 结论 4 卡 A800 跑 DeepSeek V4 Flash 0731,上下文能开到 512k,单线程使用的话,不开 DSpark 大概 60 token/s,开启后 120 token/s ~ 180 token/s,非常可用。主楼 - sunfly2026-08-14
token 自由,马上内网穿透哈哈
- 我心永恒2026-08-14
看下速度比较慢,多开几个 agent 就不能用了,完全不如在线 api
- Tsu1m2026-08-14
这个样子部署一台实现token自由得多少个W啊?
- GPLer-linuxdo2026-08-14
单线程还好,小优 API,多线程首字延迟太大了,基本只能单人单 Agent 用用,4 卡 16 并发基本上速度就到顶了
- whatfk2026-08-14
我在云上部署过,那个我不知道你这个有没有口水,但是我部署的那个质谱5.2,那个口水太多,能说个一整天一整夜。
- 我心永恒2026-08-14
实际开发肯定是要多 agent 的,所以这个速度完全不能用
- GPLer-linuxdo2026-08-14
直接用的原版权重,理论上回答质量是一样的,不过就鹈鹕而言感觉差了点
- GPLer-linuxdo2026-08-14
主要还是提供一种思路,考虑到 DeepSeek API 波动和涨价,也许有人需要呢,也算是淘汰下来的设备再利用吧
没有太大的商用价值应该就不用担心 A100/A800 涨价了,后面说不定有大船靠岸,个人玩玩也挺好的,这个模型能力算很强的了
- GPLer-linuxdo2026-08-14
价格上目前还是不如 2xDGX Spark 划算的,如果手头没有闲置的 A100/A800 不推荐专门去购买,另外当然都远不如 API 便宜,哪怕是涨价后。 ^-^
- JeremyGE2026-08-14
学习了,4卡A800竟然能开400K上下文,不过非官方实现担心精度问题
- leonvxe2026-08-14
算算百万token的生产成本是多少钱 ^-^
- GPLer-linuxdo2026-08-14
AutoDL 上租用 A800¥5.24 /时/张,4 卡 24 小时需要 ¥503.04
单线程按 120token/s 算,一天能输出 10368000 token (1千万 token)
按照目前的 DeepSeek V4 Flash 0731 定价(0.02/1/2),只算输出大概相当于 ¥20 (比 API 贵了 25x)
按照涨价后的 DeepSeek V4 Flash 0731 空闲定价(0.05/1.5/4.5),只算输出大概相当于 ¥45 (比 API 贵了 11x)
按照涨价后的 DeepSeek V4 Flash 0731 高峰定价(0.10/3.0/9),只算输出大概相当于 ¥90 (比 API 贵了 5.5x)
多线程按 400token/s 算,一天能输出 34560000 token (3.5千万 token)
按照目前的 DeepSeek V4 Flash 0731 定价(0.02/1/2),只算输出大概相当于 ¥70 (贵了 7x)
按照涨价后的 DeepSeek V4 Flash 0731 空闲定价(0.05/1.5/4.5),只算输出大概相当于 ¥157 (比 API 贵了 3x)
按照涨价后的 DeepSeek V4 Flash 0731 高峰定价(0.10/3.0/9),只算输出大概相当于 ¥314 (比 API 贵了 1.6x)
纯手算,可能出错(