不懂就问:缓存命中是什么意思?
3314
- 一只不会飞的猪2026-08-14
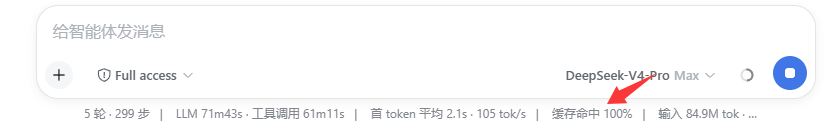
今天在玩这个harness和v4pro,但是不太懂缓存命中是什么意思?是不是对于重复或高度相似的提问,系统会调用缓存的既有结论进行响应?
有佬给个通俗的理解吗?
主楼 - 孤寂2026-08-14
- Murphyming2026-08-14
可以理解为AI 发现“这部分内容我刚读过”,不用重新读,直接从上次读到这里的状态继续往后计算。
- 一只不会飞的猪2026-08-14
意思是agent让模型有了更强的对话接续能力吗
- neteroster2026-08-14
这里的缓存,严格来说是 KV Cache
一般 LLM 的生成 流程:
Prefill(也就是计算所有输入的注意力参数) → Decode (生成输出内容)
其中 Prefill 阶段已经计算的内容,在多次请求之间可以被重复使用(若有相同前缀),无需重新计算,也就是所谓缓存
- 一只不会飞的猪2026-08-14
明白了 那百分之100 这个百分比又怎么理解
- MorriganAensland2026-08-14
- neteroster2026-08-14
一般来说多轮对话的缓存形态是这样的
下面以被【】包裹的部分表示已经缓存的部分
第一轮:用户:AAAA 模型输出:BBBB
第二轮:【用户:AAAA;模型输出:BBBB】 用户/工具结果:CCCC
第三轮:【用户:AAAA;模型输出:BBBB;用户/工具结果:CCCC】 用户/工具结果:DDDD
你可以看到随着轮次的增长,被缓存的内容的占比越来越高,如果服务端实现得当,在某些场景下可以接近>99.5% 的缓存率,四舍五入后显示为 100%
- weispicy2026-08-14
(帖子已被作者删除)
- 一只不会飞的猪2026-08-14
OKOK 很清楚了!谢谢佬 我是不是可以这样认为:缓存命中是Agent赋予模型的能力,命中率越高,缓存利用率越高,从而越省token~
- neteroster2026-08-14
严格说并不算是 Agent 赋予模型的能力:无论是不是 Agent,只要你的多次输入里,输入的开始部分是相同的,服务端就可以使用缓存,即便是普通的对话,也可以这样进行
缓存率也不仅取决于 Agent(实际上Agent Harness的影响并不很大,只要不乱折腾),服务端的影响其实更大:KV 缓存体积是很大的(通常几GB-几百GB),存储在服务器的GPU显存里,如果因为调度等原因请求没有命中上一次的服务器/节点,传输缓存的成本会高于直接在新节点重新计算prefill过程,此时就会导致缓存未命中
- zzGreg_周周·格雷哥2026-08-14
好像我听某些佬友说,chat/completion 的缓存比较低,responses ,messages 格式的缓存比较高,是这样吗?不懂原理
- neteroster2026-08-14
因为 chat/completion 会丢弃回传的思考项,导致前缀一致的部分更少,降低缓存率
- Megasoft2026-08-14
其实 deepseek 文档有解释,

api-docs.deepseek.com
上下文硬盘缓存 | DeepSeek API Docs
DeepSeek API 上下文硬盘缓存技术对所有用户默认开启,用户无需修改代码即可享用。
- Simber2026-08-14
简单的来说就是,你说的话,他都会分成一段一段的去转换成一个坐标系里面的位置。如果存储下来,之后的对话中就能很快定位之前的会话的相关位置从而省去计算,节约算力。也就是命中缓存,价格更便宜。
当然还有很多细节,但大致是这个意思