- hallay2026-08-15
rt,本地日常使用,能写代码更好,不过这个显存应该难度很大,每天跑些新闻收集应该还可以
主楼 - wublub2026-08-15
- vkrain2026-08-15
- sman2026-08-15
也就跑9B的了吧,再大够呛了,9B的开128K上下文?256估计开不到
- Gustaf2026-08-15
语言生成模型没啥能用的,我5080 16G,48G内存,把qwen3.6和gemma4各种量化都试过了,没眼看.唯一有用的就是部署向量模型给知识库用和hy-mt2的本地翻译
- Jvs2026-08-15
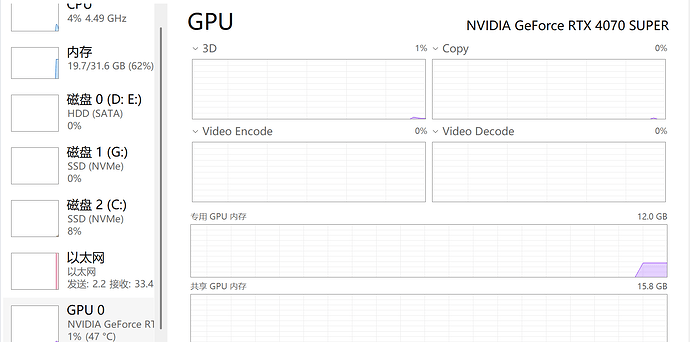
让ai帮我装了一些,基本都试过,我感觉完全没啥可用的,还不如用一些免费的小模型都比自己部署舒服,也可能是我还没上道,有的是占用内存的,基本上都满了,就做不了别的事情,有的放显存的,实际上下文和速度还有效果其实都一般,不如opencode free
ps:我也是个外行,纯玩的
- Atoz_032026-08-15
前面几个说的 27B 不太可能放得下,12G 先别想着玩了,可以玩玩 sd 生图,8B 或者更小不推荐
 GGbig2026-08-15
qwen的35B可以试试,27B不用试,跑不了。
- V_Arrow2026-08-15
只能用35B-A3B这种MoE模型了,稠密模型跑起来也很慢。我个人也是12G+32G的组合,尝试过用Qwen 3.6 35B A3B Q4_K_M,配合LM Studio的GPU卸载等设置勉强跑起来了,速度大概50-70 Token/s,但是显存和内存使用量非常极限,经常用着用着就OOM了
- wzlin2026-08-15
正在用 3060 显存 12G 内存 32G 跑 Qwen3.8-27B-Q4_K_M,实测 5 token/s ^-^
- Vegetable2026-08-15
聊天可以,coding就别想了哈哈哈哈,我今天用opencode+5080(16GB)+64GB来试了试qwen3.8 27B,非常慢(只有0.5-0.3tokens/s),根本不具备任何工程上的使用意义 ^-^
- hallay2026-08-15
我去 这么慢的吗 那还玩个der 老实充值了
- hopewilling2026-08-15
qwen最小的模型,好像是9B吧。反正你这个配置我觉得本地部署比较够呛。