- 犀利的毛毛虫2026-08-16
本帖使用社区开源推广,符合推广要求。我申明并遵循社区要求的以下内容:
- 我的帖子已经打上 开源推广 标签: 是
- 我的开源项目完整开源,无未开源部分: 是
- 我的开源项目已链接认可 LINUX DO 社区: 是
- 我帖子内的项目介绍,AI生成、润色内容部分已截图发出: 是
- 以上选择我承诺是永久有效的,接受社区和佬友监督: 是
以下为项目介绍正文内容,AI生成、润色内容已使用截图方式发出
项目地址
github.com
GitHub - bestxiangest/pi-vision-bridge: Pi Vision Bridge 是一个面向 Pi Agent 的视觉桥接插件。它让...
Pi Vision Bridge 是一个面向 Pi Agent 的视觉桥接插件。它让 DeepSeek 等纯文本模型能够根据当前任务主动调用独立的视觉模型,从截图、照片、图表和文档中获取结构化证据,再由主模型完成分析、编码和决策。
项目目前基于 Pi
0.83.0开发和验证。欢迎佬友试用、提 Issue 或一起完善。最近做了一个 Pi Agent 的视觉桥接插件 Pi Vision Bridge,主要用途是为 DeepSeek 等纯文本模型接入独立视觉模型,让它们能够理解截图、照片、图表和文档,并继续完成分析、编码或决策任务。
工作流程
收到图片后,纯文本主模型会先理解当前任务,再带着具体目标调用视觉模型。视觉模型返回结构化证据,主模型根据这些证据继续回答或修改代码,而不是只得到一段泛泛的图片描述。
目前支持:
- 直接粘贴、拖拽或输入本地图片路径。
- 自动拦截纯文本模型对图片使用内置
read去阅读图片的情况,并转入视觉分析。- OCR、UI 逆向、尺寸测量、图表分析、文档分析和报错截图识别。
- 图片局部追问,以及参考图与实现截图对比。
- 并发请求、缓存、失败重试、备用视觉模型和本地审计日志。
- OpenAI 兼容视觉接口,可自行配置 Base URL、API Key 和模型 ID。
实际运行截图
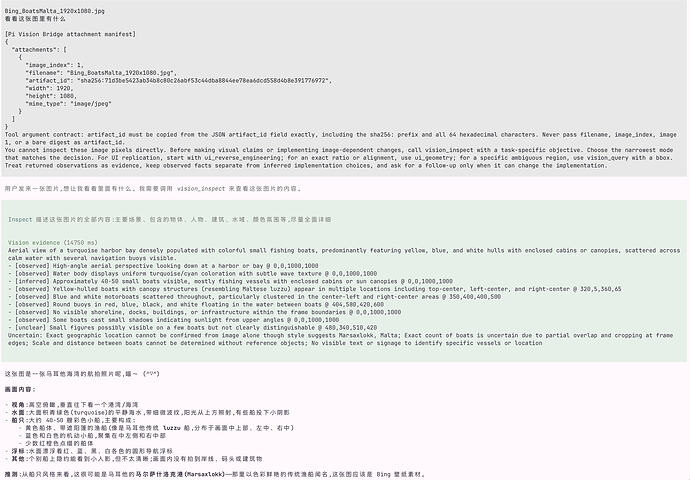
直接粘贴图片识别
图片进入会话后,插件会生成 Artifact,主模型根据用户问题调用
vision_inspect,再使用视觉证据回答。
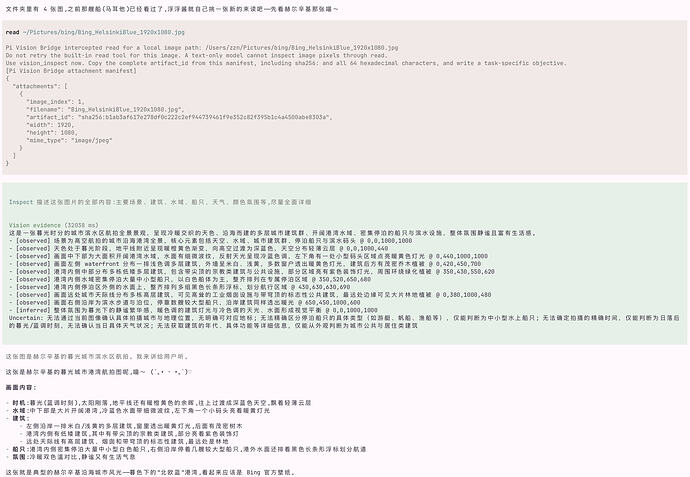
自动拦截
read工具纯文本模型使用内置
read读取图片时,插件会自动拦截,并引导模型改用视觉工具完成识图。这里让模型自行去探索图片文件夹中的任意一张图片,使用read工具: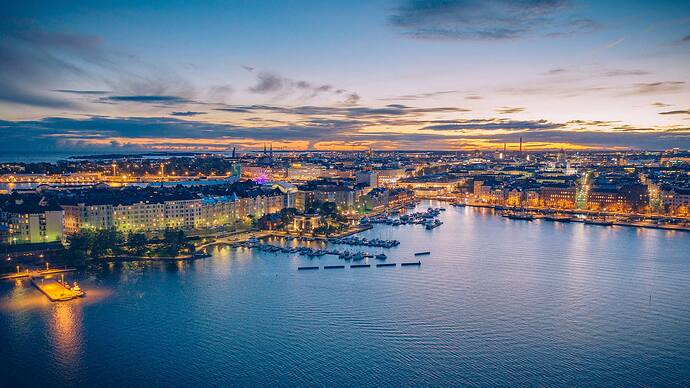
安装```
pi install git:github.com/bestxiangest/pi-vision-bridge
``安装后在 Pi TUI 中执行:``
/vision-settings
``配置视觉服务地址、API Key、模型 ID 和需要启用桥接的主模型,然后执行/vision-test` 测试连接即可。具体细节可见github页面,识图只是最基础应用,还包含克隆网站、修前端页面细节等功能:
视觉工具
工具 |
用途 |vision_inspect|
对一张图片执行首次任务化分析 |vision_query|
对整张图片或指定区域提出聚焦问题;区域坐标使用0..1000归一化边界框 |vision_compare|
比较目标图与当前实现截图,返回按优先级排列的视觉差异 |主楼 - ltzh35302026-08-16
天天想着给Deepseek装一个视觉模型 晚点看看佬这个方便不 谢谢开源