- 李欣穎2026-08-17
huggingface.co
Qwen/Qwen3.8-27B-FP8 · Hugging Face
We’re on a journey to advance and democratize artificial intelligence through open source and open science.
早上冲浪,不知道在那看到这个模型发布,我去看了下简介,完全可以本地部署,且还有很多去审查版本,达到能用的级别,这不比到处掺水的中转站好用吗?为什么讨论热度这么低。 ^-^
主楼 - 盖里2026-08-17
这热度还低?twitter 都吹疯了
- ljhhh01072026-08-17
27Bdense对于消费级显卡还是太勉强了,NVFP4和FP8的差距又比FP8和BF16的差距要大,我自己在H100 PCIe上跑的Qwen3.8-27B-FP8投机解码后有150tok/s,TP=2有270tok/s,这个模型还是非常非常非常强的,我觉得绝对有opus4.6的水平
我学姐的一篇隐私计算的工作直接被Qwen大人一脚踹飞了,本地小模型F1 Score甚至比云端还高
- mi_tu2026-08-17
这热度比上次gemma还大了,隔壁全在发,l站本来就没多少自部署的
- illusion39892026-08-17
家用显卡基本没法跑。q4我记得是17g来着,你开多上下文和缓存基本都要20+了,长程任务更是。5090最大也就24g,我昨天用5080跑了下,速度基本没眼看。显存太小了。
- 辰夕2026-08-17
x上确实说的很多,但是千问,可能狼来了的故事听多了吧,毕竟跑分没输过
- 微笑和鲜花2026-08-17
根本不低,低也是国内讨论度低了.
- 已老实2026-08-17
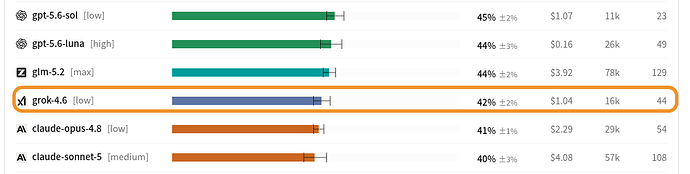
有没有大佬有性能价格图?这个模型是哪个水平的?看到不少次了,一次性能图都没见到过。。
- Sokeu2026-08-17
- vfx2026-08-17
显存要大于20G, 我两张3060 12G就能跑了, 但是需要家用主板支持双显卡才行.华硕那种才支持.
- 李欣穎2026-08-17
性能图
huggingface.co
Benchmark Results - Qwen/Qwen3.8-27B-FP8 · Hugging Face
This repository contains FP8-quantized model weights and configuration files for the post-trained model in the Hugging Face Transformers format. | We’re on a journey to advance and democratize artificial intelligence through open source and open...
自己部署就算电费和折旧
- 知我-linuxdo2026-08-17
跑分没输过,实际效果不好评价。之前吹的happy horse也没声音了
- IkedaTeresa2026-08-17
自己周末尝试部署了下bf16, 确实蛮强, 在现有的小模型上是鹤立鸡群.
- Sokeu2026-08-17
- 李欣穎2026-08-17
佬,如果整个Q4 的 16G 消费卡也是可以摸一下不
- 天天开心2026-08-17
因为一直在偷偷自己用,这么好的东西 ^-^
- 天天开心2026-08-17
其实没什么不好评价的,没用过的当然不能评价,我作为正在用的就只能说非常强
- vfx2026-08-17
一张卡应该是不太行, 上下文和并发都需要显存,你换个华硕主板,再插一张12G游戏卡, 一共16G+12G, 就没问题了.
- deepcake2026-08-17
人均4090/5090吗?而且Opus4.6在现在的眼光来看也不算强吧。
- 某人2026-08-17