- SDFshang2026-08-18
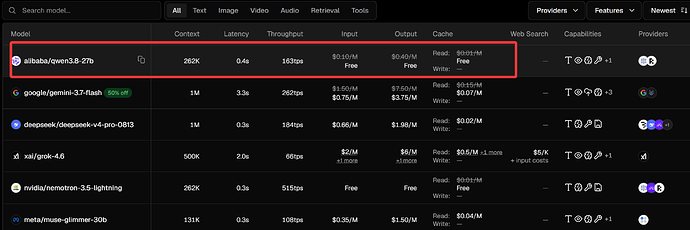
现在ds和opencode贵的要死,前几天千问出的27B稠密小模型,不仅性能和dsv4f掰手腕,而且还有多模态,小模型大能量,如果厂家部署这个模型做token plan感觉性价比会很高?唯一的问题是稠密模型的速度太慢了,不知道佬们怎么看?
主楼 - sis55952026-08-18
问题是显卡也早涨价了啊,半年前到现在涨了一倍也有了
- SDFshang2026-08-18
我是说第三方的平台不是个人,他们部署以后卖token,不知道比ds4f0731便宜否
- MapLine2026-08-18
自己部署的话, 抛开设备这种绕不开的投资外, 电费也顶不住的, 公司里算了算, 自己部署如果不成规模没法给所有人用, 成规模投入投不起, 个人自己部署烧的公司电费(工业电)不如买token, 现在死局了…
- nanzhiwei2026-08-18
你有没有搞错,qwen3.8 27B的推理成本是比deepseek 贵的,无论是 激活参数还是kvcache
- SDFshang2026-08-18
我知道他是dense架构,但我确实不明白这会导致成本提升多少,我理解的是目前瓶颈是存储,ds4 200b的参数比27b翻这么多,难道用27b真不划算吗?望佬简单讲讲
- Mozi2026-08-18
但是 DeepSeek 占用的显存不还是那么多吗?你那个参数量数字都在这了
- CodeEmpty2026-08-18
运行起来的时候,激活参数是不一样的,qwen的反而激活参数多
- AfricChang2026-08-18
- nanzhiwei2026-08-18
按照qwen的叫法,deepseek v4 flash 应该叫做deepseek v4 284B-A13B。
一个是13B一个是27B,这就是2倍多的差距,然后还有kvcache在长上下文上的开销,deepseek也是开销更小