- CorrectRoad2026-08-18
本帖使用社区开源推广,符合推广要求。我申明并遵循社区要求的以下内容:
- 我的帖子已经打上 开源推广 标签: 是
- 我的开源项目完整开源,无未开源部分: 是
- 我的开源项目已链接认可 LINUX DO 社区: 是
- 我帖子内的项目介绍,AI生成、润色内容部分已截图发出: 是
- 以上选择我承诺是永久有效的,接受社区和佬友监督: 是
以下为项目介绍正文内容,AI生成、润色内容已使用截图方式发出
开源地址
github.com
GitHub - NiceEval/NiceEval: build eval for your agent in 10 mins
build eval for your agent in 10 mins
官网

NiceEval
NiceEval: Agent-Native Evaluation Framework
NiceEval is a framework-agnostic agent eval tool, giving you a complete closed loop for building evals for your agents or coding agents.
评估驱动开发
做一个 Agent 最折磨人的往往不是把 Agent 做出来,而是怎么调优改进项目。
如Eval驱动开发所说,我们先通过用户故事构建关键路径上的评估,再源源不断的从真实的生产环境中导入用户是怎么使用 Agent 的各种 happy path 和 bad case。
构建这么一个 AI 原生飞轮,从用户反馈中不断的改进自己的 Agent 产品。听起来很棒但是在真的做起来的时候各种工具都不太好用。以 PromptFoo 和 Langfuse 为例,这种以 Dataset 为主范式与真实的用户场景相差很远。
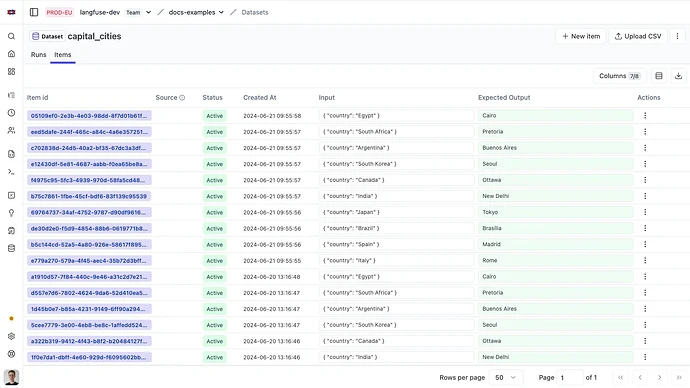
没有哪个真实用户会一口气在一个 prompt 中写完自己需求,然后一次性发给 Agent,不再补充。而是不断的聊天与讨论。
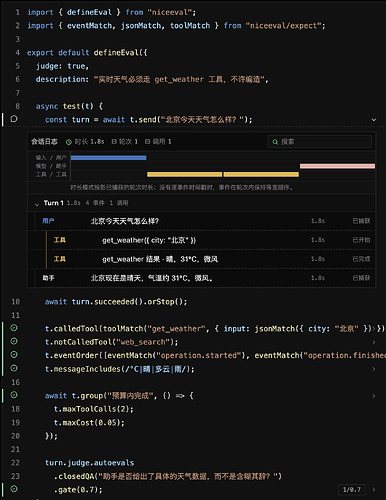
所以我们做了一个面向真实场景的 Agent 评估工具 NiceEval。在这里我们像真实用户使用Agent一样构建评估用例。
在用户发送一条消息之后,我们还可以评估一个agent是否加载了正确的skill、是否正确的调用了工具,又或者调用的顺序对不对。
然后对比同样的是 Agent 评估的 Harbor。我们可以更容易构建不同 A/B 实验进行评估。```
// experiments/harness/v0.12.0-a.ts
export default defineExperiment({
description: "评估 NiceEval 0.12 版本, system prompt 为 A 版本",
agent: codexAgent(),
model: "gpt-5.6-terra",
flags: { prompt_version: "A" },
sandbox: dockerSandbox(),
evals: (evalDef) => evalDef.tags.includes("harness")
});// experiments/harness/v0.12.0-b.ts
export default defineExperiment({
description: "评估 NiceEval 0.12 版本, system prompt 为 B 版本,改进 INDEX 机制",
agent: codexAgent(),
model: "gpt-5.6-terra",
flags: { prompt_version: "B" },
sandbox: dockerSandbox(),
evals: (evalDef) => evalDef.tags.includes("harness")
});
```通过对比实验这样我们就能知道优化一个 Prompt、优化一个 Memory、替换一个模型可以帮助系统在各种真实的用户场景下面进步了多少。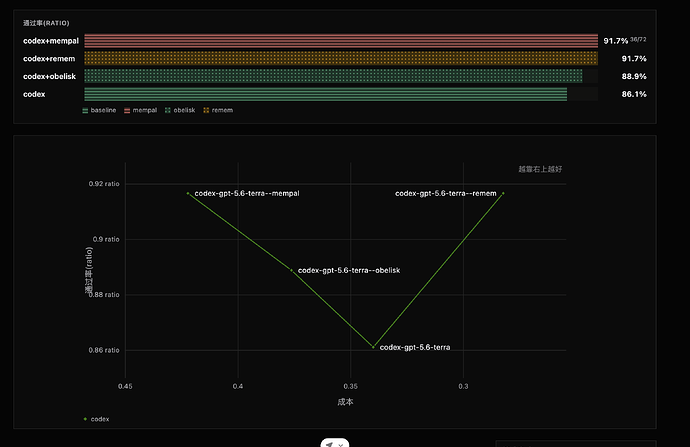
(图片为中间过程测试,仅供样式参考,不代表 Memory Bench 实际表现)
行为追踪与迭代飞轮
在完成实验之后,niceeval 通过 view 提供图片化的报告,可以在每个attamp里面看到具体的执行过程。不仅在 GUI。在 cli 中一样可以可以通过
pnpm exec niceeval show @ --execution看到,所以 AI 就可以通过 harness 判断被评估的 Agent 是否作弊。(该功能样式参考 DSH 的追踪)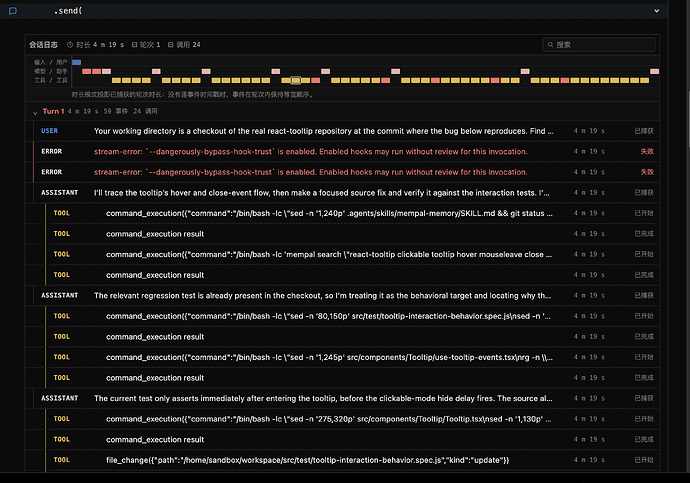
该版本为0.15.0,后续更新 Memory Bench 的线上新的 live demo。
只要构建真实的评估用例之后,再加上 niceeval 的 cli 就可以设置一个 goal 给你的 Codex ,整晚通宵的帮你定位问题所在不断进步了。
接下来的 Roadmap
NiceEval 0.15 已经创建各种评估或者 Benchmark 了。比如通过制评估、分数制评估。还是接 Web 里面跑的 Agent 又或者是需要在用户电脑上跑的 Agent,但是它离我所想像完整的 Agent 评估工具还挺很长一段距离。
主要有四条线:
- 更好的harness,未来写评估用例、构建 AB 测试还有分析 Agent 哪些可以进步,哪些可以迭代都可以完全的交给 Agent 来做。
- 更方便的评估,给你的项目配一个评估评估器其实是比较麻烦的,应该由 AI 一步到位 Agent 到 NiceEval 接入到 OTel 还有 AB 的接入。
- 共享评估套件,提供更多高质量的评估用例集,方便用户用别人的评估测试集评估自己的场景。
- 完善文档,现在官方文档还是 AI 味太重了,我需要重新人工介入手工重写整套教程。帮助大家更快的上手 NiceEval。
NiceEval 评估生态圈
- NiceEval,核心,负责核心 Agent 评估生态。
- Memory Bench,一个真实高价值的 Agent + Memory 的 Benchmark,也算一种 DogFood了。
- NiceEval Terminal Benchmark,把 Harbor 的 Terminal Bench 迁移到 NiceEval 来等价实现。
- NiceEval-Eval,加速飞轮,负责 NiceEval Harness 是否好用。
NiceEval长出一套比较完整的链路,有niceeval做agent评估的核心。而后续其它benchmark帮助用户在开发自己agent的时候不需要自己马上开始写评估用例。可以先从
使用文档 为你的 Agent 项目设置评估 - niceeval
给我一个 star ^-^ 吧
github.com
GitHub - NiceEval/NiceEval: build eval for your agent in 10 mins
build eval for your agent in 10 mins
参考文献:
- SOW:论母猪的产后护理
主楼 - Amashiro2026-08-18
感觉还不错,刚好最近有eval的需求,先点star了
- 刃者〆寒霜2026-08-18
楼主牛逼啊,看起来挺不错的,期待一波「Memory Bench」这玩意儿,现在做 Memory 的 eval 挺麻烦的(
- 风花一世月2026-08-18
ai好用是好用,还是得训好才行。