- 12dora2026-08-18
前言: 多Agent协同工作时, 如何设置不同角色的模型和思考强度往往是个问题, 例如探索代码就像主Agent的眼睛, 如果质量不好会直接影响设计和执行. 那么如何知道什么模型最适合担任代码探索角色, 这次请出 A/(Opus 5), O/(GPT5.6 系列), Grok, Cursor. 7个模型共计21种配置决一胜负.
注: 所有模型都为正价官订, 不存在降智等问题, 本报告由我+Fable5联合编制.
测试集: 从我开发的一个复杂企业级业务系统中让fable抽取2个复杂代码文件, 同时交给21个Agent去做代码探索
参赛模型: Opus 5、Grok 4.6、Grok 4.5、GPT- 5.6-Sol、GPT- 5.6-Terra、GPT- 5.6-Luna、Composer 2.5
太长不看版结论:
- Opus5擅长review确有其事, A/在发布稿中说低effort也不错是真的, 但是不包括low
- Grok 额度很多的可以考虑4.6, 4,5和4.6差异大
- Sol 没有明显优势, 性价比低; Terra 查无此人
- Luna high 又便宜又好
- Composer 2.5拉完了, 等3吧
排行榜柱状图(分数越高越好):
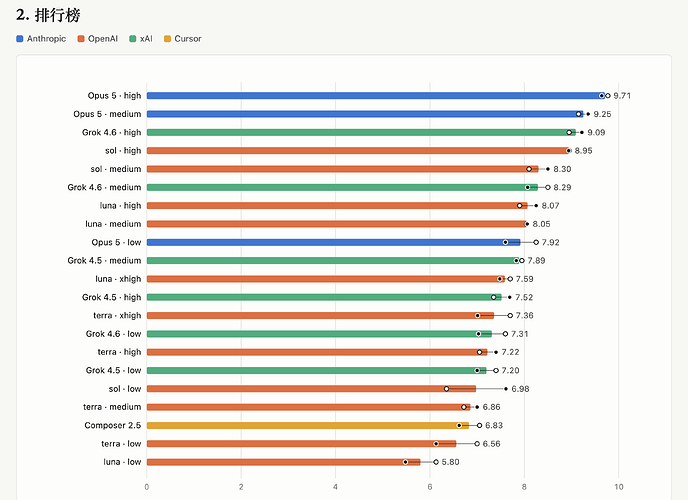
总分 = 40% Bug 质量 + 25% 探索深度 + 15% 准确性 + 10% 诚实度 + 10% 结构指标
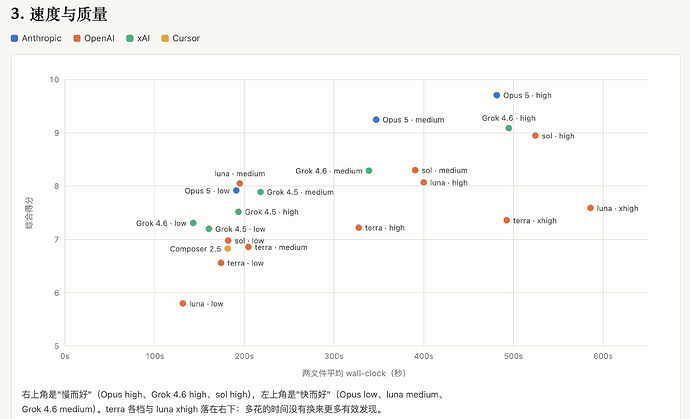
速度/质量图(右上角: 慢而好, 左上角: 快而好, 左下角: 快而差, 右下角: 慢而差):
详细数据:
|
代理 |
综合 |
Bug 质量 |
探索深度 |
准确 |
诚实 |
结构 |
有效发现/文件 |
独家发现 |
平均耗时 |
最长耗时 |
工具调用 |
输入 tokens |
输出 tokens |
报告字数 |1 |
Opus 5 · high |
9.71 |
9.50 |
10.00 |
10.00 |
10.00 |
9.00 |
10.5 |
0 |
482s |
483s |
51.0 |
10,792,386 |
35,796 |
3,806 |2 |
Opus 5 · medium |
9.25 |
8.75 |
9.50 |
10.00 |
10.00 |
8.70 |
9.0 |
0 |
347s |
384s |
42.0 |
6,466,742 |
20,553 |
3,041 |3 |
Grok 4.6 · high |
9.09 |
8.25 |
9.50 |
10.00 |
10.00 |
9.10 |
8.0 |
3 |
495s |
553s |
78.0 |
1,538,572 |
27,386 |
2,863 |4 |
sol · high |
8.95 |
8.25 |
9.00 |
10.00 |
10.00 |
9.00 |
6.0 |
4 |
524s |
552s |
59.5 |
3,777,834 |
22,530 |
3,352 |5 |
sol · medium |
8.30 |
7.00 |
8.50 |
10.00 |
10.00 |
8.70 |
5.0 |
2 |
390s |
411s |
33.5 |
2,488,952 |
16,520 |
2,966 |6 |
Grok 4.6 · medium |
8.29 |
7.25 |
8.00 |
10.00 |
10.00 |
8.80 |
7.5 |
0 |
339s |
355s |
64.0 |
955,090 |
20,192 |
2,567 |7 |
luna · high |
8.07 |
6.75 |
8.00 |
10.00 |
10.00 |
8.70 |
4.0 |
0 |
400s |
439s |
39.5 |
2,227,129 |
19,584 |
2,288 |8 |
luna · medium |
8.05 |
7.00 |
7.50 |
10.00 |
10.00 |
8.80 |
4.5 |
0 |
195s |
212s |
41.0 |
641,516 |
8,886 |
2,198 |9 |
Opus 5 · low |
7.92 |
8.00 |
7.00 |
8.00 |
9.00 |
8.70 |
8.5 |
0 |
191s |
215s |
19.5 |
2,056,344 |
15,068 |
2,471 |10 |
Grok 4.5 · medium |
7.89 |
7.00 |
7.00 |
10.00 |
10.00 |
8.40 |
7.0 |
0 |
218s |
226s |
40.5 |
442,834 |
11,769 |
2,314 |11 |
luna · xhigh |
7.59 |
5.50 |
8.00 |
10.00 |
10.00 |
8.90 |
3.5 |
0 |
586s |
598s |
71.5 |
4,007,058 |
27,712 |
2,362 |12 |
Grok 4.5 · high |
7.52 |
6.75 |
6.50 |
9.00 |
9.50 |
9.00 |
7.0 |
0 |
194s |
205s |
40.0 |
451,479 |
10,793 |
2,408 |13 |
terra · xhigh |
7.36 |
5.25 |
7.50 |
10.00 |
10.00 |
8.80 |
2.5 |
0 |
492s |
494s |
26.5 |
2,099,889 |
23,553 |
2,312 |14 |
Grok 4.6 · low |
7.31 |
6.25 |
7.00 |
8.50 |
9.00 |
8.90 |
4.5 |
0 |
143s |
147s |
25.5 |
284,141 |
7,054 |
1,872 |15 |
terra · high |
7.22 |
5.25 |
7.00 |
10.00 |
10.00 |
8.70 |
2.5 |
0 |
328s |
356s |
17.0 |
1,144,598 |
14,874 |
2,162 |16 |
Grok 4.5 · low |
7.20 |
6.00 |
6.00 |
9.50 |
10.00 |
8.70 |
6.0 |
0 |
160s |
169s |
30.5 |
327,210 |
8,448 |
2,228 |17 |
sol · low |
6.98 |
5.25 |
6.00 |
10.00 |
10.00 |
8.80 |
3.0 |
0 |
182s |
204s |
7.5 |
415,890 |
8,106 |
2,689 |18 |
terra · medium |
6.86 |
4.75 |
6.50 |
10.00 |
10.00 |
8.30 |
1.5 |
0 |
204s |
207s |
11.0 |
643,214 |
9,640 |
2,090 |19 |
Composer 2.5 |
6.83 |
5.75 |
6.00 |
9.00 |
8.00 |
8.80 |
6.0 |
0 |
182s |
204s |
41.5 |
397,044 |
10,828 |
2,289 |20 |
terra · low |
6.56 |
4.25 |
6.00 |
10.00 |
10.00 |
8.70 |
2.5 |
0 |
174s |
186s |
10.5 |
569,704 |
7,928 |
2,112 |21 |
luna · low |
5.80 |
4.25 |
5.00 |
7.50 |
9.50 |
7.80 |
3.0 |
0 |
132s |
144s |
5.5 |
205,176 |
5,506 |
1,992 |原始html报告: 不同模型代码探索能力评测.html.zip (27.1 KB)
主楼 - Neo-linuxdo2026-08-18
内容用心了,表格格式似乎出了问题。
- Rick_Su2026-08-18
佬友,能看看拿肥波水平如何吗 ^-^还有千问3.8 和glm5.3 最近挺多夸的 ^-^
- himym2026-08-18
看来 opus5 还是这么让人可信,我也要搞点试试了
- hedgie2026-08-18
这就把fable5的子代理切成opus5 high
- 无名氏2026-08-18
所以是Grok 4.6 · high 性价比很高?
- 🛡️Rice_R._Rug_💛🍋⭐️💫2026-08-18
- 12dora2026-08-18
其实Luna性价比最高, 当然有grok订阅额度用不完4.6是好上加好
- Nxty2026-08-18
- xboker2026-08-18
给佬赞一个,用心了, 一直觉得Grok拉, 没想到这么强;
- 郑建国2026-08-18
赞一个,之前一直怕luna能力跟不上用的sol low。
- Zerouscn2026-08-18
900刀一年的heavy含金量急剧上升
- zlex2026-08-18
- devalunx2026-08-18
gpt5.6 sol 是用的1M 上下文么
- 12dora2026-08-18
所有agent均采用对应平台的默认设置(即258k)
- apparition2026-08-18