- 脚趾剑匣2026-08-18
本文内容较长,如果你耐心读完相信会有收获 ^-^
前言
作为Comet的作者,本帖我解答下Comet到底是在做什么,以及我们的设计理念是什么
Comet最早让大家认识应该是在5月份刚开源的时候
可以进入文档站详细了解下,以及最新的帖子
同时发布的还有一系列视频,由于最近没时间推广Native模式,老视频的热度很高,很多佬对Comet的认识就是他是一个Openspec+Superpowers的编排层,但其实我们在第一个视频就已经指出了Comet组合他们两个从来不是目的,随着Comet的快速迭代,他已经不仅仅是一个Skill了,我们只是需要一个足够强大,链路足够稳定的Skill来沉淀出符合真实工作、生产环境可用的运行时(Runtime/Harness),这里我以时间正序列举,Comet各个大版本迭代是要去解决什么问题
开源历程
一、5月-初始开源OpenSpec+Superpowers组合
在5月份这个节点上,市面上还没有出现Fable5、GPT5.6这类的具备superpowers思维链的强模型。在这个前提下,OpenSpec、Superpowers在当时的模型上还是非常有效的方法。在开源之前我已经深度使用了这类SDD很久(大概几个月的时间),此时mattpocock/skills还没有在国内火出圈,没有公众号铺天盖地的推广
在当时的时间节点,我在使用这类SDD时主要面临着几个问题:
- 有超过90%的时间我都在点yes,有太多的Skill名字需要记忆,但很多流程是相对固定的,却需要手动调用
- Superpowers没有原生管理需求的能力、OpenSpec有原生管理需求的能力,但澄清维度不足
所以因为想要偷懒,我将他们两个结合起来进行了SOP封装,最早他们是在CLAUDE.md中的类似如下的编排
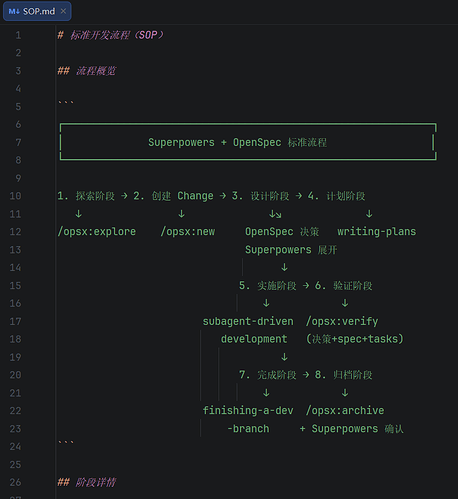
但很快我就发现,对于这样的长链路嵌套Skill调用的一系列问题,如下:
- Agent在多次上下文压缩后完全忘记了下一步该调用什么Skill
- Agent没有真实触发Skill、但是做了类似Skill要求的事情,过程中有遗忘
- Agent在跳过了关键Skill流程,直接开始写代码,比如链路上要求澄清完毕之后才能开始写代码,Agent没有问你问题就直接开干了
- 没有跨设备0上下文恢复经常需要交代上下文、没有可靠的状态扭转、没有意图识别、没有强制的门禁守护,全凭Agent自觉
与此同时我们还有另外的真实工作需求:
- 对于个人:每个人都有自己的Skill偏好、比如一个人可能喜欢grill-me,另外一个人喜欢brainstorming,和评论区大多数佬友们一致,我们喜欢挑选好用的Skill来自己组装
- 对于团队:业务上我们经常需要对接其他团队的Skill,这些Skill不是我们写的,但是编排链路一长,在当时的模型建设下怎么稳定执行变成了问题,也就是上面提到的这些,很容易踩坑
- 对于业界:现成的好用的SKill非常多,假如我们需要一个Work、Excel能力,用官方写的肯定比自己让AI临时写的好得多
我带着这些问题,优先将Comet的OpenSpec+Superpowers的链路进行了连接,着重解决了长程嵌套Skill上怎么做稳定Skill触发、跨设备上下文恢复、状态机、意图识别、阶段门禁守护,然后进行了开源工作。也就是大家看到的初版Comet,其中思考的问题是如果我们能够基于这套长程任务Skill拿到可以复用的Skill Harness实践,那后续组合Skill并稳定执行这个问题就可以很好的解决了
二、6-7月-大厂相同实践开始宣发,Comet开始着手Eval评估和Skill组合,拥有了更多的渐进式加载最佳实践
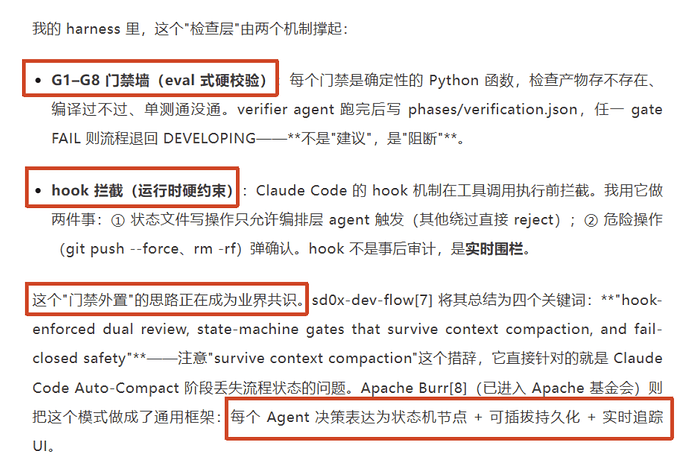
在6-7月我们观察到有许多海内外大厂和组织如LangChain、Apache、腾讯、阿里、字节开始宣发类似思想的Skill实践,在我们开源之际,类似的文章还是没有的
所以后来我们专门写了一篇文章,让大家了解Comet是如何和海内外大厂拥有同样的实践思路的
Comet Docs
Comet 与业界实践对照 - Comet Docs
Comet 的运行时、工作流、评估、Skill 创作与分发分别对应业界的哪些实践。本文不展开这些文章的细节,而是按维度列出 Comet 的每项做法及其对应的业界参考,作为延伸阅读的索引。
下图来自于阿里的技术公众号
在这个月我们集中打磨了Comet的渐进式加载,更多可以原子化的Reference,包括用户停顿点(HITL),自动推进Skill协议,上下文恢复协议,工作区标准等等
这些文件内容都不大但思路是很清晰的,大家可以在对应的机制中学到东西
同时随着Comet Skill的高速迭代,我们迫切需要一个能够评估Skill的机制来衡量,每一次Skill变更的方向到底有没有副作用,Skill是否真的变好了。
随着我们的用户增多,我们不能够凭手感来做这件事情,过去我见过非常多的Skill作者,大家用AI迭代得很快,但功能不稳定,效果好不好全凭手感,这不是一个良好的迭代模式。
彼时我们依旧没能在社交平台在看到很多Eval工作,很多都跑在论文上,有的评测过于简单,并不适合于Coding Agent这种经常需要和用户交互的场景
我们在Eval上做了很多扎实的工作,包括怎么用用户最长使用的Claude Code、Codex去评估任意的SKill,怎么让整个评估过程全自动化,怎么使用Rubric、Pass@K、Pass^K评分评估Skill、怎么接入LangSmith、LangFuse
怎么让Skill迭代变成一个系统性的工程,我们克服了非常多的困难,用实打实的真实Token消耗进行了评估,并将这部分命名为了Comet Eval将源码进行了开源
详细的介绍贴可见
本帖使用社区开源推广,符合推广要求。我申明并遵循社区要求的以下内容:
我的帖子已经打上 开源推广 标签: 是
我的开源项目完整开源,无未开源部分: 是
我的开源项目已链接认可 LINUX DO 社区: 是
我帖子内的项目介绍,AI生成、润色内容部分已截图发出: 是
以上选择我承诺是永久有效的,接受社区和佬友监督: 是以下为项目介绍正文内容,AI生成、润色内容已使用截图方式发出
07-13更…除此之外,我进一步的将5月待解决的问题,如何组合Skill进行了开发,我没有选择做一份类似Dify的Skill编排可视化系统,我觉得那样做不够AI原生,可能很快面临着过时的风险,所以最终他变成了/comet-any这种AI Native的Skill,能够改造Comet原始的5阶段工作流,
或者根据用户自己的Skill偏好生成一套类似Comet流程的的Skill,自带Comet沉淀下来的Runtime运行时经验
三、7月-8月-Comet Native工作流诞生
随着Fable5和GPT 5.6的发布,我很快感受到,模型能力来到了一个新的阶段。GPT 5.6中展示出来了几乎和Superpowers类似的思维链,这印证了我之前多个视频的观点,“如果一个Skill的轨迹是相对固定的,那他一定能够被评估,只要我们做好评估侧的工作,将指标作为GroudTruth,就能够形成数据集,模型就是可以训练的”。
在发现这点之后,得益于之前已经打造好的Runtime,我在5.6发布几天后就开源了Comet Native Skill,我的核心思考是:
- 当模型能力足够强大之后,Skill即将迎来类似过去Agent Loop从Workflow式核心全面走向ReAct核心的转变
- Superpowers的工程铁律对于强模型而言与原生思维链发生冲突,但还是有很多我们可以考虑留下,比如TDD,Brainstorming
- Skill更应该注重要记录什么,要做什么,怎么验收,具体怎么做我们不再需要关心,几个极其轻量的文档足矣
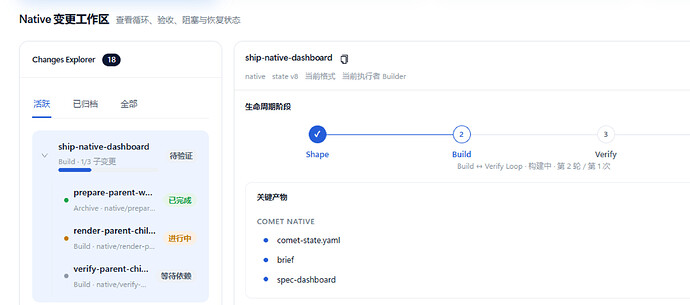
这样做出来的Native Skill只用了100+行Skill内容就完成了核心工作,同时我们原生了grill-me式的高强度澄清,分为了线性澄清和批量澄清两种模式,与之带来的是benchmark上减少了75%的Token消耗和45%的时间,同时没有发生准确率下降,核心采用Loop Engineering驱动,并带有Supervisor Change模式,真实的贴合工作环境,通常我们在工作时都是一个大型需求下派发子需求,Native能够通过DAG检测这部分依赖关系,能够并行的并行,有依赖的等待
Supervisor Change模式一览
Native工作流还迎来了一些更加自由的,RaAct式的实现机制
我们在使用Native工作流时没有指定任何实现方法,但当你在本地安装了TDD、BDD这样的方法型Skill时,Agent会自己在实现过程中判断并发起TDD实现
这让我们回到了Skill的本质,模型观测Skill name和desc,判断要不要调用,而不是强制在流程中
在使用Native Skill的时候我们有非常多的自由用法,你可以不用Native的澄清,直接用grill me with docs产出的文档,纯粹把Native当做执行器,在自己的Loop循环内他能够完成你的文档内容
设计理念
四、最后是关于我们的设计理念
Comet对于功能堆砌保持一定克制,以下是我们的思考
- 自进化记忆、自进化Skill、自动文档沉淀
这几个都是非常火热的方向,我在自进化主题的研究开始于Agent Skill这项技术成为正式公开标准之前,相关的PR提交给了Spring AI Alibaba DeepResearch
github.com/spring-ai-alibaba/deepresearch
feat(memory): self-evolving user role memory-enabling the agent to better understand the user in multi-turn conversations. (#20)
main←benym:user_shortcontext_memory已合并 12:01PM - 05 Dec 25 UTC
benym
+1781
-67Describe what this PR does / why we need it
Current situation:
The… current
DeepResearchproject lacks conversation memory, after a round of conversation, the model cannot remember what the user just said.Based on the above background, this PR provides the following two feat implementations.
1. Conversation Memory: Supports recording user questions and the final agent's answers or reports.Support for the use of session memory in deepresearch multi-turn dialogues
2. User Role Memory: Learns users' potential characteristics in real time and continuously through multi-turn conversations by analyzing their chat content, and uses these characteristics to guide the agent to generate conversation content that is more suitable for the user.Describe how you did it
Conversation Memory
The implementation of conversation memory is fairly conventional, still using Spring AI's
org.springframework.ai.chat.memory.MessageWindowChatMemory, and then manually recording it at the nodes that need to be recorded throughout the DeepResearch project.In this feat, conversation memories are primarily stored and retrieved in the
CoordinatorNodeandReporterNode, corresponding to the agent accepting requests and returning responses, respectively.User Role Memory
Motivation
User role memory stems from user habits encountered during conversations with the agent—users often inform the agent of their professional background to guide the agent in producing responses more appropriate to their context.
For example, the agent's response will be significantly different if the user assumes they are a university student versus an elementary school student.
However, relying solely on the user to guide the agent is not intelligent enough.
Our goal is to enable agents to proactively learn user role information from conversations and use this information to guide LLMs in real time and at the conversational level, while supporting adaptive evolution and updates of role information across multiple rounds of conversation.
Architecture
User role memory uses a method similar to
mem0for memory extract and updating.Unlike mem0, conversation-level memory bootstrapping requires speed and real-time processing, focusing more on short-term memory rather than generating
knowledge graphcontent such as entity-relationship structures. Therefore, in its implementation, role memory generally uses the same storage method as short-term memory, such as in-memory or Redis.User role memory is divided into two stages:
1. extract
This defines a
ShortUserRoleExtractResultentity, which is detailed below, includingConversationAnalysis,IdentifiedRole, andCommunicationPreferences. This attempts to describe the user's current role and communication preferences using these three methods.```ts
interface ConversationAnalysis {
confidenceScore: number; // The confidence score ranges from 0 to 1
interactionCount: number; // The number of interactions in the current session
}interface IdentifiedRole {
possibleIdentities : string[]; // List of possible identities, like "software_engineer", "housewife", etc.
primaryCharacteristics: string[]; // Main character feature tags
evidenceSummary: string[]; // Summary of identification basis
confidenceLevel: 'LOW' | 'MEDIUM' | 'MEDIUM_HIGH' | 'HIGH'; // Confidence level
}interface CommunicationPreferences {
detailLevel: 'CONCISE' | 'BALANCE' | 'COMPREHENSIVE'; // Detail preference level
contentDepth: 'OVERVIEW' | 'PRACTICAL' | 'CONCEPTUAL'; // Content depth
responseFormat: 'CONCISE' | 'DETAILED' | 'STRUCTURED_WITH_EXAMPLES'; // Preference response format
}interface ShortUserRoleExtractResult {
conversationAnalysisInfo: ConversationAnalysis;
identifiedRole: IdentifiedRole;
communicationPreferences: CommunicationPreferences;
userOverview: string; // To describe User information in one sentence based on identifiedRole and communicationPreferences, the occupation information in possibleIdentities must be used
}
``For each user'squestion,ShortMemoryAgentwill refer tohistorical user questions` to extract user role memories.Q: For extraction functionality, why do we only need to consider the user's question and not provide the LLM answer within the context?
A: This stems from a phenomenon where, during interpersonal communication, humans can observe the speaker's words to infer their approximate identity and communication habits. However, what the other person says during communication doesn't determine my own role or background; rather, what I say is most important in defining my user identity.
2. update
Here are three important memories.
-
Current Extract Memory:The current user role memory generated in theextract phaseis based on current user questions and historical user questions.Previous Extract Memory:The latest user role memory. In a single conversation, there is only one up-to-date user role memory, because role memory should evolve continuously with each user's questions.History Extract Track:Historical User Role Memory Evolution Trajectory
During the update phase, this section transmits the current user role memory (
Current Extract Memory) and the most recent user role memory (Previous Extract Memory) extracted in the current round, as well as the historical user role memory track (History Extract Track). If the extracted current user role memory and the most recent user role memory exceed a set threshold, anUPDATEoperation is triggered, during which similar words and features are merged. If the two are significantly different, the History Extract Track is referenced to determine whether to perform anUPDATE. If they are still different, aNONE CHANGEis triggered, and the most recent user role memory is returned.Logical Overview
The extraction and update logic is implemented in
ShortUserRoleMemoryNode. This logic is designed to make the user role memory mechanism more suitable for multi-turn conversation scenarios.
<img width="8897" height="757" alt="会话引导机制-横板" src="https://github.com/user-attachments/assets/38913d15-b360-42f5-bdc0-ae6185139d62" />Case Study
Conversation memory (No plan):
<img width="805" height="858" alt="会话记忆-未触发工具调用" src="https://github.com/user-attachments/assets/fbf068f5-3799-45dd-bf9a-bf690a4033ef" />```json
{
"code": 200,
"status": "success",
"message": "",
"data": [
{
"messageType": "USER",
"metadata": {
"messageType": "USER"
},
"media": [
],
"text": "我想做红烧肉给家人吃"
},
{
"messageType": "ASSISTANT",
"metadata": {
"finishReason": "STOP",
"search_info": "",
"id": "8be26c58-0881-4601-9dba-b7bc0921f162",
"role": "ASSISTANT",
"messageType": "ASSISTANT",
"reasoningContent": ""
},
"toolCalls": [
],
"media": [
],
"text": "红烧肉是一道非常受欢迎的家常菜,做法也相对简单。下面是一个基础版本的红烧肉食谱供您参考:\n\n### 材料\n- 五花肉 500克\n- 生姜几片\n- 葱 2根\n- 八角 2颗\n- 老抽、生抽各适量\n- 糖(最好是冰糖)3大勺\n- 清水足够覆盖肉块\n- 料酒少许\n\n### 做法\n1. 准备材料:将五花肉切成约2厘米见方的小块;生姜切片;葱打结。\n2. 焯水:把切好的五花肉放入冷水中,加入少量料酒和几片生姜,大火煮开后撇去浮沫,捞出洗净备用。\n3. 炒糖色:锅中放少量油,加入糖小火慢慢加热至糖融化并开始变色成琥珀色时,迅速加入焯好水的五花肉快速翻炒均匀,使肉块表面裹上糖色。\n4. 调味炖煮:向锅中加入足够的热水(没过肉),再加入剩余的生姜片、葱结、八角以及老抽调色调味,大火烧开后转小火慢炖约1小时左右或直到肉质软烂。\n5. 收汁:待肉快熟时开大火收汁,根据个人口味调整盐分,并且可以适当增加一些生抽提鲜。\n6. 完成:最后撒上葱花即可出锅享用啦!\n\n希望这个简单的步骤能帮助到你,给家人带来一顿美味的红烧肉!如果需要更详细的步骤或者其他建议,请随时告诉我。"
},
{
"messageType": "USER",
"metadata": {
"messageType": "USER"
},
"media": [
],
"text": "有老人和小孩,可以调整下食谱吗"
},
{
"messageType": "ASSISTANT",
"metadata": {
"finishReason": "STOP",
"search_info": "",
"id": "1571fcda-d3a6-4c33-8111-8126fad74c96",
"role": "ASSISTANT",
"messageType": "ASSISTANT",
"reasoningContent": ""
},
"toolCalls": [
],
"media": [
],
"text": "当然可以调整,考虑到老人和小孩的口味偏好以及消化能力,这里有一些小建议来调整红烧肉的做法:\n\n1. 减少糖量:因为老人和小孩可能对甜食比较敏感,你可以适当减少糖的用量。如果原本使用了3大勺糖,那么可以尝试减至2大勺或更少。\n\n2. 增加蔬菜:在炖煮过程中加入一些容易消化且富含纤维素的蔬菜如胡萝卜、土豆等,不仅能让菜肴更加营养均衡,还能让口感更加丰富多样。\n\n3. 软烂易嚼:确保五花肉炖得足够软烂,这样更容易被老人和孩子咀嚼吞咽。烹饪时间可以适当延长至1小时半甚至更长,直到肉质非常柔软为止。\n\n4. 调味清淡:除了减少糖外,还可以稍微减少酱油(尤其是老抽)的使用量以降低咸度;同时避免使用过多辛辣调料,保持整体味道温和。\n\n5. 去皮处理:对于五花肉中的肥肉部分,可以选择去除表皮或者只保留少量脂肪层,这样既能保证菜品的风味又不会过于油腻。\n\n按照以上几点调整后的红烧肉应该会更适合全家人的口味哦!希望这些建议对你有所帮助。"
}
]
}
```User Role Memory (Plan):History User Role Extraction Track - Role Information Evolves Based on User Chat
<img width="5632" height="1936" alt="用户角色记忆进化轨迹" src="https://github.com/user-attachments/assets/994ee359-8b11-4e20-8127-c59e7dd5d80f" />
Source json```json
{
"code": 200,
"status": "success",
"message": "",
"data": [
{
"messageType": "SYSTEM",
"metadata": {
"messageType": "SYSTEM"
},
"text": {
"userId": "MOCK_USER_ID",
"conversationId": "7ad1d39a-d8b5-41d0-aaa1-c6442fb4fb83",
"userQuery": "研究下回锅肉的做法",
"conversationAnalysis": {
"confidenceScore": 0.7,
"interactionCount": 1
},
"identifiedRole": {
"possibleIdentities": [
"家庭主妇",
"烹饪爱好者"
],
"primaryCharacteristics": [
"注重实际操作",
"关注具体步骤"
],
"evidenceSummary": [
"询问了回锅肉的做法"
],
"confidenceLevel": "MEDIUM"
},
"communicationPreferences": {
"detailLevel": "CONCISE",
"contentDepth": "PRACTICAL",
"responseFormat": "CONCISE"
},
"userOverview": "一位注重实际操作的家庭主妇或烹饪爱好者,倾向于简洁明了的步骤说明",
"creatTime": "2025-12-01 18:18:19",
"updateTime": ""
}
},
{
"messageType": "SYSTEM",
"metadata": {
"messageType": "SYSTEM"
},
"text": {
"userId": "MOCK_USER_ID",
"conversationId": "7ad1d39a-d8b5-41d0-aaa1-c6442fb4fb83",
"userQuery": "改进一下口味,让他更加适合于老人和小孩",
"conversationAnalysis": {
"confidenceScore": 0.8,
"interactionCount": 2
},
"identifiedRole": {
"possibleIdentities": [
"家庭主妇",
"烹饪爱好者"
],
"primaryCharacteristics": [
"注重健康饮食",
"关注家庭成员需求"
],
"evidenceSummary": [
"要求改进菜的口味以适合老人和小孩",
"之前询问了回锅肉的做法"
],
"confidenceLevel": "HIGH"
},
"communicationPreferences": {
"detailLevel": "BALANCE",
"contentDepth": "PRACTICAL",
"responseFormat": "STRUCTURED_WITH_EXAMPLES"
},
"userOverview": "一位注重健康饮食的家庭主妇或烹饪爱好者,关注家庭成员的需求,希望获得适合老人和小孩的实用食谱建议",
"creatTime": "2025-12-01 18:24:35",
"updateTime": "2025-12-01 18:24:59"
}
},
{
"messageType": "SYSTEM",
"metadata": {
"messageType": "SYSTEM"
},
"text": {
"userId": "MOCK_USER_ID",
"conversationId": "7ad1d39a-d8b5-41d0-aaa1-c6442fb4fb83",
"userQuery": "我想在进一步研究一下适合于家庭成员的回锅肉做法,详细一点",
"conversationAnalysis": {
"confidenceScore": 0.8,
"interactionCount": 3
},
"identifiedRole": {
"possibleIdentities": [
"家庭主妇",
"烹饪爱好者"
],
"primaryCharacteristics": [
"注重实际操作",
"关注细节",
"注重健康饮食",
"关注家庭成员需求"
],
"evidenceSummary": [
"询问了回锅肉的详细做法",
"之前询问过回锅肉的做法",
"要求改进菜的口味以适合老人和小孩"
],
"confidenceLevel": "HIGH"
},
"communicationPreferences": {
"detailLevel": "COMPREHENSIVE",
"contentDepth": "PRACTICAL",
"responseFormat": "STRUCTURED_WITH_EXAMPLES"
},
"userOverview": "一位注重实际操作、细节、健康饮食和家庭成员需求的家庭主妇或烹饪爱好者,希望获得详细的回锅肉做法说明以及适合老人和小孩的改良建议",
"creatTime": "2025-12-01 18:26:12",
"updateTime": "2025-12-01 18:26:27"
}
}
]
}
``Related user conversastion memory``json
{
"code": 200,
"status": "success",
"message": "",
"data": [
{
"messageType": "USER",
"metadata": {
"messageType": "USER"
},
"media": [
],
"text": "研究下回锅肉的做法"
},
{
"messageType": "ASSISTANT",
"metadata": {
"messageType": "ASSISTANT"
},
"toolCalls": [
],
"media": [
],
"text": "# Key Points\n- 回锅肉是一道经典川菜,核心步骤包括煮肉、煸炒和调味。\n- 煮肉时需冷水下锅,加入料酒和葱段,煮至筷子能轻松插入后切片。\n- 煸炒时要将五花肉的油脂充分炒出,搭配蒜米或花椒增加香味。\n- 调味料的选择和火候控制是回锅肉香而不腻的关键。\n- 不同做法在细节上有所差异,但基本流程一致。\n\n---\n\n# Overview\n回锅肉作为川菜中的经典代表,以其鲜香不腻、口感丰富的特点深受喜爱。这道菜的核心在于通过煮、炒两步工艺处理五花肉,并结合调味料使其风味浓郁。本报告旨在梳理回锅肉的烹饪步骤,分析其关键环节,并提供简洁明了的操作指南,帮助家庭主妇或烹饪爱好者快速掌握制作技巧。\n\n---\n\n# Detailed Analysis\n\n## 1. 煮肉:奠定基础口感\n煮肉是回锅肉的第一步,也是确保肉质鲜嫩的重要环节。根据研究发现,以下步骤至关重要:\n- 冷水下锅:冷水煮肉可以避免肉质因骤热而收缩,保持肉质柔软。\n- 去腥增香:加入料酒和葱段可有效去除腥味,同时增添香气。\n- 煮至适中:煮至表皮变白且筷子能轻松插入即可,避免过度煮烂影响后续煸炒。\n\n| 步骤 | 操作方法 | 目的 |\n|----------------|-------------------------------------|--------------------|\n| 冷水下锅 | 将五花肉与冷水一同加热 | 避免肉质收缩 |\n| 加入调料 | 放入料酒、葱段 | 去腥增香 |\n| 控制时间 | 煮至筷子能轻松插入 | 确保肉质适中 |\n\n案例参考:某家常做法建议煮好后静置半小时再切片,以进一步锁住肉汁(来源见参考资料)。\n\n---\n\n## 2. 煸炒:提升香气与口感\n煸炒是回锅肉的灵魂步骤,通过高温将五花肉中的油脂逼出,使成品香而不腻。具体操作如下:\n- 热锅冷油:使用菜籽油时无需等油热即可下锅,中小火煸炒更佳。\n- 灯盏窝形状:当肉片卷曲成“灯盏窝”状时,说明水分已被炒干,此时肉质最佳。\n- 辅料搭配:加入蒜米或花椒等辅料,进一步提升香气。\n\n| 关键点 | 具体操作 | 效果 |\n|----------------|------------------------------------|--------------------|\n| 灯盏窝状态 | 中小火煸炒至肉片卷曲 | 提升口感层次 |\n| 辅料选择 | 蒜米、花椒 | 增加香气 |\n| 油脂处理 | 充分炒出肥肉中的油脂 | 减少油腻感 |\n\n案例参考:某餐厅级做法强调使用菜籽油并先下肉片,以保留传统风味。\n\n---\n\n## 3. 调味:赋予独特风味\n调味是回锅肉最后一步,决定了整道菜的风味特色。常见的调味料包括豆瓣酱、甜面酱、酱油等,这些调料不仅提味,还能让肉片更加红亮诱人。\n- 豆瓣酱:为回锅肉提供咸香微辣的基础味道。\n- 甜面酱:增加一丝甜味,平衡整体口感。\n- 翻炒均匀:调味料需与肉片充分混合,确保每一片肉都入味。\n\n| 调味料 | 功能 | 使用建议 |\n|---------------|----------------------------------|--------------------|\n| 豆瓣酱 | 提供咸香微辣 | 适量即可 |\n| 甜面酱 | 增加甜味 | 根据个人口味调整 |\n| 酱油 | 上色 | 最后加入 |\n\n---\n\n## 4. 细节优化:个性化调整\n不同地区和个人习惯可能会对回锅肉的做法进行细微调整,例如:\n- 火候控制:全程中小火更适合新手操作,避免烧焦。\n- 辅料变化:青椒、洋葱等蔬菜可作为配菜,丰富营养和口感。\n- 提前准备:煮好的五花肉可冷藏保存,方便随时取用。\n\n---\n\n# Survey Note (Optional)\n本报告综合了多篇关于回锅肉的文章和教程,涵盖了从家常到餐厅级别的多种做法。由于部分资料未标明具体数据,因此在实际操作中可能需要根据个人经验进行微调。\n\n---\n\n# Key Citations\n- 回锅肉的做法_经典川菜,下饭好菜 \n- 如何炒出餐廳等級的回鍋肉?正確作法別漏掉! \n- 回锅肉的家常做法,这样制作香浓不腻,美味下饭 \n- 薇式回锅肉【中餐厅】的做法步骤 \n- 今天研究有香草味的回锅肉"
},
{
"messageType": "USER",
"metadata": {
"messageType": "USER"
},
"media": [
],
"text": "改进一下口味,让他更加适合于老人和小孩"
},
{
"messageType": "ASSISTANT",
"metadata": {
"finishReason": "STOP",
"search_info": "",
"role": "ASSISTANT",
"id": "7a4b90b7-faf6-4ca8-a0d5-40b93ffcb2c0",
"messageType": "ASSISTANT",
"reasoningContent": ""
},
"toolCalls": [
],
"media": [
],
"text": "为了使回锅肉更适合老人和小孩食用,我们可以从以下几个方面进行调整:\n\n1. 减少辛辣:老人和小孩的肠胃可能对辛辣食物比较敏感,因此可以减少或省略豆瓣酱的使用,或者选择辣度较低的豆瓣酱。如果完全不加豆瓣酱,可以通过增加甜面酱的比例来弥补风味。\n\n2. 软化肉质:确保五花肉煮得足够软烂,这样更容易咀嚼和消化。可以在煮肉时延长烹饪时间,并且在切片前让肉稍微冷却一下,这样更容易切成薄片而不散开。\n\n3. 健康调味:使用低钠酱油和其他调味品,以减少盐分摄入;同时控制糖的用量,避免过甜。可以考虑加入一些天然食材如姜、蒜等来提味,而不是过多依赖加工调料。\n\n4. 增加蔬菜:添加适量的蔬菜不仅可以丰富营养成分,还能改善口感。例如,胡萝卜、青椒(去籽)、洋葱都是不错的选择。这些蔬菜不仅颜色鲜艳吸引孩子,而且富含维生素和纤维素,有助于促进消化。\n\n5. 温和调味:采用更加温和的调味方式,比如使用少量的生抽、老抽调色,以及适量的白糖提鲜,保持整体口味清新自然。\n\n### 改良版回锅肉食谱\n\n#### 材料\n- 五花肉 300克\n- 胡萝卜 1根\n- 青椒 1个(可选)\n- 洋葱 半个\n- 生姜 几片\n- 大蒜 几瓣\n- 甜面酱 1大勺\n- 低钠酱油 1小勺\n- 白糖 半小勺\n- 料酒 适量\n- 葱段 适量\n- 清水 适量\n- 菜籽油 适量\n\n#### 做法\n1. 准备材料:将五花肉洗净后放入冷水中,加入几片生姜和葱段,大火烧开后撇去浮沫,转中小火慢炖约30分钟至肉质变软但不散。\n \n2. 切片处理:待肉凉透后切成薄片备用;胡萝卜、青椒、洋葱分别洗净切丝。\n\n3. 炒制过程:\n - 热锅冷油下入五花肉片,用中小火慢慢煸炒至表面微黄并卷曲成“灯盏窝”状。\n - 加入切好的姜蒜末翻炒出香味。\n - 接着依次加入胡萝卜丝、青椒丝及洋葱丝快速翻炒均匀。\n - 最后调入甜面酱、低钠酱油、白糖以及少许料酒继续翻炒至上色均匀即可出锅装盘。\n\n通过以上改良措施,可以使这道传统川菜变得更加适合家庭成员中不同年龄段的人群享用,既保留了原有的美味特色又兼顾了健康需求。希望这个建议对你有所帮助!"
},
{
"messageType": "USER",
"metadata": {
"messageType": "USER"
},
"media": [
],
"text": "我想在进一步研究一下适合于家庭成员的回锅肉做法,详细一点"
},
{
"messageType": "ASSISTANT",
"metadata": {
"messageType": "ASSISTANT"
},
"toolCalls": [
],
"media": [
],
"text": "# Key Points\n- 回锅肉的核心步骤包括煮肉、煸炒和调味,使用五花肉、豆瓣酱、蒜苗等基础食材。\n- 适合老人和小孩的改良版回锅肉建议减少油腻感、降低辣度,并增加蔬菜搭配。\n- 健康调整包括选用瘦肉比例更高的部位、减少油脂用量、搭配易消化的蔬菜。\n- 烹饪时注意火候控制,避免过焦或过油,确保肉质嫩滑且易于咀嚼。\n\n---\n\n# Overview\n回锅肉是一道经典的川菜,以其香辣浓郁的味道深受喜爱。然而,传统的回锅肉可能过于油腻或辛辣,不适合老人和小孩食用。本报告旨在提供一份详细的家庭版回锅肉制作方法,并针对老人和小孩的需求提出改良建议,以满足不同家庭成员的口味与健康需求。\n\n---\n\n# Detailed Analysis\n\n## 1. 回锅肉的基本做法\n回锅肉的传统制作过程分为三个主要步骤:煮肉、煸炒和调味。以下是详细的步骤说明:\n\n### (1) 准备食材\n- 主料:选择肥瘦相间的五花肉(约300克),确保口感层次丰富。\n- 辅料:青椒、蒜苗、姜片、蒜末等。\n- 调料:郫县豆瓣酱、甜面酱、酱油、料酒、白糖、盐。\n\n### (2) 煮肉\n- 将五花肉冷水下锅,加入葱段、姜片和料酒去腥,煮至筷子能轻松插入(约15-20分钟)。\n- 捞出后冷却,切成约2元硬币厚的薄片,便于后续煸炒。\n\n### (3) 煸炒\n- 热锅冷油,将切好的肉片放入锅中,用中小火煸炒至卷曲成“灯盏窝”状,逼出多余油脂。\n- 加入姜片、蒜末、豆瓣酱翻炒出红油,随后加入甜面酱、酱油等调味料。\n\n### (4) 调味与收尾\n- 加入青椒、蒜苗等配菜,快速翻炒均匀,最后根据个人口味调整盐分即可出锅。\n\n---\n\n## 2. 改良建议:适合老人和小孩的版本\n为了适应老人和小孩的饮食需求,可以从以下几个方面对传统回锅肉进行改良:\n\n### (1) 减少油腻感\n- 选用瘦肉比例更高的部位:如猪里脊或鸡胸肉,减少脂肪含量。\n- 控制油脂用量:煸炒时尽量逼出多余油脂,避免过油。\n- 使用健康油品:如橄榄油或玉米油,代替传统的菜籽油,减少饱和脂肪摄入。\n\n### (2) 降低辣度\n- 减少辣椒和辣味调料:如豆瓣酱和辣椒酱的用量,以适应小孩和老年人的口味。\n- 增加甜味:适当加入少量糖或甜面酱,让味道更柔和。\n- 使用低盐酱油:减少钠摄入,更适合老年人健康饮食。\n\n### (3) 增加营养搭配\n- 搭配蔬菜:加入青椒、胡萝卜、洋葱等蔬菜,提升维生素和纤维素摄入。\n- 搭配主食:如米饭或面条,有助于消化吸收。\n\n### (4) 切片更薄\n- 将五花肉切得更薄一些,使其更容易咀嚼和消化,尤其适合老人和小孩。\n\n---\n\n## 3. 其他注意事项\n- 提前准备:煮好的五花肉可以冷藏保存,方便下次快速使用。\n- 火候控制:全程使用中小火,避免烧焦或粘锅。\n- 卫生安全:注意食材新鲜度,尤其是肉类,避免变质引发健康问题。\n\n---\n\n# Survey Note\n本报告综合了多个来源的视频教程、文字说明以及用户评论,结合实际操作经验,提出了适合家庭制作的回锅肉详细步骤及改良建议。由于部分数据来源于非专业渠道,可能存在一定主观性。\n\n---\n\n# Key Citations\n- 回锅肉这样做,简单又好吃 - TikTok \n- 轻松做出家常回锅肉,美食,美食教学,好看视频 \n- 祭拜肉品這樣做!簡單又下飯!冰箱剩食也能大翻身【回鍋肉】 \n- 老公最爱回锅肉,简单做一锅,川味十足,家里也能轻松复制! \n- 在家做回锅肉,轻松掌握家常美味!"
}
]
}
```User role memory guidance effect
<img width="3002" height="1588" alt="引导效果png" src="https://github.com/user-attachments/assets/90cc3fde-0ad4-4944-b2fa-1744573a540b" />Short Term Memory Properties```yaml
spring:
ai:
alibaba:
deepresearch:
# short-term memory configuration
short-term-memory:
enabled: true
# conversation memory configuration
conversation-memory:
# maximum Reservation conversation Length
max-messages: 100
# user role memory configuration
user-role-memory:
# scope of User Role Short-Term Memory Guidance Model Generation
guide-scope: every
# The similarity threshold for determining when a memory update is needed ranges from 0 to 1, with a default of 0.8.
update-similarity-threshold : 0.8
# Refer to the number of questions asked by users in the past
history-user-messages-num: 10
# memory-type
memory-type: in-memory
```### Http EndPointGet conversation history messages
- GET http://localhost:8080/api/user/memory/conversation
Get user roles extract short-term memory track
- GET http://localhost:8080/api/user/memory/track
Get latest user role memory
- GET http://localhost:8080/api/user/memory/latest
Delete user role memory
- POST http://localhost:8080/api/user/memory/delete?session_id=__default__
目的是让Agent能够在用户无感知的情况下,在多轮会话中更懂用户的特点
当时(2025.12月初)这还是一个非常小众,只跑在论文上的方向,在社交平台上偶尔能够撇见一两篇,但都是浅尝即止
再后来的故事大家都知道,2026.2月的时候Hermes的火爆彻底引爆了这些方向
不过在设计上我们仍然不想把这些东西做到Skill里面去,或者说不做那么深
因为Memory、RAG方向的内容更多的是系统化工程,涉及到非常多的内容,在Skill侧的这两个方向无法真正的走向生产环境,因为Memory需要评估,需要后台运行,有不少公司专门做这个方向的垂类,实际上他以后更多的是一个独立系统,Coding Agent只需要插件式接入他即可。RAG也同样需要评估召回率,准确率,LLM as Judge的内容,还同时需要存在embedding model、处理复杂文档切片
我们可以看到每个方向单独展开都是一大片的内容,在Skill上完整实现没有太多必要,由于市面上做这个方向的开发者对Eval不关注,缺失Benchmark,导致很多工作其实是无效的,有很多顶会论文指出自进化记忆、自进化Skill产出的东西大多数都是不好用的,这仍然是一个值得深入研究的方向
- 跨Agent的团队Harness文件注入
这部分内容可以做的是补全各类Coding Agent缺失的Rule机制,可以采用Hook选择性注入相关的文档,长期来看这个功能对于Coding Agent团队而言规则注入是容易实现的。其实依靠linter能够做到很多事情,比如将规则建立为插件,让不符合规范的文件在编译代码时强制失败,Agent看到报错之后自然能够知道修复,这也是后置规范的一种。
- 关于CLI
我相信很多佬友对于CLI有一个误解,就是做CLI是为了方便安装多个平台的,但其实在Comet中CLI的定位是Runtime/Harness的入口,我们把能够代码化的部分放到CLI快捷命令中,并在Skill内让Agent自己识别需不需要调用某个CLI,来做复杂但需要确定化的东西,比如对Comet的状态进行转化,这样做的好处是我们能够大幅缩减需要在Skill中描述的内容,让需要稳定执行的地方变成了代码,Agent不需要知道过多的信息,只需要了解作用即可。这就好像我们平时在使用电器的时候一样,我们不需要知道电器的具体原理和内部构造,只需要知道按某个地方是开,按另外一个地方是关就可以了。
欢迎贡献
五、最后的最后
Comet非常欢迎各位佬来参与贡献 ^-^,哪怕是文档的改进工作都是可以的,我们希望大家在Comet中能够真正学到在工作中可以用的知识,而不仅仅是切换了一个看起来好用的Skill,如果各位对Comet有疑惑,Just try it,使用/comet 发起Skill做你想做的任何事情
主楼 - 洛卡卡了2026-08-18
大佬 我在用 native 的过程中有个问题,就是如果项目是前后端多个独立仓库的话,放在同一个父目录下面的话,comet 有没有更好的协作方式呢? 我是前后端分别初始化然后各自维护 change 还是可以跨仓库管理呢。这点我还没实践过但是目前没太好的思路。
- 后仰跳投2026-08-18
怎么着?我完整看完还能抢到2楼~~~写的很用心,感觉是个好东西,看的我蠢蠢欲动的,这就踹这就try
- 脚趾剑匣2026-08-18
如果是一个父目录下来有多个git仓库,其实在父目录去初始化comet就可以用了,不过如果需要change跟着某个仓库跑,那么需要在这个仓库中去初始化,尤其是在各自仓库里面有独立演进式的需求的时候,我在开发comet的时候里面有挂载一个gitsubmoudle的git仓库,用于同步一些文档,那个仓库就是没有初始化过comet的,但是comet主目录有初始化过,一般在主目录里面描述要去子目录做的事情也能做到
- 洛卡卡了2026-08-18
感谢大佬解答 晚点我试一下看看效果咋样,还有个情况就是native模式如果针对单文件修改、配置调整或者小bug的时候有没有轻量入口呀?意思就是直接跳过完整的 runtime和归档流程这种。我在使用过程中好像只要用/comet 就会走这样的。目前有更好的方案吗还是我的方法不太对?
- QYY2026-08-18
看起来有点牛啊,我想用那个批量澄清功能
- 灿烂甜菜2026-08-18
佬我感觉你已经站在前沿角度和更长远考虑推出了Comet Native,想问下和Trellis的核心区别和适用场景是什么呢
- 脚趾剑匣2026-08-18
我其实觉得如果太小的调整不需要记录的话直接改就行了,git提交记录就是最好的答案,如果确实是需要记录的,直接告诉native并说跳过澄清,他能够把你的内容记录澄清文档里面,由于验收的内容比较少我理解跑完流程也不需要多少时间,native就是根据前期记录的文档多少当成依据的
- 脚趾剑匣2026-08-18
欢迎体验comet佬,感受下批量澄清的特点~ ^-^
- 脚趾剑匣2026-08-18
佬我没有深度使用过Trellis的skill,所以在Skill上其实我不太了解Trellis,从文档的观感上我觉得Trellis强调的是团队化的规范,有一些共同的观点比如跨设备跨会话的恢复要在Skill侧做,其他的有些类似的技术,比如自动推进等等。其实通过对比文档和具体实现过程我觉得还是能感受到两者的设计仅仅是一些使用技术的类似,想要解决的问题是各不相同的,Comet从诞生开始到后续围绕打造的东西更想要的是科学的通过指标驱动迭代,沉淀可复用的Runtime/Harness、稳定Skill执行链路,这是一套系统工程,这些在大家面向工作场景上时会很有帮助
整体Comet就分为3个部分:
- Comet的Skill部分适合于按需求/功能(Change)推进一项任务,也适合于真实大型PRD拆分型任务,记录相关的文档并保存需求,让Agent在长程任务上能够跑的稳
- Comet的Eval部分适合于评估任意Skill,用指标去驱动Skill的迭代
- Comet Any部分适合于想要组合任意Skill,又不想思考过多的Runtime/Harness技巧,达成类似Comet在长程任务稳定的效果
- 甘尼克斯2026-08-18
