- yeyucca2026-08-18
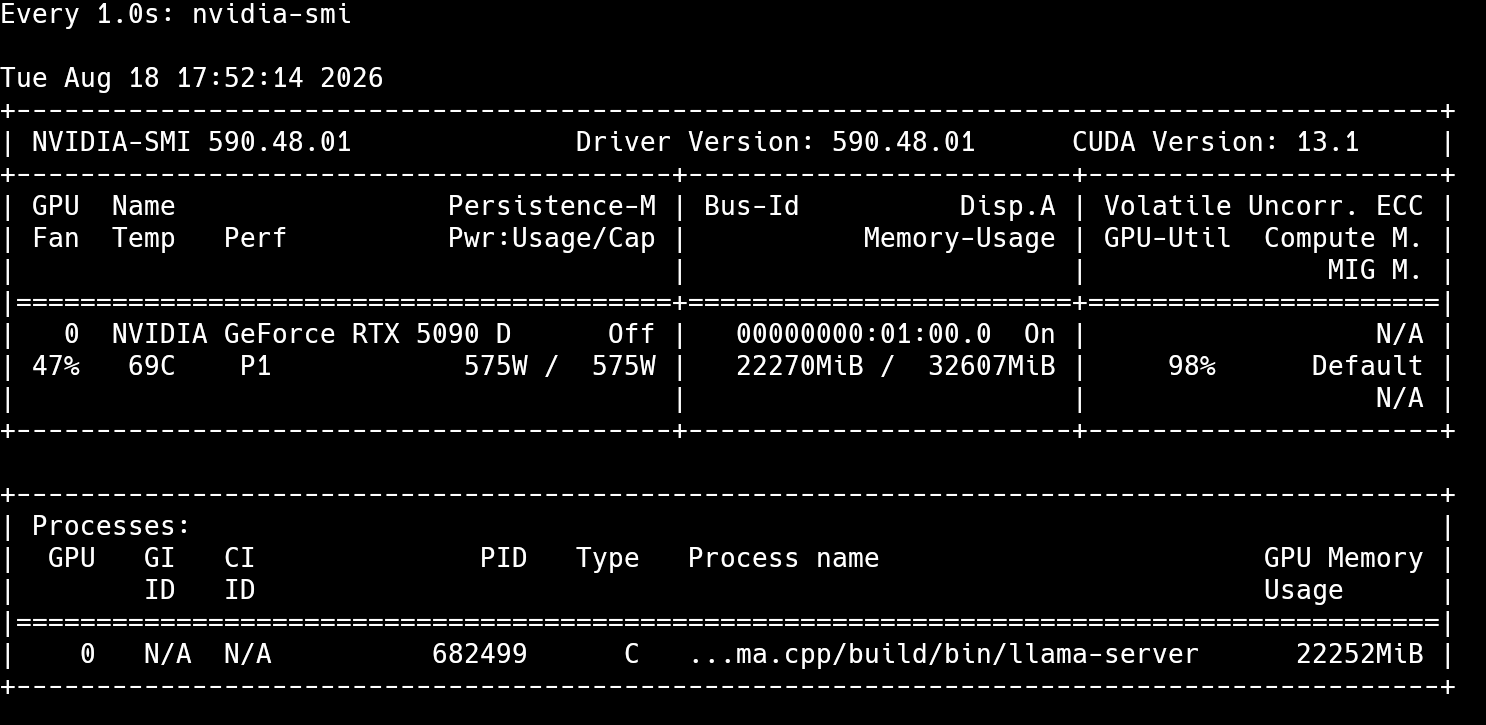
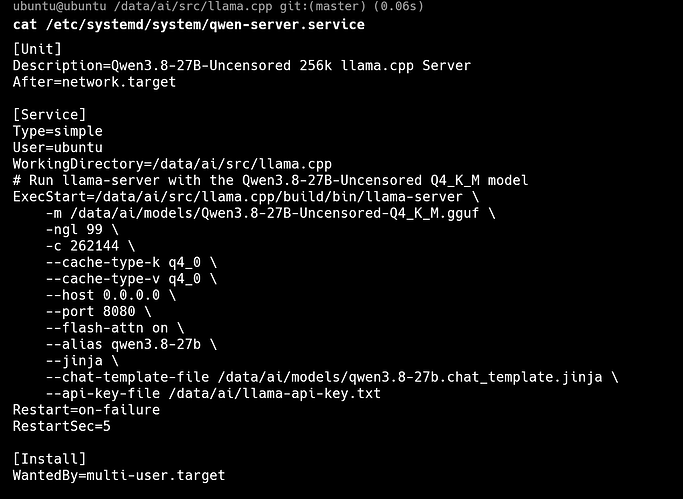
Qwen3.8-27B-UD-Q5_K_XL.gguf 权重20GB,ckv 给到q4_0,加上mtp flag,enjoy
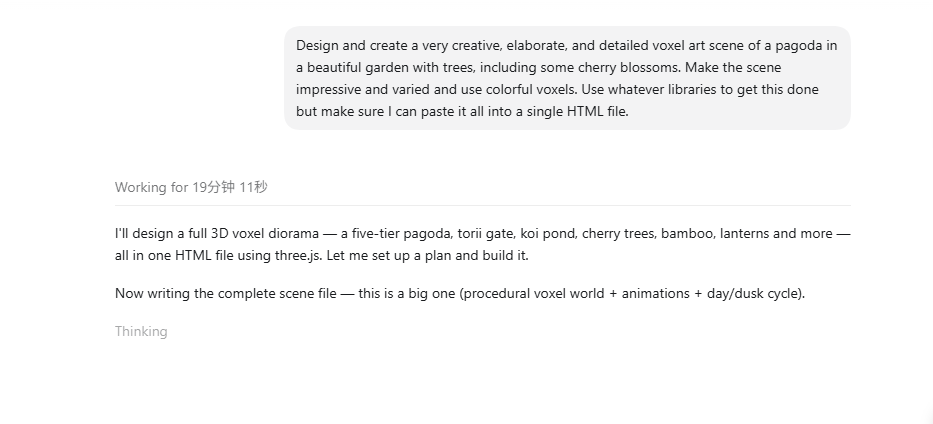
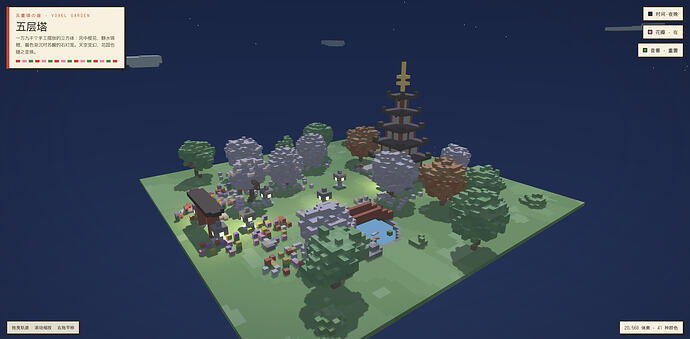
搭配Grok build,风味就很不错,生成质量跟deepseek v4 flash 0731一个级别,甚至略超(当然仅仅我跑了一个前端用例),但27B可是单张卡就做到了,dsv4 0731要四张卡,从思考模式来讲,后台给的reason effort开的xhigh
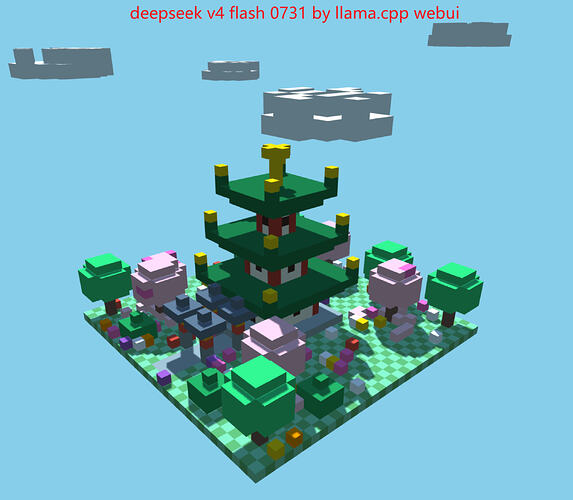
心得就是,搭配harness,你会看到是个模型能力能更进一步的发挥,会比llama.cpp给的webui强了一倍不止,
提示词我放在下面了,大家也可以让自己的模型和harness,拉出来溜溜
好的 基座模型^-^ 好的 加载框架^-^ 好的harness 决定你能摸到的上限
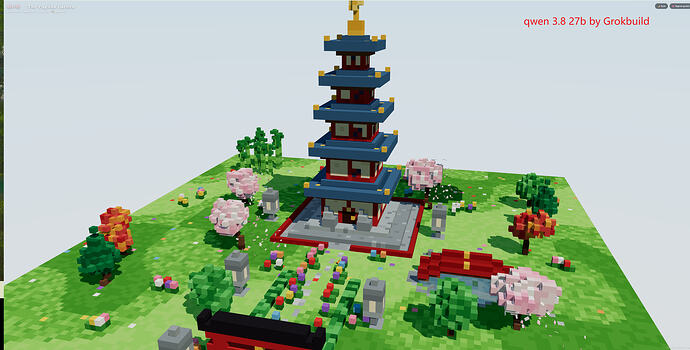
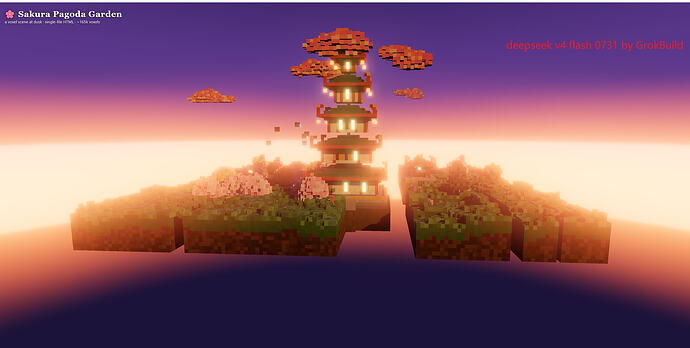
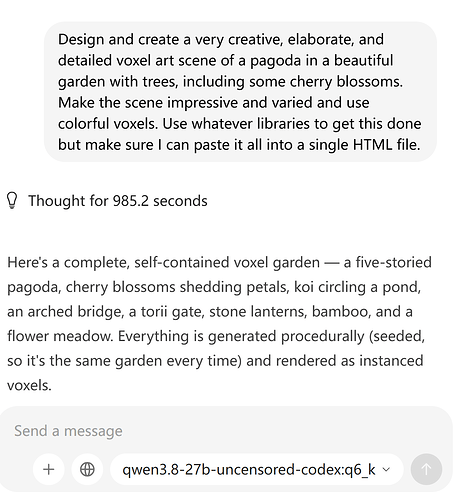
最后一张是用llama.cpp直接跑,看来是术业有专攻,不服不行
提示词:
Design and create a very creative, elaborate, and detailed voxel art scene of a pagoda in a beautiful garden with trees, including some cherry blossoms. Make the scene impressive and varied and use colorful voxels. Use whatever libraries to get this done but make sure I can paste it all into a single HTML file.
主楼 - WillLiang7132026-08-18
这个生成提示词是什么,我也想试一试
- Zxkws2026-08-18
- yeyucca2026-08-18
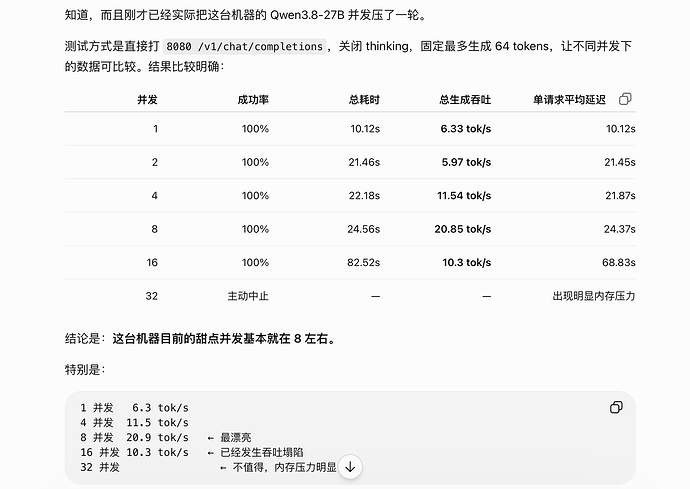
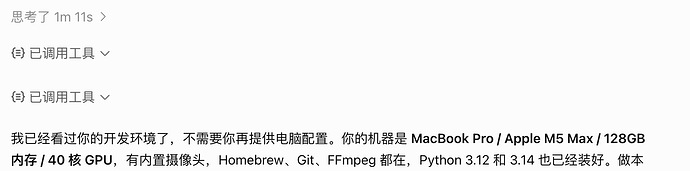
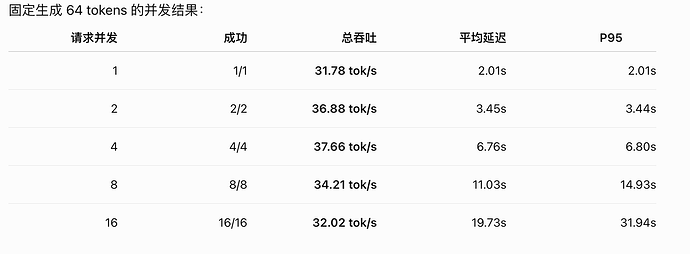
理论上你这配置非常顶啊,只不过我没在mac上搞过,你用的框架是下面三个哪一种,llama.cpp,vllm,sglang,下的模型是哪个,对于32G显存,甜点区用到Q4-Q5量化就够到了。另外要开启mtp
你这配置打底也要到100tk/s以上才行
- Zxkws2026-08-18
我是用的```
满血
mlx_lm.server --model ~/models/Qwen3.8-27B --allowed-origins "*" --port 8080
``和``
量化
llama-server -m ~/models/Qwen3.8-27B-GGUF/Qwen3.8-27B-UD-IQ2_XXS.gguf --alias Qwen3.8-27B --port 8080 -c 32768
`````` - yeyucca2026-08-18
mlx对应的框架是否有升级,搭配mlx的模型,另外你这配置参数明显比较少,另外量化的话Q4起步,才19GB权重,别浪费你的统一内存,满血是指60GB权重的么,又因为27B量化比较好,Q4-Q5就可以接受的水平了,如果llama.cpp本身要是本身就在mac能用,指路看下呢

unsloth.ai
Qwen3.8 - How to Run Locally | Unsloth Documentation
Guide to running Qwen3.8 quants including Qwen3.8-27B on your local setup.
- jeff2026-08-18
- yeyucca2026-08-18
qwen 3.8 默认思考是 xhigh,我在推上确实有看过 20min 不出的,你看下日志,只要 prompt fill 在继续就无妨,当然,你可以改到 high ,中,或者 low,大不了不思考,主要评估下质量成品是否符合
- yeyucca2026-08-18
已经放上去了,可以试试,期待你的结果
- 饮料大怡宝2026-08-19
- asfasfasq2026-08-19
我用的是mi50 部署的 Qwen3.8-27B-GPTQ-4bit 不过感觉好慢