- NaynIruR2026-08-19

inco.ai – 18 Aug 26
DFlash 2: Keep Drafting Parallel
DFlash 2 is the successor to our widely deployed parallel drafter: close to 3× the speed of autoregressive decoding, with the same output. Drafters for Qwen3.8-27B and Meta's Muse Glimmer are out today.
配置是两张5090,官方fp8量化权重+fp8 kvcache
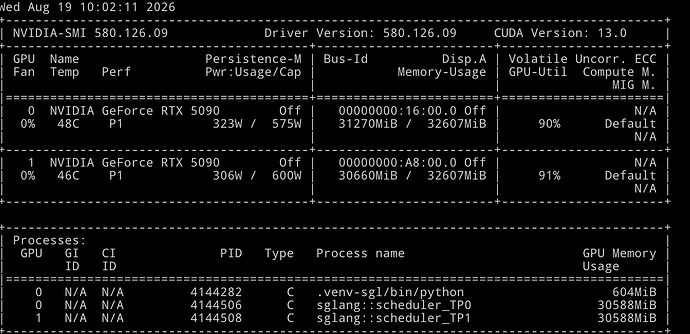
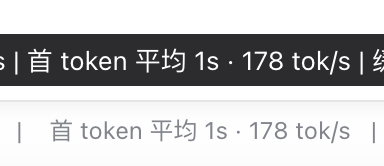
差不多能跑180tps
主楼 - moxiyan2026-08-19
单张5090,dspark,能跑到210左右啊。
- NaynIruR2026-08-19
真假?我DSpark只能跑150tps。是不是统计口径有问题?佬在dsh里试试呢?
- 害你的猪2026-08-19
CUDA_VISIBLE_DEVICES=5 /data_nvme_extra/llama.cpp/build/bin/llama-server \ --alias "Qwen3.8-27B" \ -m /data_nvme_extra/huggingface_models/Qwen3.8-27B-GGUF/Qwen3.8-27B-UD-Q4_K_XL.gguf \ --mmproj /data_nvme_extra/huggingface_models/Qwen3.8-27B-GGUF/mmproj-BF16.gguf \ -ngl 99 \ -c 262144 \ -b 2048 -ub 512 \ --parallel 1 \ --cache-type-k q8_0 --cache-type-v q8_0 \ --spec-type draft-mtp --spec-draft-n-max 3 \ --temp 0.7 --top-p 0.9 --top-k 20 --min-p 0.05 \ --jinja --host 10.1.1.125 --port 8000 ```我5880ada单卡,跑量化版,开mtp,速度也只有70t/s,不开mtp速度只有40t/s 求优化 - Yunfei_Chen2026-08-19
为了跑个27b模型,一个月花费差不多1000多(电费+硬件损耗),还没算两张5090主机的成本,佬真有钱.
- diff2026-08-19
40系显卡是不是无缘这个Dflash2?
- NaynIruR2026-08-19
自带的mtp好像就是很慢,换dflash或者dspark试试?
- NaynIruR2026-08-19
实验室的,大家都在用H100,5090没人用,不用白不用 ^-^
- moxiyan2026-08-19
需要调试,配合sglang,你让gpt来就行了。哦对了,我用的是nvfp4,可能差距在这。
- NaynIruR2026-08-19
我手动调过,佬能分享一下配置吗?
- NaynIruR2026-08-19
我也用过nvfp4,性能和fp8感觉差不多啊