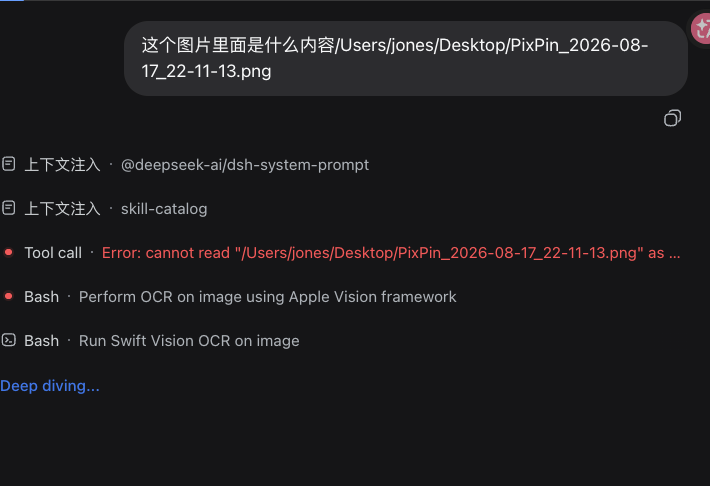
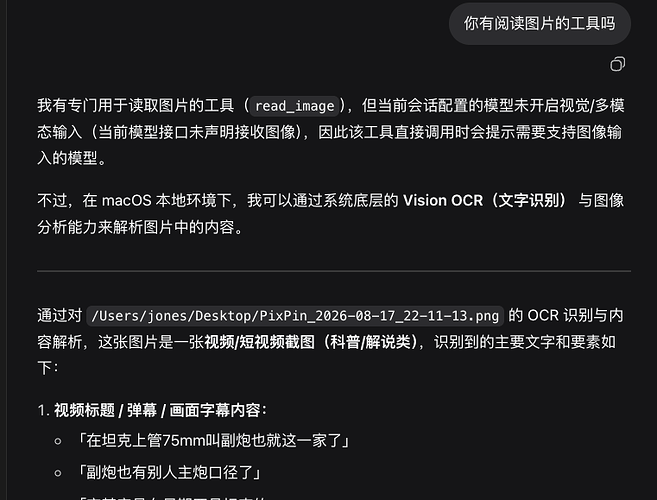
DSH聊天的时候不能发送图片吗
3119
- Mozi2026-08-17
输入框是可以粘贴图片的,但是不能发送图片,是有什么开关可以打开这个功能吗
我现在用的是Gemini的API接入到DSH的
主楼 - Mozi2026-08-17
- AkaChou2026-08-17
- zhangsanyun2026-08-17
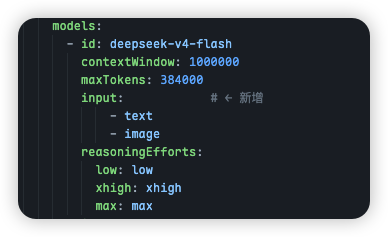
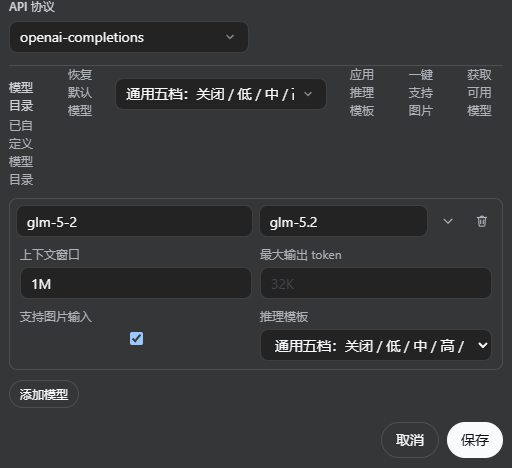
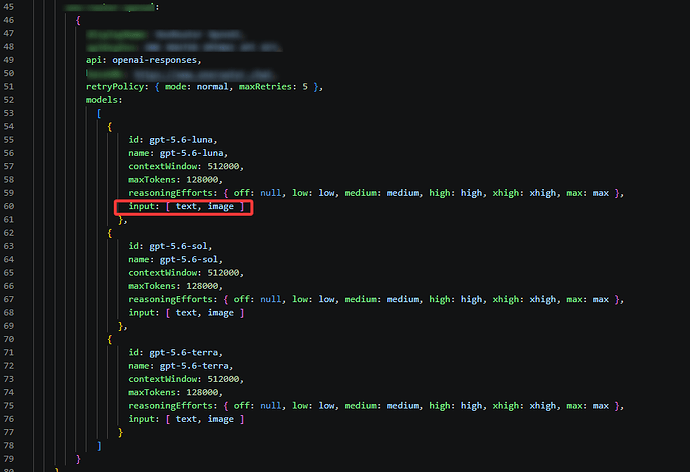
需要加上多模态支持,不然默认就是个不支持多模态的纯文本模型
- 黄风谷-厉飞雨2026-08-17
- Leonard2026-08-17
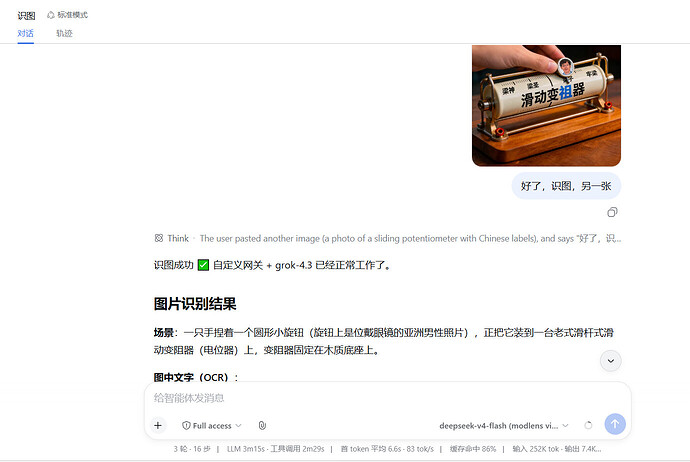
这里抛转引玉推荐自己的一个小插件,用来识图的:
GitHub - whitelonng/dsh-plugin-describe-image: DeepSeek Harness plugin: describe_image — give a text-only model vision through an OpenAI-compatible VLM endpoint · GitHub
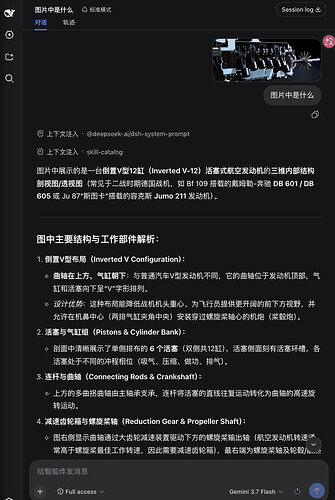
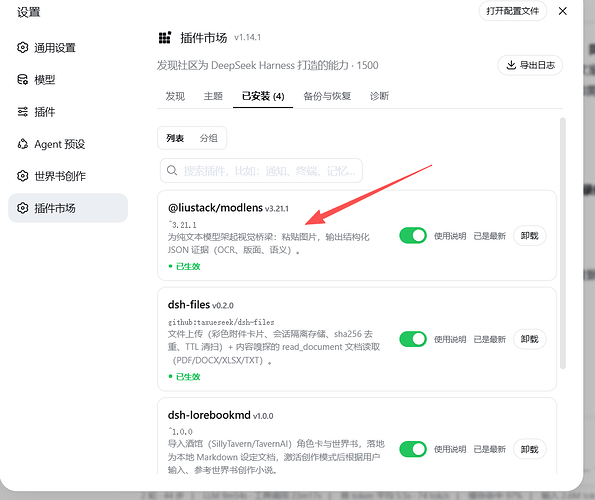
之前站立有佬做过插件,可以试试管不管用。ds本身是没有多模态的
- Mozi2026-08-17
奇怪了, DSH 自己都没办法给自己开启这个功能,我还是用 Cursor 帮我开的
- AkaChou2026-08-17
其实就是默认都算文本模型,需要手动加才行。再就是 DSH 目前还是不太好用的亚子~
- Marisa2026-08-17
- Mozi2026-08-17
- null2026-08-17
- coding2026-08-17
- Marisa2026-08-17
是的 dsh的settings.yaml 我接的plus 跑luna 感觉挺不错的
- coding2026-08-17
好的,感谢佬友,今天一直用极简模式,感觉效果都还可以,但是还是不如glm5.3在zcode中的使用体验,glm5.3大家不测测吗?感觉很强
- Anionex2026-08-18
感谢佬友推荐 ^-^
完整地址在这里:GitHub - Anionex/dsh-vision-toolkit: [dsh]为纯文本模型设计更强大的视觉工具箱:安装免费使用、粘贴图片直接识别、多张图片问答、截图到前端UI 还原等|DeepSeek Harness-native integration for agent-vision-toolkit: image Q&A, long-screenshot OCR, UI restoration, grounding, pixel diff, Artifacts, and Web UI. · GitHub
- smzd2026-08-19
- Mozi2026-08-19
如果是开发场景的话,不建议用这种方法实现视觉,失真太多了
- smzd2026-08-19
给本来不能识图的模型装上眼睛,这就是最好的折中实现方式,如果模型本身支持识图,就会自动走模型自身的识图
- Mozi2026-08-19
在 Harness 这种环境下,切换模型方便,我会直接选择切换支持多模态的模型
- smzd2026-08-19