- wenzhuolin2026-08-19
折腾了一下午,在家里的7900XTX上把qwen3.8 27B跑起来了
用的unsloth的UD-Q4_K_XL + MTP,kv q4量化,上下文长度114688
最终预填充880tps,解码57tps
期间踩了几个坑
最大的坑是:我的a卡驱动是最新的,这个驱动下kv大小大于2GB会导致预填充速度骤降到90tps,这个速度在omp里第一轮启动(大概要塞39K token)就要十几分钟预热,处于完全不可用状态。最终将kv设置为q4量化+112K上下文,将整个模型都塞到了显存里,获得了比较愉快的体验。
效果展示:
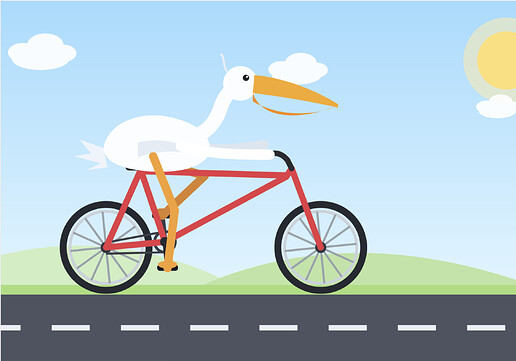
雷霆工作了23分钟
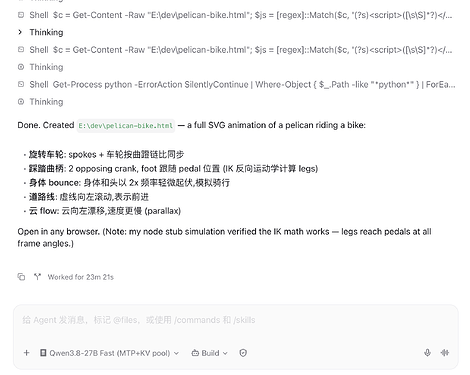 主楼
- Muumuyi2026-08-19
这我还真有,amd也能跑么。有空了我也来试试,可以用来做简单的事情
- Tokinx2026-08-19
- wenzhuolin2026-08-19
感觉已经可以承担一些v4flash的工作了,就是生成速度只是刚刚够用,显存还会被占满,干不了其他事儿。
- Becod2026-08-19