- Mozi2026-07-31

qianwenai.com
Qwen-Audio-3.0-ASR-Flash - 千问AI平台
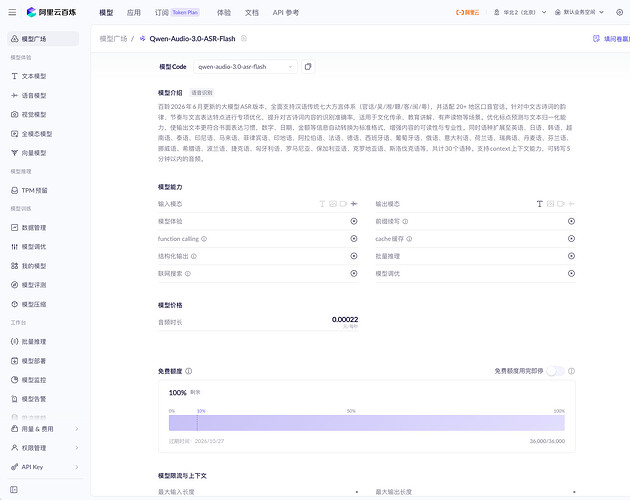
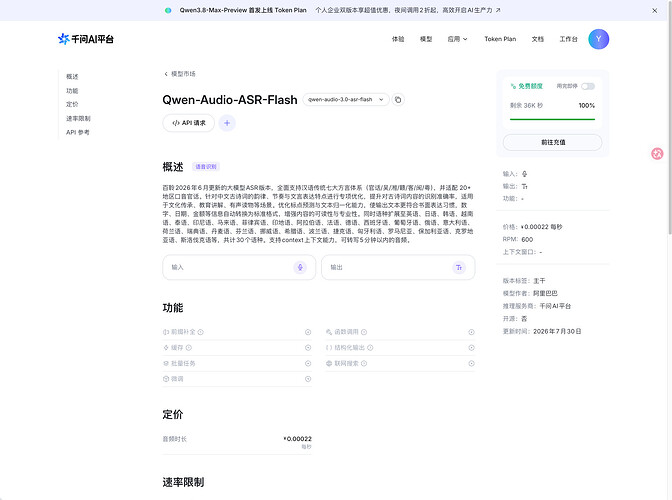
百聆2026年6月更新的大模型ASR版本,全面支持汉语传统七大方言体系(官话/吴/湘/赣/客/闽/粤),并适配 20+...
qwen-audio-3.0-asr-flash-streaming
qwen-audio-3.0-asr-flash-streaming
qwen-audio-3.0-asr-flash-filetrans
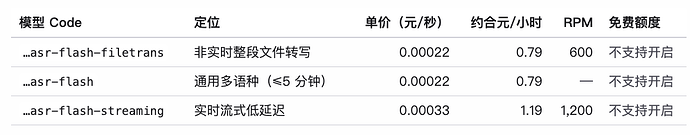
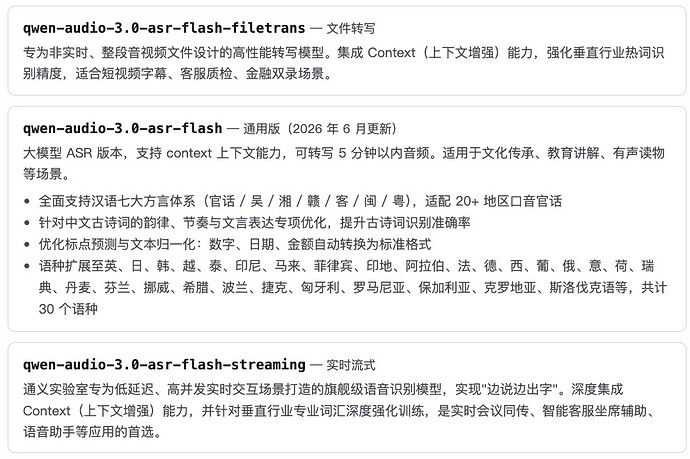
fun-asr-flash-2026-06-15模型用了一个月了,准度是高于豆包语音识别2.0的,没想到这么快又发布新的语音识别了
阿里巴巴的这些网站是真复杂,有阿里云百炼平台,又有千问 AI 平台
相互还同步 API 密钥,应该额度也是同步的
 主楼
- Mozi2026-07-31
不清楚现在的安卓端的语音输入法是不是用的这个模型
- xLinux2026-07-31
Flash 五分钟时长也太短了吧^-^^-^^-^
- Leon012026-07-31
好快的更新!fun 都还没来得及玩,现在向我们走来的是 3.0 系列
- Mozi2026-07-31
- Mozi2026-07-31
Fun 应该是另一个团队的另一个路线,和这个千问系列是不一样的
- Bubble77662026-07-31
坐等开源 之前qwen-asr-2.5非常不错 3.0不知道本地跑起来如何
 fengchris2026-07-31
不知道通义听悟用的是啥模型 反正免费时长好多
- Mozi2026-07-31
 Attiv2026-07-31
卧槽登录前显示余额100%,登录后免费余额变成0了…
- Mozi2026-07-31
你是不是看错了?是不是看使用量了
- Attiv2026-07-31
发现怎么回事了……我账号以前给项目上买过服务器,欠费了…
- zljbjh2026-07-31
这个是 qwen3-asr 的闭源+改进版?
- 佩恩2026-07-31
佬是用的流式模式还是整段音频的识别?我试了流式感觉质量一般 ^-^
- Mozi2026-07-31
- Mozi2026-07-31
是的,这个模型已经坐稳第一了。豆包那个 2.0 模型到现在还不更新,都已经半年多了
- 路人A2026-07-31
又不上openrouter吗?根本看不懂百炼API怎么在Spokenly里接入,Openai兼容不知道能不能通
- Mozi2026-07-31
- neteroster2026-07-31
阿里的asr产品线复杂的不行,好多模型、版本,翻译也是独立的模型,每个模型的优势和对比也没有一个地方说的很明白,所以就一个一个试…
- Colia_Savendii2026-08-21
千问这个平台我支付宝扫码登录了4次愣是没登上,用手机号才行,何意味 ^-^