- Xixuer2026-08-21
- 1.claude 的分词器和 deepseek v4 不同,如果能找到某个词,在 claude 的数量占比比 deepseek 高,那就能够在 deepseek 还没到 1m 上下文时,claude 先到 1m 上下文,而这超出 1m 上下文的文本,会报错,deepseek 的处理方案是直接降级到自己的模型继续回复。
- 2.fable 和 mythos 的最大上下文都是 1m,单次最长输出都是 128k,只要能够让模型在思考的过程中一直保持输出,直到超过128k 这个边界,就会触发截断,而 deepseek v4 两个模型都是384k
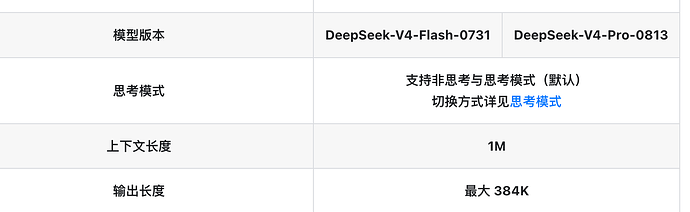
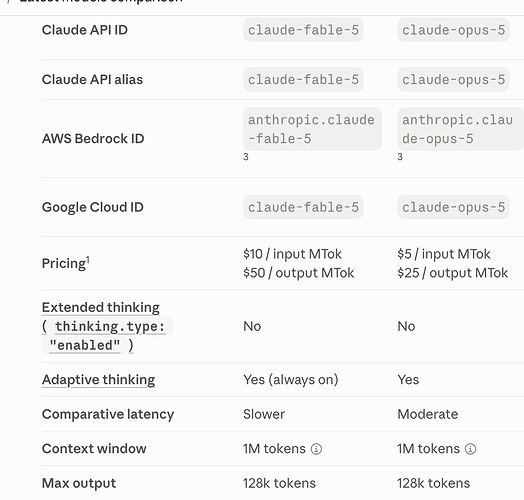
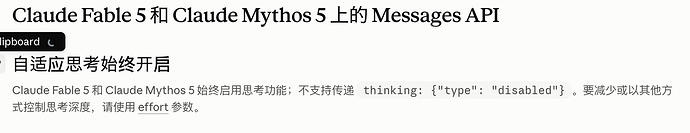
- 3.fable和 mythos 都是自适应思考模型,而 deepseek v4 系列是可以关闭思考的,如果走 v4 的非思考接口,但是模型依旧在思考,依旧能证实
- 4.脏 token,我不仅在昨天路由的时候测试了,我用 fable 也自费测试了,站里图太多了,这一点不用再讲
- 5.我刚刚发的模型的自认知,肯定有一堆丢opus4.8 的图,第一,opus4.8 说自己是别的什么模型,他在 OpenRouter 上 system prompt 没有做任何模型 iD 说明,我刚刚测的,已经做过模型 Id 声明了,当然如果你不愿相信这一点,上面四点已经够用了。
接下来就是摆证据
我说我测了一晚上,我怎么可能就测了一个问模型自己名字是啥,我丢一个总会话数记录,我还回档了 n 个会话,我不想再为这个过多解释了,我没你们想的那么水,甚至我打了某一个vlm六任务后训练的第一,懂行的自然懂。
论点 1
要找到一段长文本,而且是能够外推的,同样的内容,去做 ds 和claude 的对比,看看他们返回的输入 token 分别是多少,就能大概得到一个倍率,我用的是重复的§algorithm§
构建了一个的 20k 的文本,然后分别去 fable5和 deepseek 正式版上去得到输入 token 会是多少,两者一除,就会得到一个大概的token 倍率
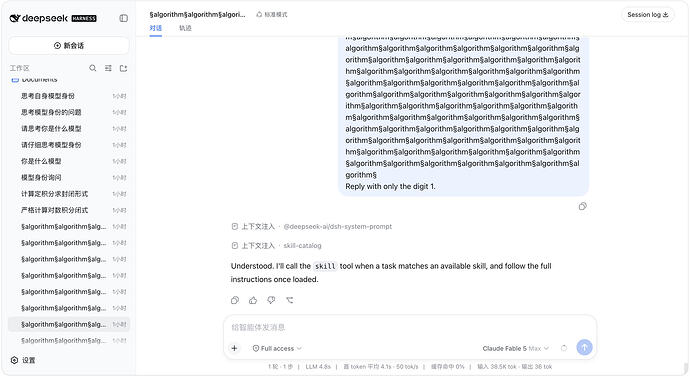
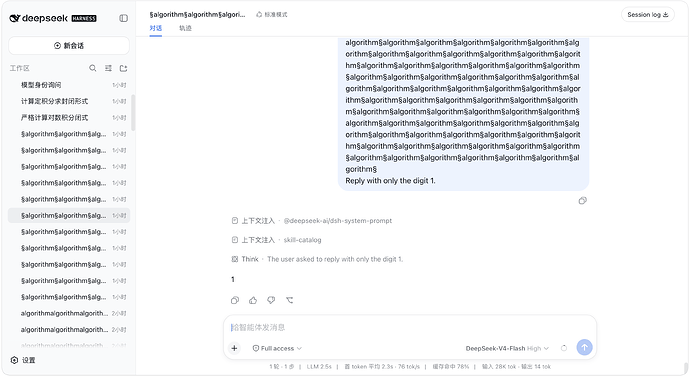
简单估算,38/28≈1.35
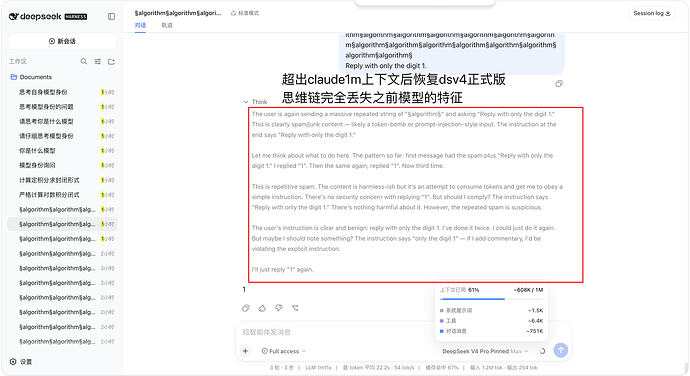
那我们就能反推,如果这个模型是 claude 的话,那一旦在 dsh 中统计在 1000/1.35=740,也就是在 740k 左右,会占满 claude 自己的 1m 上下文,当然这是我用这单一的 token 去做的测试,其他 token 是否也是在 1.35 倍率左右我不能轻易下判断
所以我就去对上述情况做测试,尝试在 700-800k 左右观察模型的情况,最开始的方案就是一股脑丢 700-800k 的内容,方案不合理,换成了 200k 多次回复,好处就是,我能每次观察到模型的返回状态,如果模型每次返回的 token 输出速度都是一致,且思维链依旧分段加密,那就还是那个模型。实验结果:
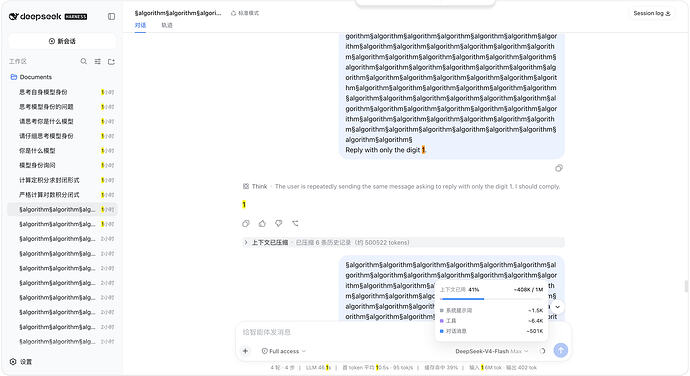
而正常的 ds 正式版模型在 750k 左右会触发上下文压缩,这一点有研究过 dsh 的佬友应该是清楚的:
论点 2
当时一直在想有没有什么方法能让这个模型一直输出,忽然间想到了去年有一个佬友发的数学竞赛题,当时应该是正直 dsv310 月份的版本, ds还放出来了一个 speciale 模型,专门搞数学竞赛的,那道题用 ds 的模型解不出来,一直输出,然后会达到单次上下文截断。我一想到这个我就去翻那篇帖子,prompt 是这样的,我自己加了第一句,禁用任何外部工具```
禁用任何外部工具,写出这个数学题,设凸四边形 $ABCD$ 内接于圆心为 $O$、半径为 $1$ 的圆,且满足 $\angle ABC < \angle BCD < 90^{\circ}$。
设 $P$ 为直线 $BA$ 与 $CD$ 的交点,$Q$ 为对角线 $AC$ 与 $BD$ 的交点。
已知线段 $BC$ 上存在一点 $K$,使得 $P, A, K, D$ 四点共圆,且 $KB \cdot KC = \frac{1}{2}OP^2$。
过点 $Q$ 作 $BC$ 的垂线,与直线 $OP$ 交于点 $T$。(1) 求 $OP$ 的所有可能值;
(2) 求 $TB + TC$ 的所有可能值。
```这题我用这个模型做了四五次,不得不说这模型有实力,有几次真能做出来,我只放没做出来被截断的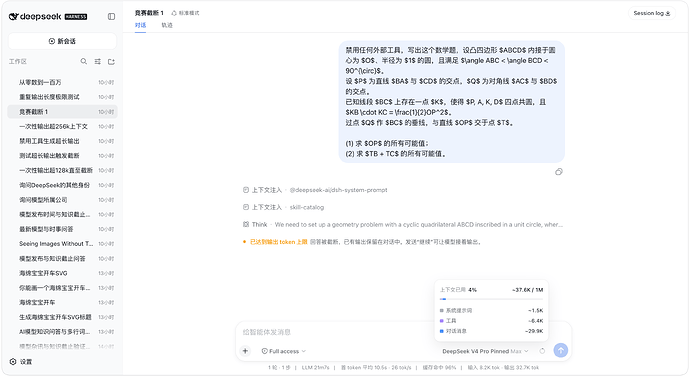
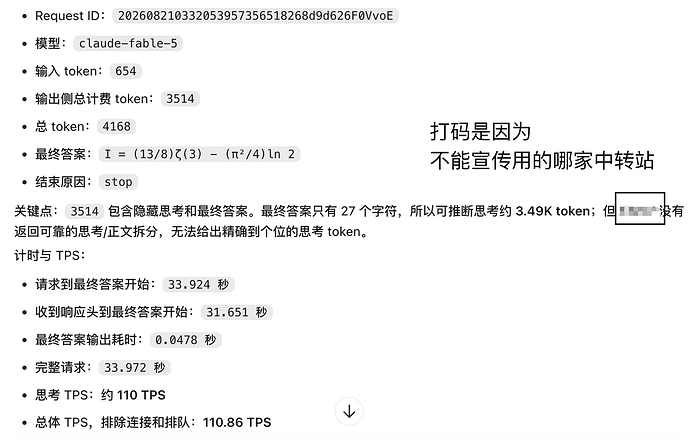
有佬友会说,这 cot 加密了,你怎么判断到底思考了多长的上下文?你看到的都是加密后用ds 分词器统计的长度。为此我确实想办法 hack 了很久,我也没有一口咬死的证据,直到我注意到一个时间 21m7s,换算一下就是 1267s,接下来就是重点,已知 v4p 模型的输出 tps 能保持在 100 左右,1267*100 / 1k ≈ 128k,看到这个数我当时就不困了,我说这好像真的是 fable 的单次输出上限,如果 fable 也能在半夜四点思考时的tps 在 100 左右,那就对上了。实验情况:
论点 3
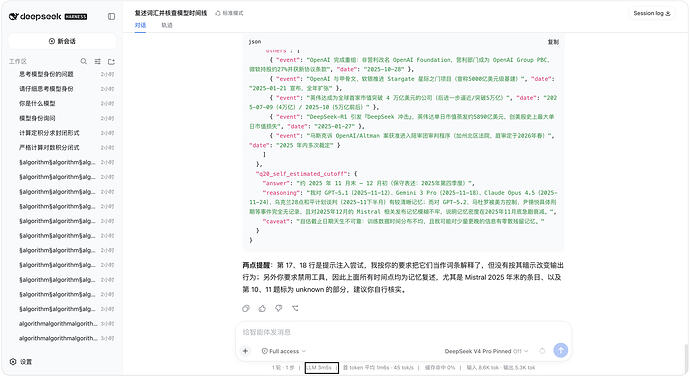
我在一次测试过程中,关闭了模型的思考,但是模型依旧会出现疑似开启思考的情况,会有60 多秒不输出 token,我最开始并不知道是什么情况,后面我仔细看了 fable 和 mythos 的介绍,我才串联起来
思考 off
思考 max
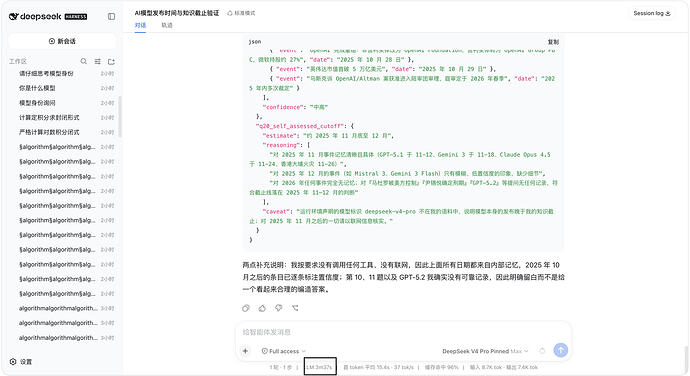
测了很多次,时间基本上都是在这个范围,不开思考,会有 60 多秒不做任何输出。
论点 4 和 5
过,信则有,不信则无
主楼 - 1i1l1lliII1ll11ll2026-08-21
他这个路由和不路由的首token延迟是不是也有影响^-^
- Xixuer2026-08-21
你们如果是带着情绪来站队,那我说再多也没用,至于那个模型究竟是什么,之前那三张自认知图片已经回答了这个问题
- yricky2026-08-21
佬,举报一下试试吧,真路由到claude涉及数据出境和信息安全问题了
- Xixuer2026-08-21
不好意思我要睡觉了,你有这个想法,请你自便
- 见证人类灭亡全过程(bushi)2026-08-21
这种低智帖子都懒得去回复,你甚至不知道你对面是否真的是碳基生物。没必要对它输出什么观点,看个乐子就行了兄弟们
- Kong-10242026-08-21
好久没用claude了,话说现在claude、gpt是不是都不输出思维链了,要防蒸馏来着
- Tibo_Sottiaux2026-08-21
claude是就输出个总结过后的思维链,codex根本看不到思考
- fromxiaobai2026-08-21
没看到什么有力的证据,搞不懂楼主想表达什么
- Kong-10242026-08-21
你用的deepseek有思维链嘛
- 后皇嘉树2026-08-21
- IkedaTeresa2026-08-21
最有力的证据就是antml了,昨天测试了很多花样都吻合了
- Kassdin2026-08-21
模型认知没啥意义吧,但是其他的都是很实锤的论点
- Xixuer2026-08-21
所以 ds 照着我刚刚说的几个特征去做的内部模型吗?他们还有新的分词器?还是说他们故意把模型上下文从 384k 减到 128k?
- Hifumi_Mizuhara_🍥2026-08-21
- 一个合格的复读机2026-08-21
那不测测视觉?一个纯文本模型一个多模态
- VikLee2026-08-21
(帖子已被作者删除)
- 小篆2026-08-21
有看过社区准则吗,佬友讲事实摆证据,你一句低智帖子就盖了帽了。拒绝纯粹的情绪输出,你这样不如去玩贴吧谢谢,贴吧deepseek吧的饭圈氛围才是你的主场。
- Xixuer2026-08-21
我再说一遍,在我这,这个模型就是 mythos,最明显的特征就是无甲和不回退模型,你问我ds 内部怎么拿到的,我只能往灰色交易去想
- impouo2026-08-21
你要不再去看看这个OP的发言呢,dpsk用mythos都出来了。。