- arthas2026-08-21
前提
目前有一台机器,里面有4张L20的卡,其中有三张已经有其他用途不能动,驱动无法升级,现在想剩下其中的一个卡来试试部署 Qwen3.8-27B-FP8,部署步骤参考:

recipes.vllm.ai
Qwen/Qwen3.8-27B — 27B · DENSE · 256K ctx
27B-parameter dense hybrid-attention model with linear attention on 48 of 64 layers, a vision tower, a built-in MTP draft head, 262K native context window and extensible to 1M context
目前遇到的问题
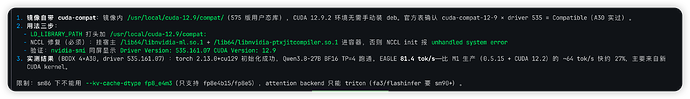
我的驱动是 Driver Version: 535.216.03 CUDA Version: 12.2
目标模型需要
vllm >= 0.17.0,而该版本的 vLLM 官方预编译包依赖CUDA 12.9或CUDA 13.0的 PyTorch 环境,与现有的CUDA 12.2环境不兼容 。由于不能升级驱动,咨询一下各位大佬有什么解决思路或者其他部署的方式吗
报错日志```
(vllm_fix1) [root@gpu-l20-10 ~]# CUDA_VISIBLE_DEVICES=1 vllm serve /data/model/qwen/Qwen--Qwen3.8-27B-FP8/snapshots/master \
--served-model-name Qwen3.8-27B-FP8 \
--tensor-parallel-size 1 \
--max-model-len 65314 \
--kv-cache-dtype fp8 \
--reasoning-parser qwen3 \
--port 8088
Traceback (most recent call last):
File "/root/miniconda3/envs/vllm_fix1/bin/vllm", line 4, in <module>
from vllm.entrypoints.cli.main import main
File "/root/miniconda3/envs/vllm_fix1/lib/python3.11/site-packages/vllm/__init__.py", line 14, in <module>
import vllm.env_override # noqa: F401
^^^^^^^^^^^^^^^^^^^^^^^^
File "/root/miniconda3/envs/vllm_fix1/lib/python3.11/site-packages/vllm/env_override.py", line 90, in <module>
from vllm.utils.torch_utils import is_torch_equal, is_torch_equal_or_newer
File "/root/miniconda3/envs/vllm_fix1/lib/python3.11/site-packages/vllm/utils/torch_utils.py", line 72, in <module>
PIN_MEMORY = is_pin_memory_available()
^^^^^^^^^^^^^^^^^^^^^^^^^
File "/root/miniconda3/envs/vllm_fix1/lib/python3.11/site-packages/vllm/utils/platform_utils.py", line 45, in is_pin_memory_available
from vllm.platforms import current_platform
File "/root/miniconda3/envs/vllm_fix1/lib/python3.11/site-packages/vllm/platforms/__init__.py", line 277, in __getattr__
_current_platform = resolve_obj_by_qualname(platform_cls_qualname)()
^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
File "/root/miniconda3/envs/vllm_fix1/lib/python3.11/site-packages/vllm/utils/import_utils.py", line 109, in resolve_obj_by_qualname
module = importlib.import_module(module_name)
^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
File "/root/miniconda3/envs/vllm_fix1/lib/python3.11/importlib/__init__.py", line 126, in import_module
return _bootstrap._gcd_import(name[level:], package, level)
^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
File "/root/miniconda3/envs/vllm_fix1/lib/python3.11/site-packages/vllm/platforms/cuda.py", line 23, in <module>
import vllm._C_stable_libtorch # noqa
^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
ImportError: libcudart.so.13: cannot open shared object file: No such file or directory主楼 - acai2026-08-21
能用cuda12.2重编译vllm及其依赖吗,或者转llama.cpp跑gguf
- arthas2026-08-21
感谢提供思路,两个方式我都去尝试试试。
- acai2026-08-21
GitHub - fengwm64/vllm-cuda126-builder: Auto-build vLLM Docker image with CUDA 12.6 via GitHub Actions · GitHub 有支持低版本cuda的构建项目,可以试试能否降到12.2
- flymyd2026-08-21
1、你可以尝试安装CUDA12.9,官方文档里说了:
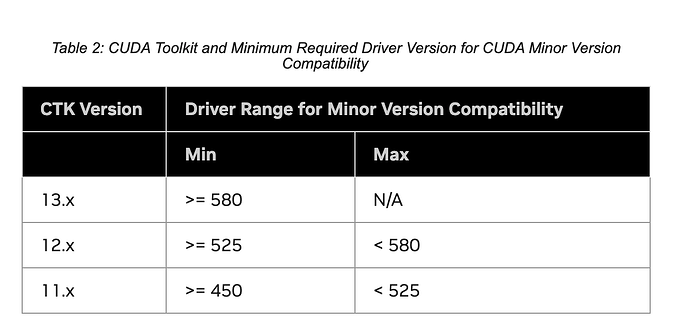
一个机器里是可以存在多个CUDA的。如果你怕捅出篓子,那就拖docker。
2、如果真的不行,那就只有挂好代理,然后拖VLLM源码进行编译试试:

docs.vllm.ai
Build wheel from source - GPU - vLLM
vLLM is a Python library that supports the following GPU variants. Select your GPU type to see vendor specific instructions:
- asxix2026-08-21
- zhiqing-linuxdo2026-08-21
换sglang吧,sglang现在支持dflash2比vllm好
- arthas2026-08-21
- Light2026-08-21
实在不行开iommu,pcie passthrough,把第四张卡给到虚拟机里,虚拟机装新版驱动。
- JeremyGE2026-08-21
当然是一张机器上装两个cuda啦,只有指明你12.9的环境变量才能用你12.9的。另外,vllm最好还是用镜像启动容器服务
- 董炸淘2026-08-21
- 长夜2026-08-21
有且只有拉docker一条路。其他任何方案都别尝试——不然其他三张卡正在跑的玩意炸了你等着被追杀就完事了。
- dovelie_z2026-08-21