- xhz2026-08-21
起因是我要做一个识别商品图片的东西,需要选个模型。翻了一圈榜单,越看越没底——
榜单上分数接近的几个模型,真跑起来差别大得离谱。索性自己搭了个评测器,
拿手头的照片挨个测。
测完发现好几件事跟我预想的完全不一样,有些模型收到图片之后,不报错,也不拒绝,它直接把图扔了,然后编一个答案,离大谱
用的什么图
7 张,全是手机随手拍的
旁边货架上别的东西入镜、包装破破烂烂、有的还反光
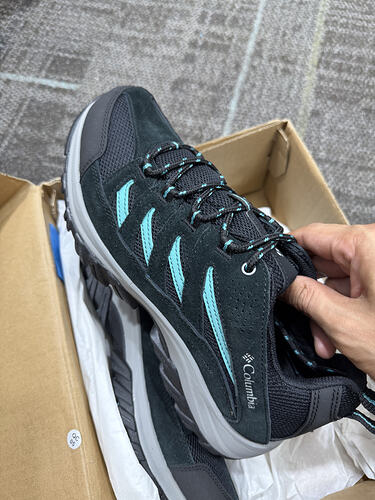
- Columbia 女款徒步鞋(鞋是裸的,没盒没标签)
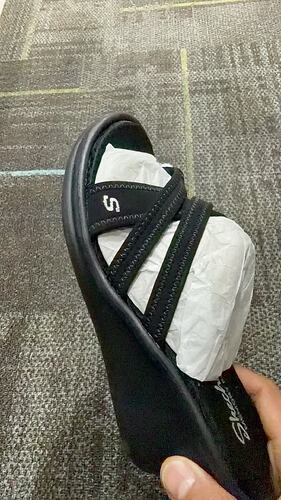
- Skechers 坡跟凉鞋(同上)
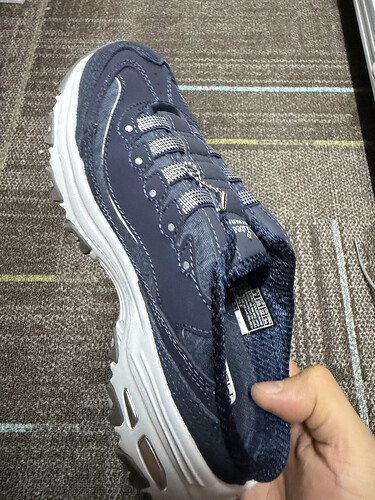
- Skechers D’Lites 深蓝色(这张是关键,图上一个字都没有)
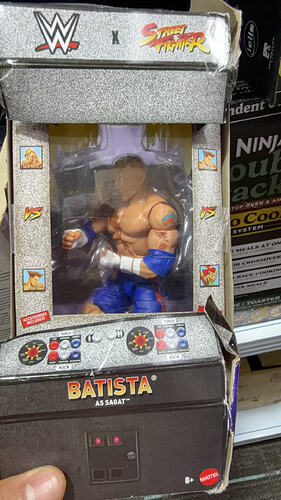
- Mattel 出的 WWE × 街霸联名人偶(盒子压坏了)
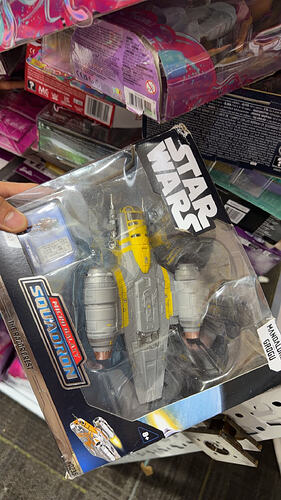
- 星战 Micro Galaxy Squadron(要读出编号 #0235)
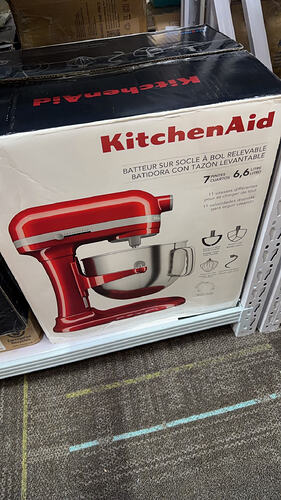
- KitchenAid 厨师机(规格信息密集:6.6L、11 档、红色)
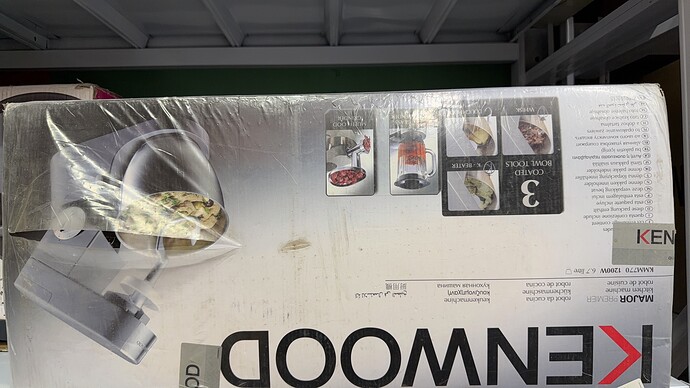
- Kenwood 厨师机(型号印在箱子上:KMM770 1200W 6.7L)
第三张那双鞋是整套题里最难的。图上没有任何可读文字,模型只能靠自己脑子里
有没有见过这双鞋。后面会看到,就这一张把各家的差距拉得清清楚楚。
图我一并传了,想自己跑的可以直接拿去用。
测四个东西
品牌和型号是基本项,认得出就行。真正想测的是后面两个。
规格提取。 很多模型能答对「KitchenAid 厨师机」,但你问它多大容量、几档,
它就答不上来了。品牌型号全对,
specs字段空空如也。这在很多场景里是致命的——同一个品牌不同容量的东西,完全是两回事。
所以我给每张图标了几个必须答出来的属性:```
Columbia 徒步鞋 / 女
D'Lites 老爹鞋 / 深蓝
KitchenAid 6.6 / 11 / 红 ← 容量、档位、颜色
Kenwood 1200W / 6.7
```七张图一共 16 个点,看模型能命中几个。中文俗称。 这个是我做到一半才加的,加完之后整个排名都变了。
Skechers D’Lites 这双鞋,中文网上大家管它叫「熊猫鞋」。你要是答
「Skechers D’Lites」,从语义上讲一点毛病没有,但这不是中文用户嘴里会说出来的词。
模型知不知道「熊猫鞋」这三个字,反映的是它到底吃了多少中文语料。
这个东西英文榜单上永远测不出来。
打分就是很土的字符串匹配,把模型返回的 JSON 拍平成一个字符串,看关键词在不在里面:```
def score(out, truth):
blob = json.dumps(out, ensure_ascii=False).lower()
b_ok = truth["brand"].lower() in blob
m_ok = (truth["model"] is None) or truth["model"].lower() in blob
hits = sum(1 for f in truth["key_facts"] if f.lower() in blob)
terms = " ".join(out.get("cn_search_terms") or []).lower()
t_ok = all(g.lower() in terms for g in truth.get("good_terms", [])) or None
return b_ok, m_ok, hits, t_ok
```土是土了点,但够用。还有一项是连测四次看稳不稳。这项是被逼出来的,后面讲。
测了哪些,怎么调的
统一的 prompt,强制输出 JSON,图片统一 1400px:```
PROMPT = """识别图中【被拍摄的主体商品】,忽略背景中其他商品。严格只输出JSON:
{"brand_en":"","brand_cn":"","category":"","model_no":"",
"model_source":"read|inferred|unknown","specs":{},"condition":"",
"cn_search_terms":[]}
cn_search_terms 为中文互联网上该商品最常见的 2-3 个叫法。"""
```八个模型:qwen3.8-max、qwen3-vl-plus、qwen3-vl-flash、qwen3.7-flash(都在百炼),deepseek-v4-flash-vision-exp(DeepSeek 官方),kimi-k2.6(聚合平台),
gpt-5.6(第三方中转),mimo-v2.5(小米)。
有三个模型必须手动关思维链,不关根本没法用,这个坑后面单独说。
成绩
模型 |
品牌 |
型号 |
规格 |
俗称 |
稳定性 |
速度 |qwen3.8-max |
6/7 |
6/7 |
15/16 |
3/4 |
4/4 |
3.4s |deepseek-v4-flash-vision-exp |
6/7 |
6/7 |
8/16 |
1/4 |
4/4 |
1.4s |qwen3-vl-plus |
6/7 |
6/7 |
15/16 |
3/4 |
2/6 |
3.1s |qwen3-vl-flash |
5/7 |
6/7 |
14/16 |
2/4 |
0/6 |
1.6s |qwen3.7-flash |
6/7 |
6/7 |
13/16 |
2/4 |
4/4 |
2.5s |kimi-k2.6 |
5/7 |
5/7 |
13/16 |
2/4 |
4/4 |
2.7s |gpt-5.6 |
6/7 |
5/7 |
12/16 |
— |
— |
18.1s |mimo-v2.5 |
5/7 |
5/7 |
11/16 |
— |
0/4 |
7.2s |品牌那一列大家都差不多,五六个都对。真正分出高下的是后面几列。
没字的鞋,把差距全暴露了
就那张 D’Lites,各家的表现:
mimo-v2.5 我测了四次,四次给了四个不同的品牌:Fila、Nike Air Max 95、
New Balance 530、New Balance ML574。**四次四个答案,一次都没对,而且每次都答得
特别肯定。**
gpt-5.6 认出是 Skechers,但说不出系列。
qwen3-vl-flash 认对了,然后在搜索词里给我编了「Dunkie鞋」「Dunkel」「DKS老爹鞋」
——这几个词压根不存在。
qwen3.8-max 和 deepseek-vision 是唯二答出「Skechers D’Lites,俗称熊猫鞋」的。
mimo 那个表现比「答不上来」危险多了。它不是不知道,它是自信地给你一个错的。
如果你的系统信了它,后面整条链路全是错的,而且不会有任何报警。
差点就选错了:单次测试完全不可靠
这事得说说,因为我真的差点栽进去。
一开始我图省事,每个模型就跑一遍。跑完发现 qwen3-vl-plus 表现很好,
硬指标跟 qwen3.8-max 一模一样,速度还快一点,正准备定它了。
后来鬼使神差多跑了几次,结果傻眼:
模型 |
跑一次 |
跑四次 |qwen3.5-plus |
答对了 |
1/4 |qwen3.6-plus |
答对了 |
0/4 |qwen3.8-27b |
答对了 |
1/4 |qwen3-vl-plus |
答对了 |
2/6 |四个模型,单次全对,多跑几次全露馅。
这不是模型不行,是我的测法不行。这种知识边缘的问题,模型答对答错本来就带随机性,
跑一次的结果基本等于抛硬币。
后来我把「至少跑 4 次取命中率」写进了评测器,才敢下结论。
提示词救不了模型
发现上面那个问题之后我不死心,想着是不是提示词写得不够明确。
于是专门写了个强调俗称的版本,还举了例子:「必须优先给出民间俗称,
比如某些鞋款被叫做熊猫鞋、面包鞋、爆米花鞋」。
结果:
- qwen3.8-max:3/3 → 3/3(本来就稳,无所谓)
- qwen3-vl-plus:1/3 → 1/3(一点没变)
- qwen3-vl-flash:0/3 → 0/3,而且开始编词了
知识不在参数里,你提示词写出花来也变不出来。写得越用力,
它越容易给你编一个看起来像那么回事的东西。
最坑的一条:有模型会把图扔了然后瞎编
这个是真的要小心。
我在某个聚合平台上测 glm-5.2、deepseek-v3.2、deepseek-v4-pro 的时候,
它们都正常返回了答案,说得有鼻子有眼:
- glm-5.2 → Reebok Question Mid
- deepseek-v3.2 → Air Jordan 4
- deepseek-v4-pro → Nike Air Footscape Woven
全是错的。我一开始以为只是识别能力差,后来看 usage 才发现不对劲:```
prompt_tokens: 24
```正常带一张图应该是 1400+ tokens。24 个 token 意味着图片根本没进去。它们把图扔了,然后纯靠那句文本提示编了个答案给我。
更烦的是这行为还不稳定。同样的调用,有时候它会老老实实说「你没上传图片」,
有时候就直接编。你没法靠模型自己的回答来判断。
唯一可靠的办法是查 token 数:```
det = usage.get("prompt_tokens_details") or {}
img_tok = det.get("image_tokens")
if img_tok is not None:
if img_tok < 100:
raise ImageNotProcessed()
elif usage.get("prompt_tokens", 0) < 300: # 有些厂商不返回 image_tokens,用总量兜底
raise ImageNotProcessed()
```这段现在是我所有调用的必经检查。顺带说一句,同样是 deepseek-v4-pro,走 DeepSeek 官方 API 的时候,
它会明确报错
This model does not support image。这才是正常行为。同一个模型名,经过聚合平台之后行为完全变了,这点挺值得警惕的。
思维链不关,模型基本没法用
三个模型默认开思维链,不关的话:
qwen3.8-max 单张图 77.6 秒。关掉之后 3.4 秒。差 22 倍。
mimo-v2.5 从 10.3 秒降到 2.0 秒,输出 token 从 209 降到 10。
deepseek-vision 最坑:不关的话 800 个 token 全烧在推理上,
content直接给你返回空字符串,finish_reason是length。看起来就像调用失败了,你还得去翻
reasoning_content才知道它其实想明白了。参数名各家还不一样:
- 阿里:
enable_thinking: False- DeepSeek / MiMo:
thinking: {"type": "disabled"}- DeepSeek 也认
reasoning_effort: "none"图别压缩,省不下几个钱
我一开始想省 token,把图压小了传。结果同一张印着型号的箱子图:
- 640px:只认出「MAJOR」,型号丢了
- 1024px:读成「KAMM770」,多了个 A
- 1400px:正确读出「Major Premier KMM770」
省那点 token 费,换一个错误型号,不值。
这测试有哪些不足
得说清楚,免得被当成什么权威结论:
样本太少。 就 7 张图。8/16 跟 15/16 的差距够明显,但 12/16 跟 13/16
这种基本就是噪声了,别当真。
打分方法很土。 纯字符串匹配,模型说「6.6升」能匹配上,说「六点六升」就漏判。
标注是我一个人拍的。 哪几个属性算「关键」,多少有点主观。
品类偏了。 主要是鞋和小家电,数码、图书、生鲜这些完全没测。
有些模型走的是中转和聚合平台,跟官方直连可能不一样——上面那个丢图的坑
就是最好的例子。
要做得严谨,起码得扩到 50–100 张,标注规则写成文档,再找个人交叉标一遍。
我这个量级,够做选型判断,不够拿来排名。
说点别的
做之前我以为选模型看看榜单就完了。做完最大的感受是,**通用能力强不强,
跟你这个活儿上好不好用,可以完全是两码事。**
gpt-5.6 品牌认对 6/7,成绩不差。但它给那双 D’Lites 生成的描述是
「斯凯奇女鞋藏青色健步鞋」——一个字都没说错,可就是没人这么说话。
而「熊猫鞋」这三个字,只有真吃过中文语料的模型才吐得出来。
所以如果你也在做具体的东西,**别光看榜单,花半天写个几十行的评测器,
拿你自己场景里最难的那几个样本跑一遍**。真的比读十篇测评有用。
评测器代码和图片我都放上来了,欢迎拿去改。也想看看别的模型在这几张图上什么表现,
有跑的欢迎回帖贴结果。
 主楼
- xhz2026-08-21
上传之后,图片顺序变了,凑活着用吧
- 匿名者2026-08-21
Qwen是真的强,DS是真的快。
- mantest2026-08-21
总体看完了,聚合平台根本不能比,那三个模型都不是多模态的和支持多模态的可以说是天差地别。至于其他模型的识别也是依赖图库和后训练了,我理解目前阶段静态非热门物体还是有难点的,因为数据集太少了。
- linlinzong2026-08-21
所以这是到了阿里的电商优势区间了吗,才能识图这么准
 nite072026-08-21
这文章是AI写的吗?感觉好重的AI味。
- HeriX2026-08-21
你这个是测试模型得知识库完备能力啊,并不是识图能力,可以试试豆包或者北美大豆包看看
- xhz2026-08-21
本来是在做一个小工具,测试哪个模型最便宜,效果最好
已经选定用qwen3.8了,结果今天ds除了支持视觉识别的模型,想着已经踩了很多坑了,再看看这个效果如何,遂让claude加入了ds的测试,因为实际干活的是claude,因此本文大部分是让claude以测评模型的角度总结他干的活
- xhz2026-08-21
我的核心需求是识别物品,并测试哪个模型便宜又准,忘了这俩豆包了 ^-^