ai知识库设计
43
- 菜小学生2026-08-22
我最近设计了一个知识库。我认为关键根据是ai的判断、理解能力达标。
我让ai不管遇到什么事情,都放到知识库里,但是对每个事情都进行关键词提取和分类。
例如这个是工作项目的一个需求,那么ai总结应该是关键词、总结,然后把他的关键词和总结归类到工作的分区、甚至改分区下的关键词、总结多了以后工作分区下再分类,具体某个项目之类的、这些分类由ai自己判断。
现象中的效果是这样的:ai遇到事情,去知识库看看:第一层有几个分区,ai感觉可能和A分区有关,下探A分区的内容,发现一堆关键词以及关键词对事件的总结,感觉可能和这个事件有关系,查看关键词具体的事件记录,或者分区下还是分区,ai自己判断是否可能有关系,继续下探。
并且我设计里是知识库的知识优先级高于其他的信息来源的。
希望通过这个知识库可以给ai提供客观记忆系统。
然后还想给ai加一个人格的知识库,他经历事情后自己的感受都写在这里,希望他可以根据这个知识库作为附加提示词,达到一个自我发展的人格。
现在痛苦的是公司笔记本太卡,不好搞,我的电脑下班后再搞又使用评率太低没有积累,所以最后把宿舍的电脑搬去公司用了,这样周末又没电脑用了,毕竟deepseek-harness 是部署本地的
主楼 - 行尘2026-08-22
建立个git私有仓库去存放?再用同步工具分发到多端,这样去试试?
- superben2026-08-22
karpathy 大神的 llm-wiki 了解一下,
现在基于这个概念的东西还挺多的。
腾讯的 TencentDB-Agent-Memory ,
里面的 MemoryKnowledge 也能看到 llm-wiki 的影子,
我让 AI 直接把它抽出来用了,效果还是不错。
当然知识庞大的时候 karpathy 大神也说了,
可以试试 qmd 也可以自己 vide code 一个。
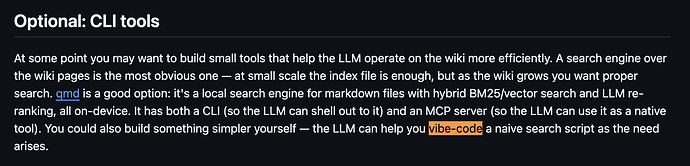
他的核心理念我也很认同,
搞一大堆,最后 AI 一波更新直接就接管了。
不如直接让 AI 做,不要增加太多的东西反而更简洁。
而且现在迭代那么快,分分钟换模型进来直接接管了。
综上可以好好看看,
整个 karpathy 的 llm-wiki 里面的东西,
会有所所获的。
- 菜小学生2026-08-22
看了一下,我感觉我的想法和llm-wiki 不大一样。
我的想法是把事件、已确认的知识一个个存储起来,然后ai做事情的时候可以按照目录找到可能相关的事情,然后最后找到事件里相关的信息作为背景补充给到ai。不需要给人看
llm-wiki 感觉更像是让ai给人类整理笔记,但是不是人类自己的整理,理解也不会是自己的,而且ai写的内容看起来是这么回事却有点难入脑,可能不大好。这个是我自己的理解。