- chxby2026-08-21
题主有一张4090 48gb的显卡,尝试在本地用claude code+qwen38 fp8实现全程的本地化,主要讲讲我自己的工作思路
- 模型下载
这边我直接在魔搭社区下载了fp8的权重文件,千问Qwen3.8-27B-FP8 · 模型库
这个权重文件有整整30gb,昨天下午看的时候还是只有370k下载量,现在24小时过去已经有400k下载量了。
魔搭社区提供了git lfs和SDK两种下载的方式,个人实测下来,SDK的方式更加稳定可靠,lfs容易出现等待半年都没啥反应的情况。```
uv pip install -U modelscope
modelscope download \ --model Qwen/Qwen3.8-27B-FP8 \ --local_dir ./Qwen3.8-27B-FP8
``下载后的目录变成``
./model/
├── .venv/
└── Qwen3.8-27B-FP8/
├── config.json
├── tokenizer.json
├── *.safetensors
└── ...
```- 模型推理与测试使用vllm开始推理```
vllm bench serve \
--backend openai-chat \
--base-url http://127.0.0.1:8000 \
--endpoint /v1/chat/completions \
--model qwen38 \
--tokenizer ./model/Qwen3.8-27B-FP8 \
--dataset-name random \
--random-input-len 1024 \
--random-output-len 512 \
--num-prompts 5 \Output token throughput:20.17 tok/s Peak output throughput:21.00 tok/s Mean TTFT:287.86 ms Mean TPOT:49.10 ms 虽然不是很快,但是首字响应比较快,对话体验还可以 3.claude code对接测试``` export CLAUDE_CODE_MAX_OUTPUT_TOKENS=8192 export CLAUDE_CODE_EFFORT_LEVEL=medium export ANTHROPIC_BASE_URL=http://127.0.0.1:8000 export ANTHROPIC_AUTH_TOKEN=dummy export ANTHROPIC_MODEL=qwen38 claude ```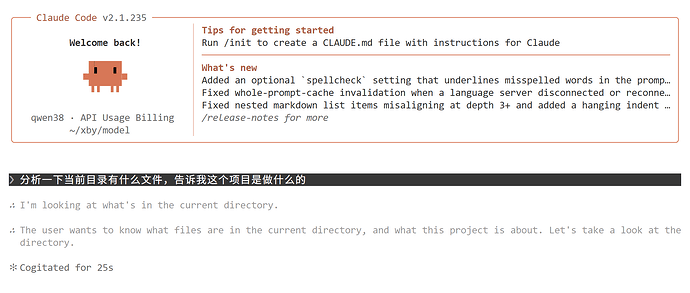 使用体感,20token/s勉勉强强够用,工具调用能力还是不行,经常卡死在这个页面,这个真能有opus 4.6的水平吗?主楼  人杰2026-08-21
这么慢吗 为什么我看网上有40以上速度
- komamis2026-08-21
- qilme2026-08-21
应该加一个dspark模型,速度可以提升1.3到2倍
- Kisaragi_Mio2026-08-21
佬没有试一下DFlash2的加速版本吗,我只有4090 24G,只能Q4_K_M的量化版本+DFlash2加速去除视觉分支,KVCache用KCache Q8+VCache Turbo3的量化能勉强190k上下文,到接近上下文窗口的时候是30-40t/s,前面刚开始对话的时候还是有100多t/s,48G应该不用妥协这么多精度,让Codex帮我魔改的llama.cpp
- qilme2026-08-21
另外最快的应该是nvfp4+MTP
- JackBlue2026-08-21
个人使用并发不大的情况下的话llama.cpp 比vLLM要更快。
- gongshl2026-08-22
用SGLang吧,感觉SGLang性能会好很多
- 我心永恒2026-08-22
你 48G 显存部署 FP8 版本显然是不够的,FP8 版本得 96G 显存,基本只能 q4 量化这种级别,此外你还得大改 api 什么的,因为默认的对于 claude code 兼容性不行,以及得用 sglang 而不是 vllm,sglang 占用的显存会比较小
- Mr.X2026-08-23
DFlash 2: Keep Drafting Parallel — Inco AI 佬試用一下這個吧最新的可加速