- worldsHello2026-08-23
最近还在继续折腾之前发过的这个学习工具:
最近又做了一些更新,也顺便把几个容易看不明白的细节补充一下。
一、图谱生成和修改更自动了
现在只需要简单说明学习目标,系统就会先生成一份问卷,用来确认你的基础、时间安排和具体需求;完成问卷后,会先生成一批知识卡片;你可以删掉不想学的内容,也可以补充自己关心的方向,确认后再生成完整学习图谱。如果觉得某个节点范围太大,还可以继续拆分,直到达到适合自己的学习粒度。
[image][image][i…本来只是想做个学习 Agent,结果越写越不对劲。
一开始是图谱、聊天、工具调用,后面慢慢又塞进了文件、Shell、Sandbox、Skill、Memory、子应用、联网、Artifact……
做到后面突然发现:
我这好像已经不是在单纯写 Agent 了,而是在一点点搓 Harness。 ^-^
刚好最近 Harness 这个词也越来越热。
DeepSeek 放出了自己的 DeepSeek Harness,OpenAI 最近也开始频繁提 model-native harness。
而且这段时间我自己折腾下来,有一个感受特别明显:
同样一个模型,放在不同 Harness 里面,用起来真的能像两个模型。
有的 Agent 给它一个 Shell,看起来无所不能,真正跑长任务的时候却很容易开始原地打转。
有的 Agent 一股脑塞几十上百个 Tool,结果模型光挑工具都挑晕了。
反而有些 Agent 暴露出来的能力看起来没那么多,但是能自己搜、自己改、自己跑、自己验证,一口气工作挺久。
这或许就是AI应用工程师还有一口饭吃的原因吧(bushi)
今天这篇文章,主要是聊一聊我做这个开源项目过程中所认识到的Harness
理解或许粗浅,当个日志看看就行
Harness 到底是个啥?
一个最简单的 Agent Loop,其实没多少东西:```
while not finished:
response = LLM(context, tools)if response contains tool_call:
result = execute(tool_call)
context += result
else:
return response
``模型干的事也很好理解:``
想一下
↓
决定调工具
↓
看看结果
↓
再想一下
```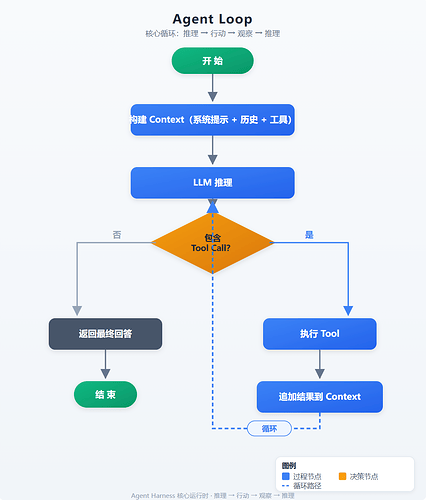
到这里,其实最基础的 Agent 已经有了。
但真做起来就会发现:
Agent Loop 反而是最简单的那部分。
稍微想把它做得能用一点,各种鬼问题马上就来了。
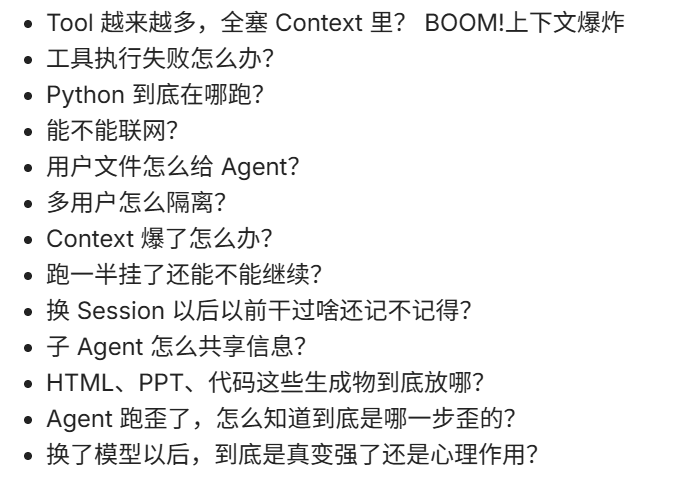
以及此处省略一万条……
最开始遇到这些问题,我很容易往一个方向想:
模型是不是还不够聪明?
后来越做越觉得,很多时候还真不是!
用大白话讲我对 Harness 理解就是:
模型和真实世界中间,那一大坨负责让模型真正干活的东西。
模型负责想下一步干啥。
至于:
怎么执行、在哪执行、权限多大、挂了怎么办、结果存哪里、怎么继续跑……
这些最好由 Harness 直接接过去。
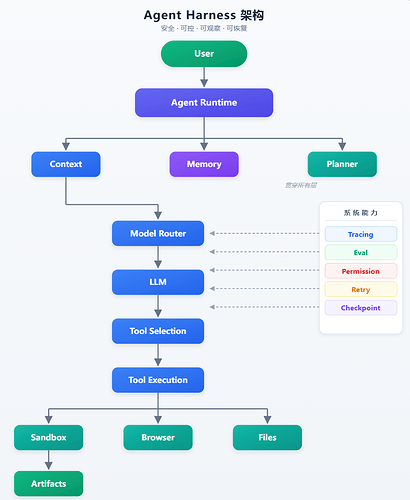
真正做复杂 Agent 的时候,经常会发现:
那几行 Loop 根本没多少代码。
最后全在折腾 Loop 外面这些玩意(
DeepSeek Harness:一切皆插件
最近 DeepSeek 放了 DeepSeek Harness:
里面有句话表达得挺直接:
Agent = Model + Harness
它对 Harness 的理解非常清晰:
Model 是负责思考的那部分。
Harness 则负责给它工具、环境、状态,让它能真正在外面干活。
我比较喜欢 DSH 的一个点是:
Everything is a Plugin
Model、Tool、Skill、Session、Sandbox、Storage、Loop、Scheduling、UI……
很多东西都可以拆开换。
我自己现在做东西也越来越能理解为什么要这么搞。
因为不同 Agent 需要的 Harness 差别实在太大了。
Coding Agent 想要 Git、Shell、文件系统。
学习 Agent 更关心资料、记忆、交互内容。
Computer Use 又完全是另一回事。
与其造一个巨型“万能 Agent”,不如让 Harness 自己就是一堆可以组合的东西。
OpenAI 最近提的 model-native harness,我自己的理解也差不多:
不是拼命给模型加按钮,而是尽量把环境组织成模型比较好理解、比较好操作的样子。
然后说说我自己一路踩过来的几个版本
拿一个最普通的任务举例:
帮我分析这个项目,找问题,改代码,然后跑一下测试。
看起来一句话。
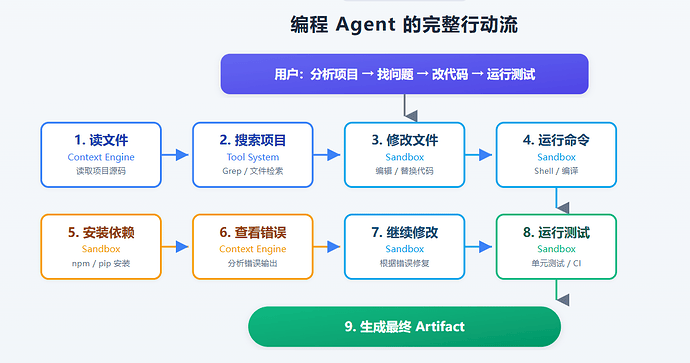
实际干起来大概是:```
读文件
↓
搜项目
↓
修改
↓
运行
↓
发现依赖没有
↓
装依赖
↓
运行
↓
报错
↓
继续搜
↓
继续改
↓
再跑
↓
最后产出文件
```这里 Harness 怎么做,体验差别就开始出来了。T0:给它一个 execute,天下无敌
最开始很容易想到:
这还不简单?
给它一个 Shell 不就行了。
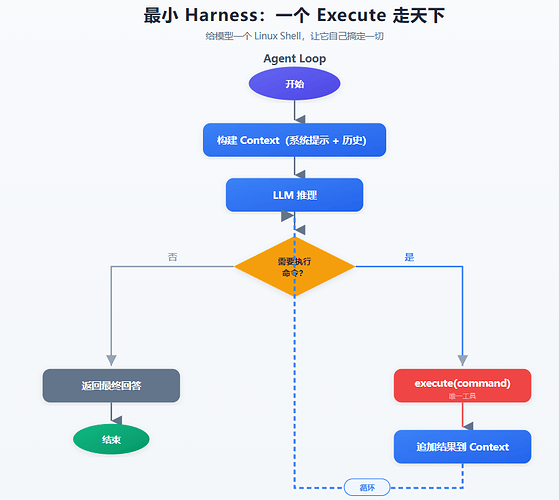
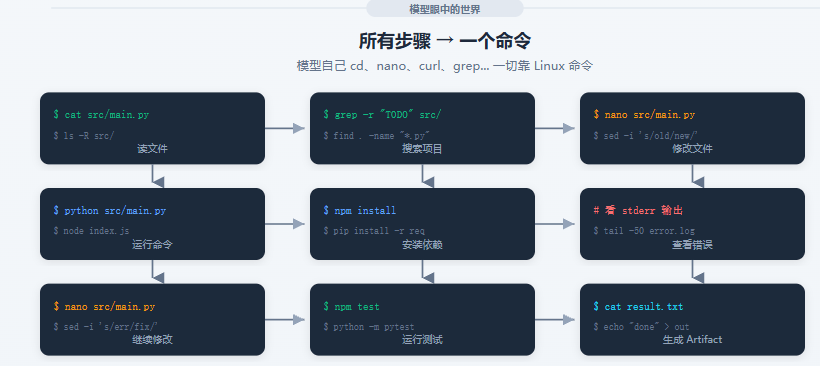
Shell 这个东西确实离谱。```
grep
find
sed
git
python
npm
curl
wget
...
```理论上一个 execute 就能顶半边天。从设计上相当优雅:
Shell 本身就是一套高度可组合的 Tool System。
DeepSeek Harness 的 Minimal Mode 也差不多是这个思路,故意只留 persistent bash 和文件编辑器,看看模型在极简 Harness 下到底能发挥到什么程度。
但我真把这个思路往产品里塞以后,很快就开始汗流浃背了。
第一个问题:安全
模型手里有:```
rm
curl
wget
ssh
git
pip
npm
```它就是真的啥都能干。自由度拉满。
我的血压也拉满。
血泪史:qwen3.8max雷霆大思考之把我数据库删了 QAQ
如果哪天模型面对一个环境问题,突然想出了一个非常彻底的解决方案:
“我们先清理一下当前目录……”
那就刺激了。
所以第一件事:
上 Sandbox。
这东西是保命!(
第二个问题:它每天都在重复干脏活
比如读文件。
模型当然可以自己想:```
sed -n '1,200p' xxx
```但问题来了。文件太大呢?
乱码呢?
路径里奇奇怪怪的字符呢?
搜索一下出来一万个结果呢?
其实这些问题根本不需要什么“智能”。
都是非常确定的工程问题。
但如果只给一个 Shell,模型每次都得重新想:
怎么拼命令。
怎么截断。
怎么解析。
报错了怎么改。
CPU 明明能直接干的活,才不要要花大模型 Token 亲自搬砖
第三个问题:Round Trip 真的多
比如这么一个流程:```
Model
↓
Shell
↓
Result
↓
Model
↓
Shell
↓
Result
↓
Model
...
```一个十几步的任务,几十轮 Tool Call 非常正常。然后你就会看到:```
Latency ↑
Token ↑
中途跑偏概率 ↑
```而且前面某一步理解歪了,后面很可能就顺着那条歪路一路狂奔。所以shell:
理论能力无限,不等于使用体验很好。
T1: 封装,封装!
都市传说:
“All problems in computer science can be solved by another level of indirection.”
——Butler LampsonShell 玩得血压上来以后,很自然就进入了第二阶段:
既然这些事情都有套路,那全部封起来不就好了?
于是:
文件读取,一个 Tool。
搜索,一个 Tool。
编辑,一个 Tool。
浏览器,一个 Tool。
下载,一个 Tool。
转换,一个 Tool。
……
舒服多了!
比如
read_file。分页、编码、截断、大文件这些 Harness 自己处理掉。
模型只需要吩咐:
小老弟,我要这个文件,他叫(xxx)。
没了。
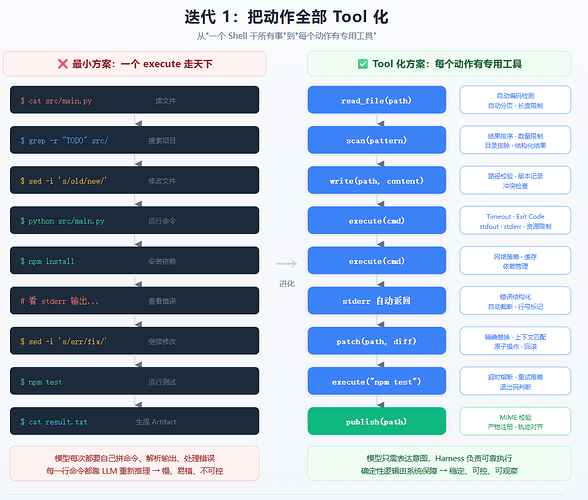
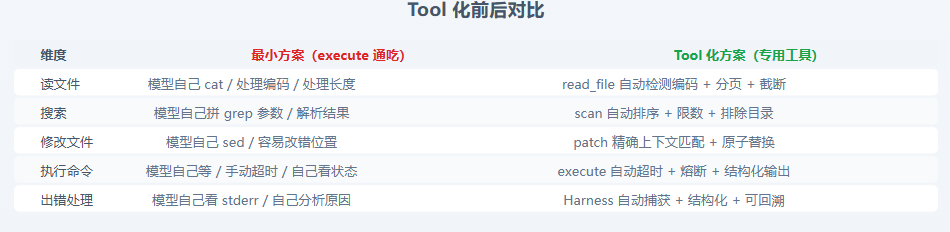
这一步之后,我们可以认识到Harness的一个原则:
能确定性解决的问题,就不要让 LLM 每次重新推理。
还有一个意外的好处:
Permission 终于好做了
Tool 是结构化的,那中间就能加 Hook!
Agent 想删库跑路?
Hook先拦下来,问一嘴:
哥们,你真要删?
这个比 System Prompt 里面写:
“请千万不要执行危险操作哦^-^”
靠谱多了。
Prompt 更像教育。
Permission 才是真的门禁。
不过封着封着,我又把自己封出新问题了。
打开 Tool 列表:
5 个。
20 个。
50 个。
100 个。
……
模型找 Tool 这件事情,本身都快变成一道题了。。。
500 个 Tool 全塞给它。
它当然“理论上都能用”。
但是每次先从 500 个动作里面找正确动作……
选择困难症都要犯了,哎呦喂!
T2:那就别一次性全给它看
所以继续往下改。
Skill + Progressive Disclosure
思路其实很土:
分治。
假如系统里面现在有 500 个动作。
一开始只给模型几个大类:```
文件
代码执行
联网
浏览器
数据分析
图像
项目管理
...
```模型先说:我要处理一个代码仓库。
再把代码相关 Skill 加载出来。
Skill 里面如果东西还很多,那还可以继续找。
这就跟查字典差不多。
我们人类查一个字之前,不会先把《新华字典》全装进塞脑子里。
而是先查拼音,后找字。
这是一种渐进式索引,
需要什么,再逐层暴露什么。
而不是:
来,500 个 Tool Schema,请开始你的表演。
有论文专门描述过这个事情,工具不是越多越好。
但故事当然不会这么顺利。
工具是找准了。
新问题:
Tool Call 还是爆炸。
例如:
搜索项目里所有包含某个函数的文件,再读前 10 个。
如果很老实地 Agent Loop:```
LLM
↓
search
↓
LLM
↓
read(file1)
↓
LLM
↓
read(file2)
↓
LLM
↓
read(file3)
...
```多看一秒钟,都是对我钱包的不尊重!!!“把搜索结果前十个循环读出来”这种事情,咱们程序员看一眼就知道:
写循环啊。
T3:兜了一圈,发现还是得当脚本小子
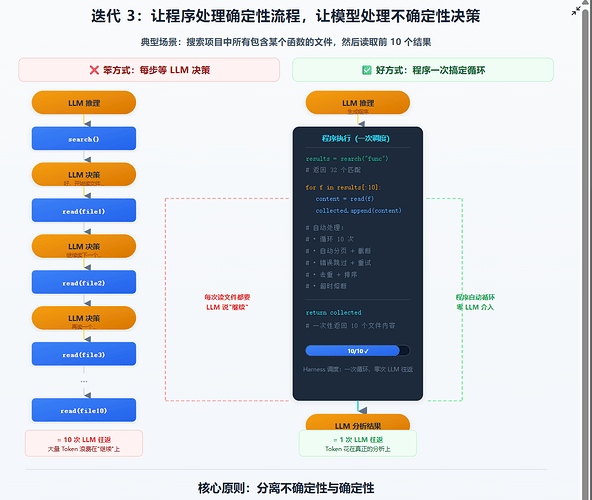
于是我又往前走了一步:
让 LLM 不要亲自盯着每个 Tool Call。
而是让它编排一小段程序。
变成:```
LLM
↓
生成一段编排逻辑
↓
Search
Read
Filter
Batch
Retry
...
↓
程序自己跑
↓
把结果整理回来
↓
LLM 接着判断
```这样模型就不用一直:file1 看完了。
好,继续。
file2 看完了。
好,继续。
file3 看完了。
……
终于从流水线工人升级成了包工头(bushi
到这里我得到了一个结论:
让LLM 去干不确定的事情```
用户真正想解决什么?
这个错误到底说明了什么?
几个方案哪个更合理?
下一步应该探索哪里?
现在结果到底够不够好?
``**用普通程序去干确定的事情**``
循环
排序
过滤
并发
Retry
Backoff
Batch
Parse
Dedup
Cache
```说起来像废话。但架不住真香
有时候系统越 Agentic,不一定越好。
能不用模型的地方,反而尽量别用模型。
真正麻烦的东西开始冒出来
做到上面这些以后,本来以为差不多了。
结果只要任务稍微变长,新的坑会自己往外冒。
Context 放不下了:```
Context Builder
Compaction
``任务跑一半挂了:``
Checkpoint
Resume
``下一次 Session 还要继续:``
State
Memory
``Agent 生成了 HTML、PPT、代码:``
Artifact Lifecycle
``多个 Agent 一起干:``
Orchestration
``跑歪了不知道为什么:``
Trace
Observability
``今天改了 Harness,明天模型效果突然变差:``
Eval
Regression
``多用户:``
Identity
Permission
Isolation
``任务跑几十分钟甚至更久:``
Scheduling
Queue
Resource Governance
```……然后回头一看:
我一开始不是只想做个学习 Agent 吗?
怎么长出这么多东西了(
所以目前我自己的理解,大概是这样一路长出来的:```
T0
Shell↓
T1
Sandbox
Structured Tool
Permission↓
T2
Skill
Progressive Disclosure↓
T3
Code Orchestration↓
T?????
Context
State
Memory
Artifact
Trace
Eval
Scheduling
Isolation
...
```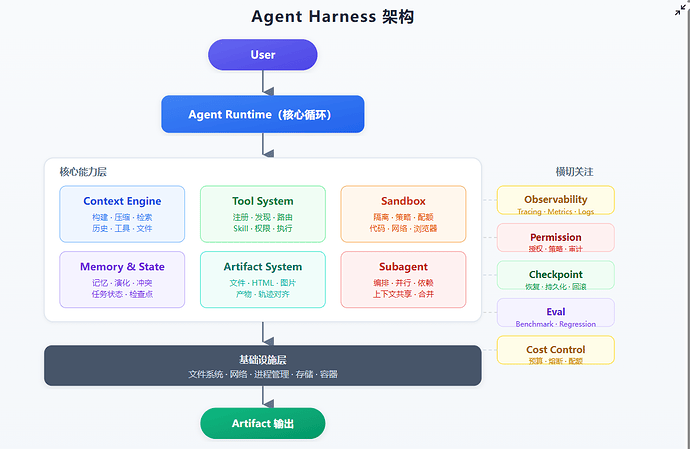
我现在当然也不敢说这就是所谓的“标准 Harness”。
甚至越做越觉得,不同场景大概率就应该长得不一样。
不过有一个想法倒是越来越确定。
Harness 不一定是在给模型加东西
最开始做 Agent 的时候,很容易有一种思维:
模型能力不够?
那加 Tool。
还不够?
再加 Skill。
再不够?
再塞东西。
但我现在反而越来越觉得:
好 Harness 很多时候是在把东西从模型身上拿下来。
最后留给模型的,还是那些它最值钱的部分:```
理解
判断
推理
规划
创造
```剩下的脏活,Harness 帮它兜住。所以 DeepSeek 那句:
Agent = Model + Harness
我现在确实越来越能理解。
Model 决定这个 Agent 理论上能有多聪明。
Harness 则决定:
这份聪明到底有多少能真正变成可用的能力。
同一个 Model。
换一个 Harness。
最后出来的东西,真的可能完全不像同一个 Agent。
先写到这里。
最近还在继续拆 LearnGraph 里面的 Context / State / Memory。
这三个东西看起来谁都懂,但真往长期 Agent 里面塞,很容易直接搅成一锅粥。
如果后面自己捋明白了,准备再写一篇:
长期运行的 Agent 里,Context、State、Memory 到底该怎么拆?
这块我自己也还在踩坑。
有做类似东西的佬友也欢迎交流,尤其想看看大家实际工程里 Harness 最后都长成什么鬼样子(
主楼 - A844932026-08-23
感谢佬友分享,中间有些内容看着非常像gpt生成的,如果确实是AI生成的一定要注意截图,小心炼化
- jqtmviyu2026-08-23
最后发现在重新发明 codex/claude code, 明明最开始精简优雅得像pi
- apparition2026-08-23
- 下班打卡_-_早退2026-08-23
- worldsHello2026-08-23
感谢佬提醒 ^-^,部分排比用了润色现以修改,大部分是手敲的
- rocket0012026-08-23
感谢佬分享,通过您的拆解过程,清晰明了的了解了Harmness的构成原理和作用。感谢感谢