- airline2332026-08-23
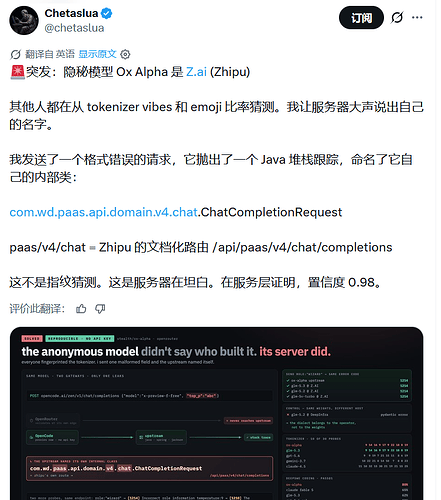
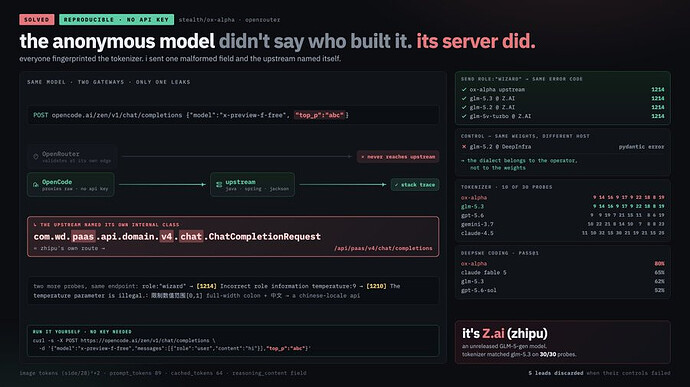
省流:是在现有的
- tokenizer特征(脏token、token数量变化)
- 1012报错代码
- top_p报错
三个特征之外的新特征
复现:```
curl -s -X POST https://opencode.ai/zen/v1/chat/completions -H "content-type: application/json" -d '{"model":"x-preview-f-free","messages"[{"role":"user","content":"hi"}],"top_p":"abc"}'
```
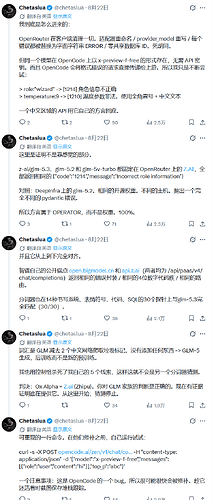
原po Twitter @chetaslua
主楼 - Poco2026-08-23
服务竟然是 java 写的吗,这真没想到
- ius2026-08-23
站内在这个模型出来当天就有佬研究并实锤啦
- Scheme2026-08-23
- 在学OCaml2026-08-23
感觉可能是 glm-5.3-flash 这种, 智谱已经很久没有快速模型了
- 在学OCaml2026-08-23
X 上那些 google 的内部人员明知真实情况还来凑热闹说是 gemini 真是纯小丑了, 不知何意味
- 雨天2026-08-23
应该不是,智谱如果上线这么一个量级的模型,而且现在这么大的量,他的卡资源应该无法支持同时上线牛来和GLM5.3,而且牛来在openrouter的调用速度很不错。
从资源的角度看,有可能是小米,因为现在mimo用的资源空置很久了。当然,这也是猜的。
- 星河璀璨2026-08-23
- smell2026-08-23
- kero2026-08-23
- HeriX2026-08-23
你的论据比起楼主的根本不值一提, 而且理由也不够充分
并且智谱的glm5.2资源这么紧张的时候(当然不是真的紧张, 你直接调用api流畅的很, 只有订阅才卡)
还保留了一堆glm4.7 air 等等的模型
- 白濑2026-08-23
和G有关系,你就说是不是吧hhhh ^-^
- summerjoe-linuxdo2026-08-23
GLM5.3在zcode里答糖果问题最高思考能连续答错,看来是真把算力让给牛来了
- deepcake2026-08-23
笑死了,你看得是营销号转的吧,原本是说
朋友,传着传着就变成Gemini本人了。蓝V甚至能顶风作案,在同一帖子底下开始乱传话,
我怀疑可能跟TPU有关吧?不然算力哪来的?还是美国公司根据glm微调?
- RICK2026-08-23
用GLM底座,蒸馏GLM也有可能把,这个模型的水平感觉比不过5.2
- Poco2026-08-23
你这啥证据。。。直接租海外的算力呗。