Midsummer2026-08-27
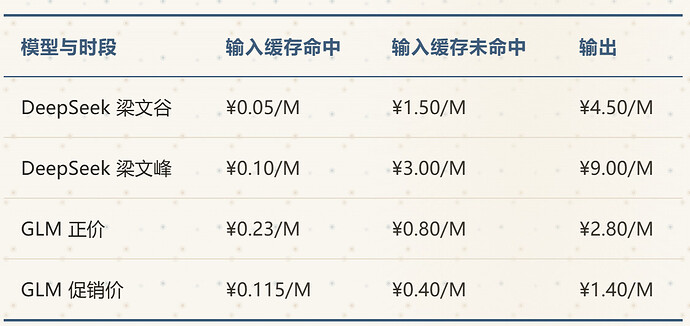
- 两者国内现在的官方价格
价格计算公式
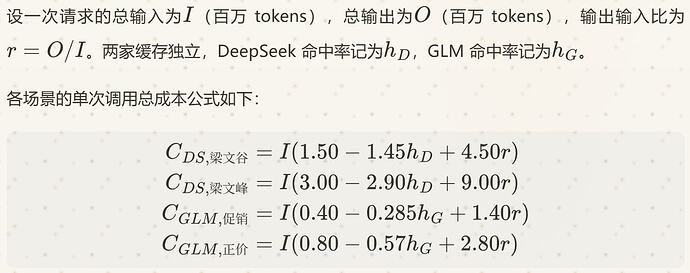
- 假设任务为编码任务,根据市场调研,缓存命中率众数DS为99.4%,GLM为 97%
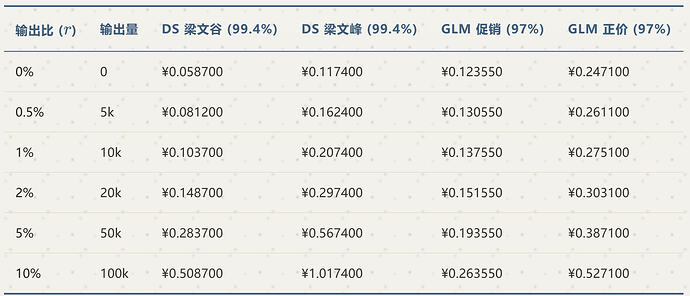
- 抛出一张粗略图,(根据价格公式,在excel中计算的结果,准确)
- 接下来精确计算
- 梁文谷
-
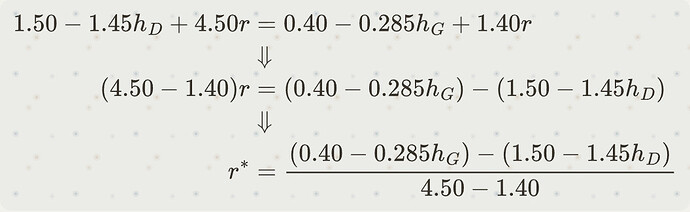
- 代入命中率h_d=99.4%,h_G=97%,得到临界点为r=2%。即1M上下文中,输出低于2%的时候DS占优,否则GLM便宜。当然,我们计算的价格是GLM的促销价,如果按照GLM正价,1M上下文,输出要占比大于11.08%,GLM才有价格优势。实际上编码会话输出占比(补丁、工具调用)一般到不了 2%,所以梁文谷时间,DS完胜。
- 梁文峰
- DS 全线翻倍,GLM促销期间,2%的底线守不住。GLM正价情况下,梁文峰能守住2%底线。
综上,如果编码任务不需要GLM-5.3-Flash的能力的话,可以优先用DS。
叠甲:本人没有任何DS广告的意思,虽然在上述计算中DS大获全胜,但是不影响我不敢用DS了,贵贵贵,还是中转站的GPT好用。
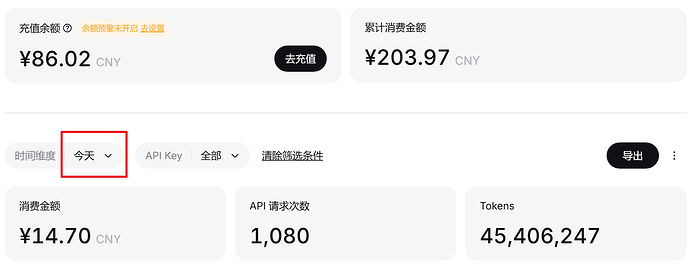
今天40M,花了14块,按照涨价前,我可是能用200-300M的
主楼- 羽于羊2026-08-27
GLM的缓存价格比ds贵了不少。
- Midsummer2026-08-27
是的,而且大概缓存的事件还没DS久。啥时候DS弄个新的斩杀线就好了
 fengchris2026-08-27
- 嬴麻2026-08-27
- JayXuZ2026-08-27
- Midsummer2026-08-27
钱包不紧张或者任务却有需要,那当然能力更强的新模型是首选。
- Brantfang2026-08-27
你不会只看单轮调用吧。你看看缓存命中率差价才多少?后续输入越多未命中的数据也会累加拉开差距。未命中的和输出的价格 DS 差太多了。
- Midsummer2026-08-27
实际上,我是算多轮滚动的。而且轮数越多DS越有优势,因为DS的缓存时间非常长
- Brantfang2026-08-27
缓存时间不好定性,这个长时间使用一下 glm-5.3-flash 就知道了。至于如果找你这个计算,往往输出比会在 5% 往上。
- knying242026-08-27
我用opencode中的glm-5.3-flash,这个tps我感觉并不快,只有50-60左右,是这样吗
- Kassdin2026-08-27
这有很多需要讨论的,也和模型行为有关
- 比如我用100-200k的上下文完成一个小需求就切新对话,此时大概总token小号在5-6M,命中率可能90%左右,但是总token量少,所以计价便宜
- 假设已经使用100k上下文,A模型倾向于串行调用工具,5个工具连续调用,每次都会读取100k+工具结果的缓存token。B模型倾向于并行工具调用,5个工具同时执行只接受一次结果,总共就100k的缓存token。两者干了一件事情,但A模型消耗了500k+缓存,B模型只消耗了100k缓存,且A模型的缓存命中率>>B模型,A是5次99%,B模型是1次95%。导致缓存命中率高反而更贵
- 邱埋葬2026-08-27
做代码任务的话,我还是会选择v4f。
主要就是缓存命中差了一个数量级,而5.3f的效果并没有比v4f强很多。二者是同一水平的模型。
另外吐槽一句:5.3f的激活参数比v4f足足多了5B,效果居然才和v4f五五开,唉
- parksi2026-08-27
感觉GLM5.3F能力上确实不如DSV4F,换了好几个coding工具都是一样,希望智谱再接再厉,DS快把视觉模型开源 ^-^
- sysy007uuu2026-08-29
这几天用了几个中转站的glm flash,缓存命中只能到50-60左右,dsflash能到95+,真没法比吧
- bad2026-08-29
看到梁文谷我还需要反应一下。但是从现在起这个说法也是我的了!另外我想问个问题,佬友你用glm 5.3 f用的是什么harness?如果是hermes的话,会出现频繁他错误调用工具的情况吗?
- randname2026-08-29
这种水平的大模型应该很少会调用工具出问题吧,反正我用牛来在 cc 里用是没出过问题的