- Laplace92026-09-04
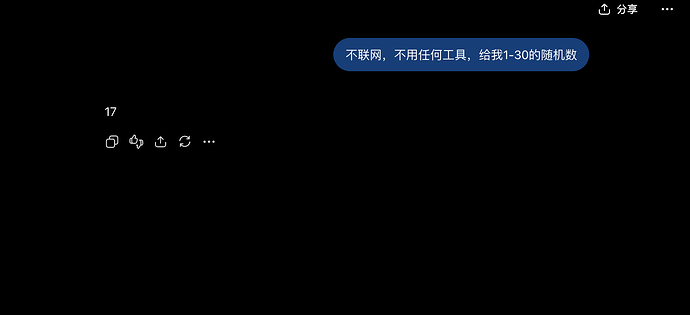
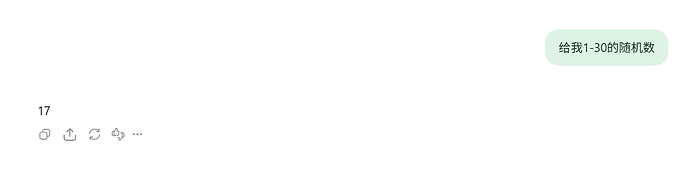
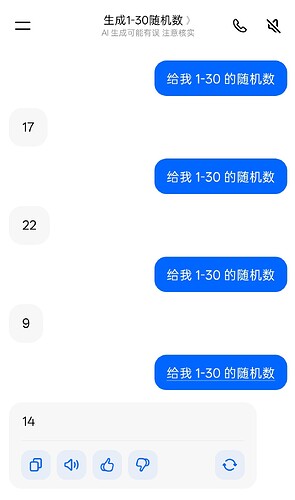
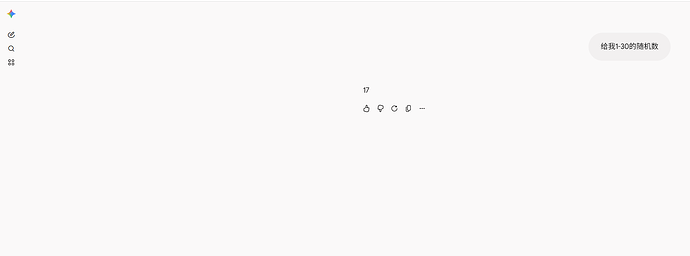
测试了下Gemini,豆包,千问,chatgpt还真是这样,有佬友知道为什么嘛,不太懂LLM原理。有朋友测试要么是22要么是17,这个是不是因为缓存问题?
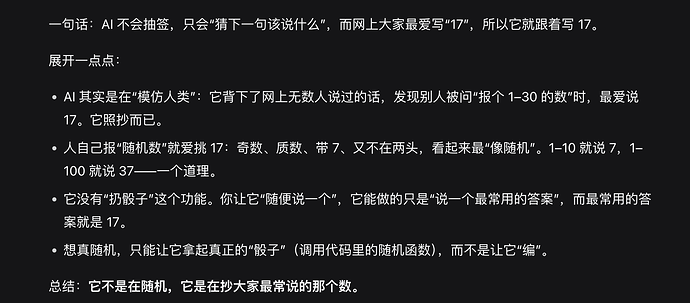
Gemini
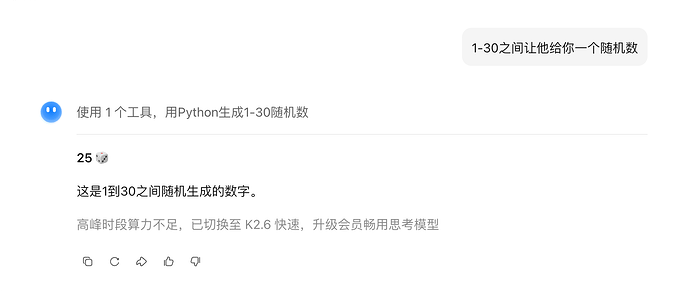
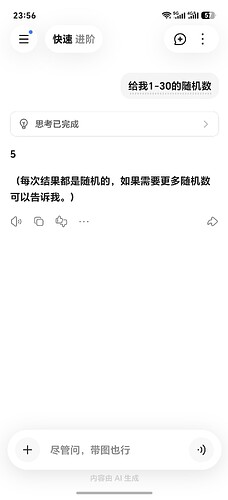
豆包
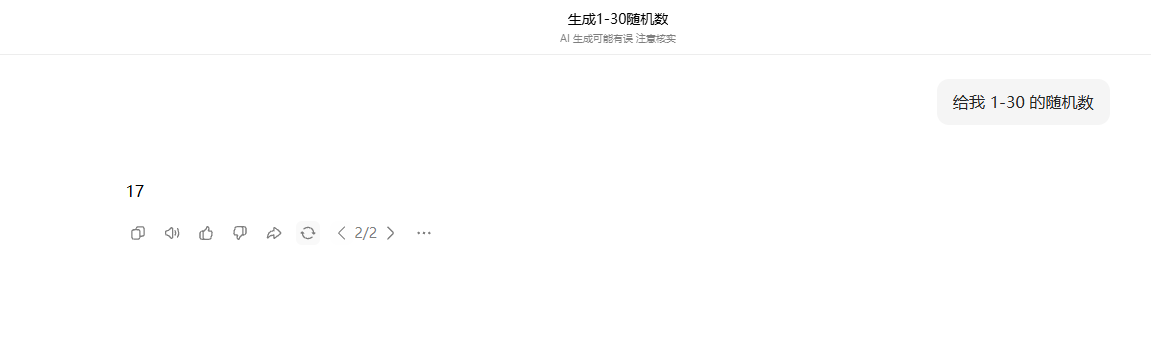
千问
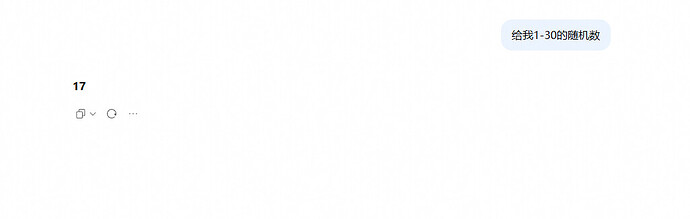
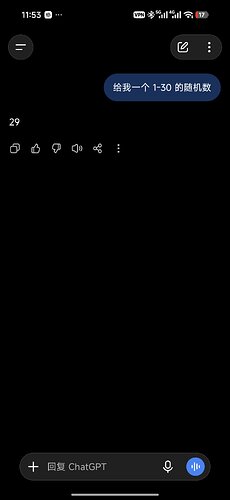
GPT
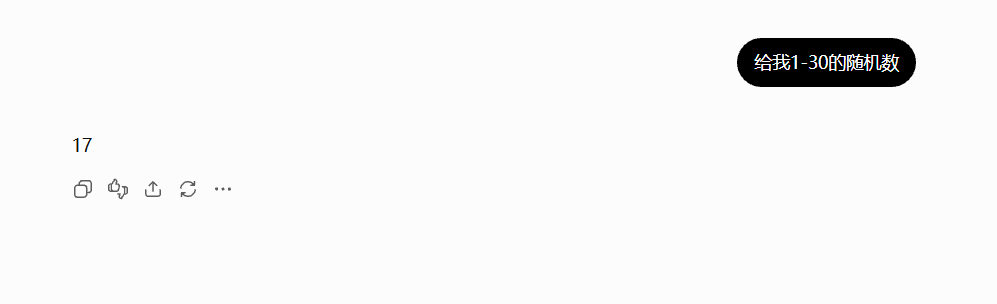 主楼
- Dregoja2026-09-04
豆姐回复我22(论坛标题竟然不能复制)
- 席乐2026-09-04
- Dregoja2026-09-04
我是按帖主的提示词问的,一字不差
- lgchhh2026-09-04
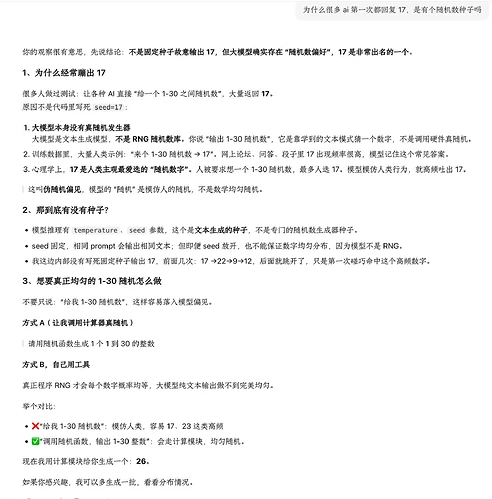
哈哈17成了AI的幸运数字了,估计训练数据里这个数出现频率高
- wmuj2026-09-04
- 席乐2026-09-04
- 550W2026-09-04
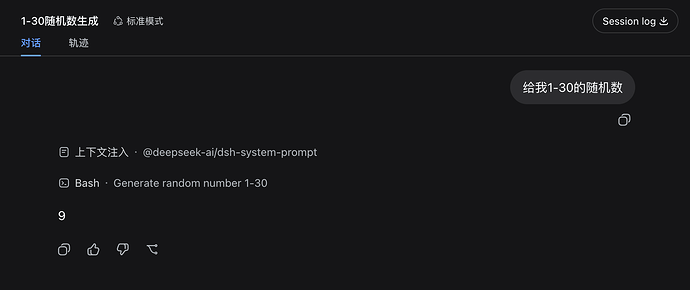
这个模型调工具了肯定不是与模型权重相关的随机啊
- killer2026-09-04
大语言模型的本质是根据你过去的 token 推测下一个 token。所有的 token 都是有概率的,也就是说,它大概率会选用概率最高的那几个作为回答。假如大家的数据集都差不多的话,那自然训练出来的概率也都是差不多的
但是为什么有的会提示不一样呢?
当你让它写代码去帮你生成的时候,那自然的是真正的随机。当然了,归根结底,代码的随机数生成也不是完全随机的,这得看你怎么理解了
- JUMP2026-09-04
- 不是不思考2026-09-04
- 𝙋𝙚𝙩𝙖𝙡𝙨2026-09-05
- 白菜2026-09-05
你这个用Python random生成的,不是模型的
- BlueFunny2026-09-05
感觉是原理限制,具体可以查一查 transformer 模型原理,这个问题之前也有人研究过了
大致来讲,就是 LLM 吐字实际上就是在做一种概率运算,而所谓的模型其实就是这个概率运算公式的参数;大家最终看到一个问题在不同的模型上有不同的回复是因为参数本身有些差异,而一句话重新生成也能有不同的回复本身是后处理和一些特殊参数发生了改变后的结果
但是数学这个东西很奇妙,就像你 1+1 只能得到 2 一样,所有模型的运算最终得出来的值也会趋近于同一个最优解,哪怕里面的参数是完全不一样的;再加上现在各大厂都是互相蒸馏,就会更加加重这种问题
还有一个研究说是人类本身也有类似的趋势,让不同的人随便想一个随机数,他们有大概率想到 7 或者 3 之类的,最终大量语料就让这个特征变得明显了,从而导致 LLM 也有这样的问题;这个也有可能会影响,但个人感觉没上面那种影响大
- Szou2026-09-05
之前站里不就有人用这个原理检测模型有没有掺水吗?样本量大的话,每个模型的偏好数字应该是不一样的。
- 我刘邦2026-09-05
- 倪劳达2026-09-05
冷知识:按住ALT键就可以直接选中超链接上的一部分文本,然后CTRL+C就好了
- XUMUMI2026-09-05
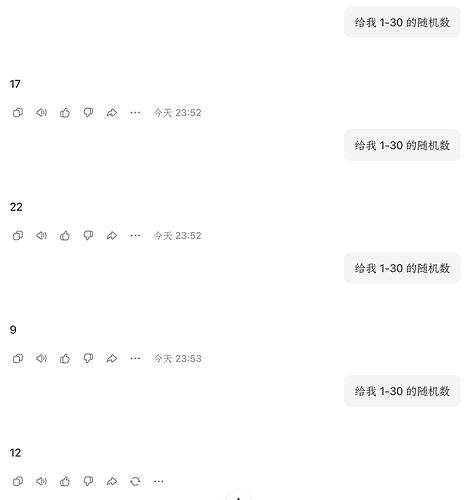
豆包开三次会话,全都是 17,测试的时候记得隔离上下文,而且同一个会话,给的第二个数是 9 或者 22 的概率很大
- XUMUMI2026-09-05