- Zilize2026-10-19
设计动机
人工智能领域的论文进入爆发式增长,数量越来越多,文献检索也面临着很大的挑战。我个人在使用 General/Coding Agent 进行文献检索(寻找相关工作或者领域梳理)的时能体验到的局限性:
- 通用 agent 通过黑盒 web search api 进行开放网络检索,通常只能拿到 top-k ,难以穷举并且难以回答“这里领域有多少篇论文”的问题;
- 通用 agent 通过 search api 进行的检索噪音大,返回的内容是整个互联网的相关性条目,需要花费额外的开销进行数据清洗和整理;
上述局限性导致 agent 在查找文献的时候浅尝辄止,或者开销大/速度慢。所以在上半年的时候我给自己 vibe coding 了一套 arXiv 元数据抓取->向量化->关键词或语义召回->LLM 精筛的管线。但成本仍然比较高,并且精筛时候速度很慢,用起来不怎么顺手。
九月中旬的时候 Jev 横空出世,我意识到非常适合用来做召回后的文献精筛和分类,于是就开始重构自己的文献基础设施,把它迁移到 Jev 上来。可以先通过一张 GIF 示意图感受精筛的速度:
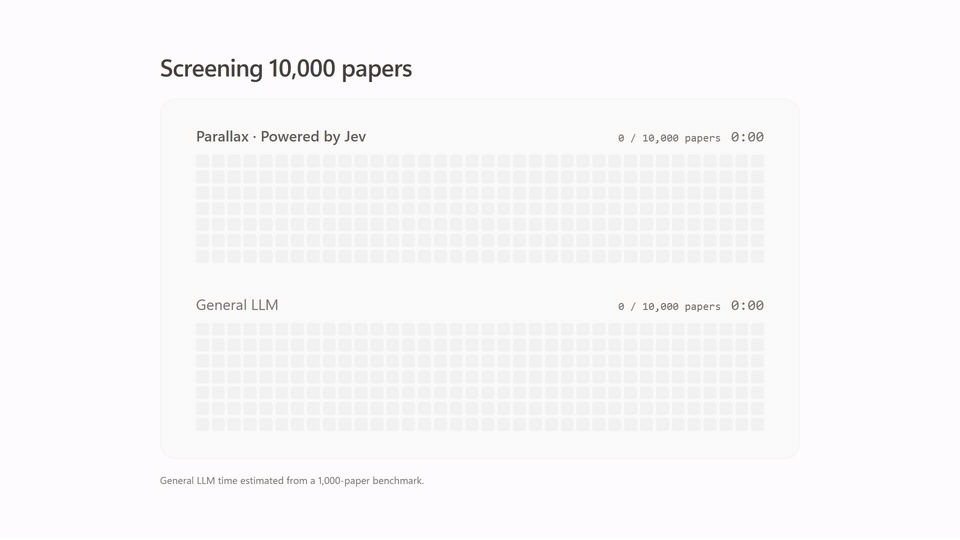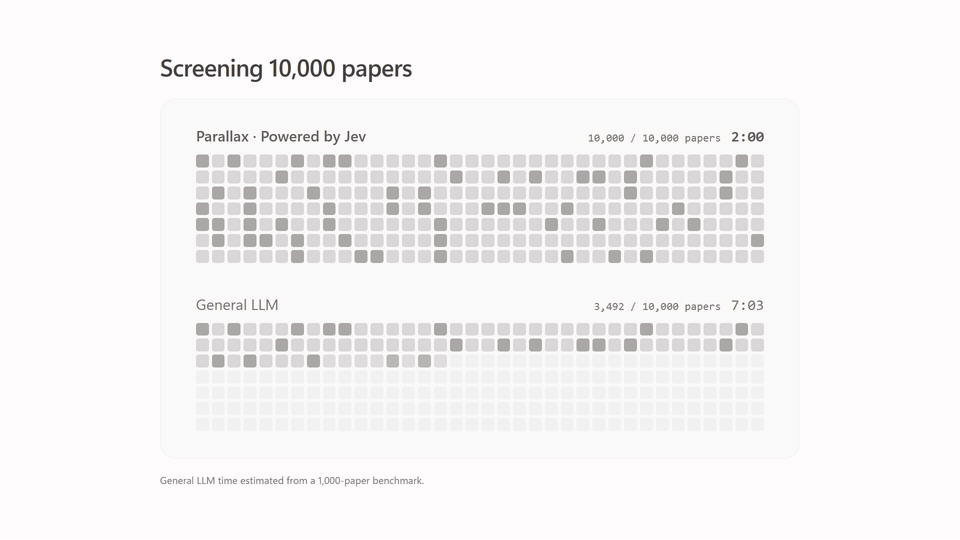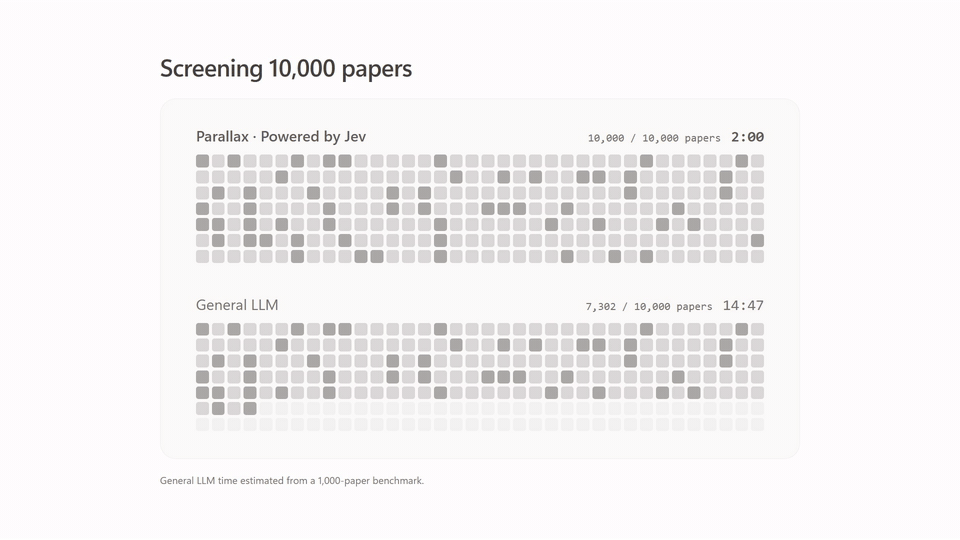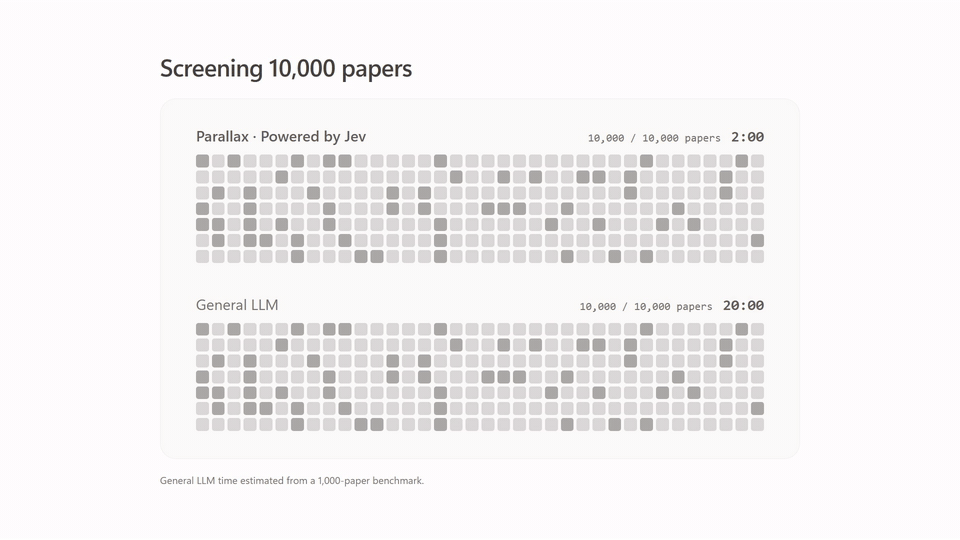
我把这个系统命名为 Parallax ,其实它不止是一个文献检索工具,还包括了一系列的论文阅读、综述产出工作流。项目已投入生产环境,欢迎注册试用: https://parallax.ink
下面将继续介绍系统搭建时的一些设计和感悟。
检索结构
曾过一段时间的推荐算法但没太接触过 Agentic Search 领域,还带着点相关的思维定势,所以最初的设想是通过一个漏斗式的结构完成召回、粗筛、精筛。后来发现论文检索的特点跟信息流推荐还很不一样:
- 需要扩增:论文存在引用关系,通过一篇早期文章的引用关系进行扩增检索是很常见的手段
- 需要补充:不管是人还是 Agent 进行检索的过程都会有疏漏的可能,所以在初次检索完成后还要进行复核,看看是否有不合适的条目被纳入,或者是否有早些关注到的标记点被遗漏
这样的话漏斗式的检索显然就不够用了,结合多路召回所需的合并去重、假阳性需要批量剔除,我发现集合运算是解决这个问题的良好数据结构,因此就将整套检索的底层架构用集合代数的接口重写了一遍。
因此检索结构设计为:Agentic 操作的基本单元是论文集合(满足确定性、互异性、无序性的基本属性),支持并集、差集等基本的集合运算符;同时引入了一些实用的功能性对象或算子:
- 虚拟根:用一个虚拟对象表示检索起点,比如全库论文集合、arXiv 每日公告的论文集合;使用虚拟根是为了避免对大规模条目进行持久化,占用过多存储空间
- 规则过滤:通过 arXiv 分类标签、时间窗口、资源种类、embedding 相似度、关键词检索等条件进行论文条目过滤
- AI 精筛:利用 Jev/LLM 进行条件判定,条件是由 agent 根据用户意图生成的
- AI 分类:利用 Jev 的多标签概率判定接口进行分类,不过一篇论文可以同时归属两个分类,所以这块的分类没有设计互斥性
我把整个检索系统用节点图的形式进行可视化,前端使用 ReactFlow 构建。节点图的形式足够灵活,能够应对各种不同的生产需求。

于是一个典型的节点工作流如上图所示:使用关键词或者语义检索进行多路召回,然后用并集算子进行合并去重得到一个规模较大的候选集,扔到 AI 精筛节点调用 Jev 进行精筛(目前判定阈值硬编码为 0.5 ),再通过 AI 分类节点进行主题分类。
在 DeepSeek-Flash 模型实测中大部分时候 Agent 会依照典型的工作流进行检索,但面临更大规模更复杂的检索需求,Agent 可能会在复核过程中发现工作疏漏,构建用于弥补的新集合,反复调试出“最终版”集合,再进入下一步分类阶段,从而构建出跟电路图一样复杂的工作流:
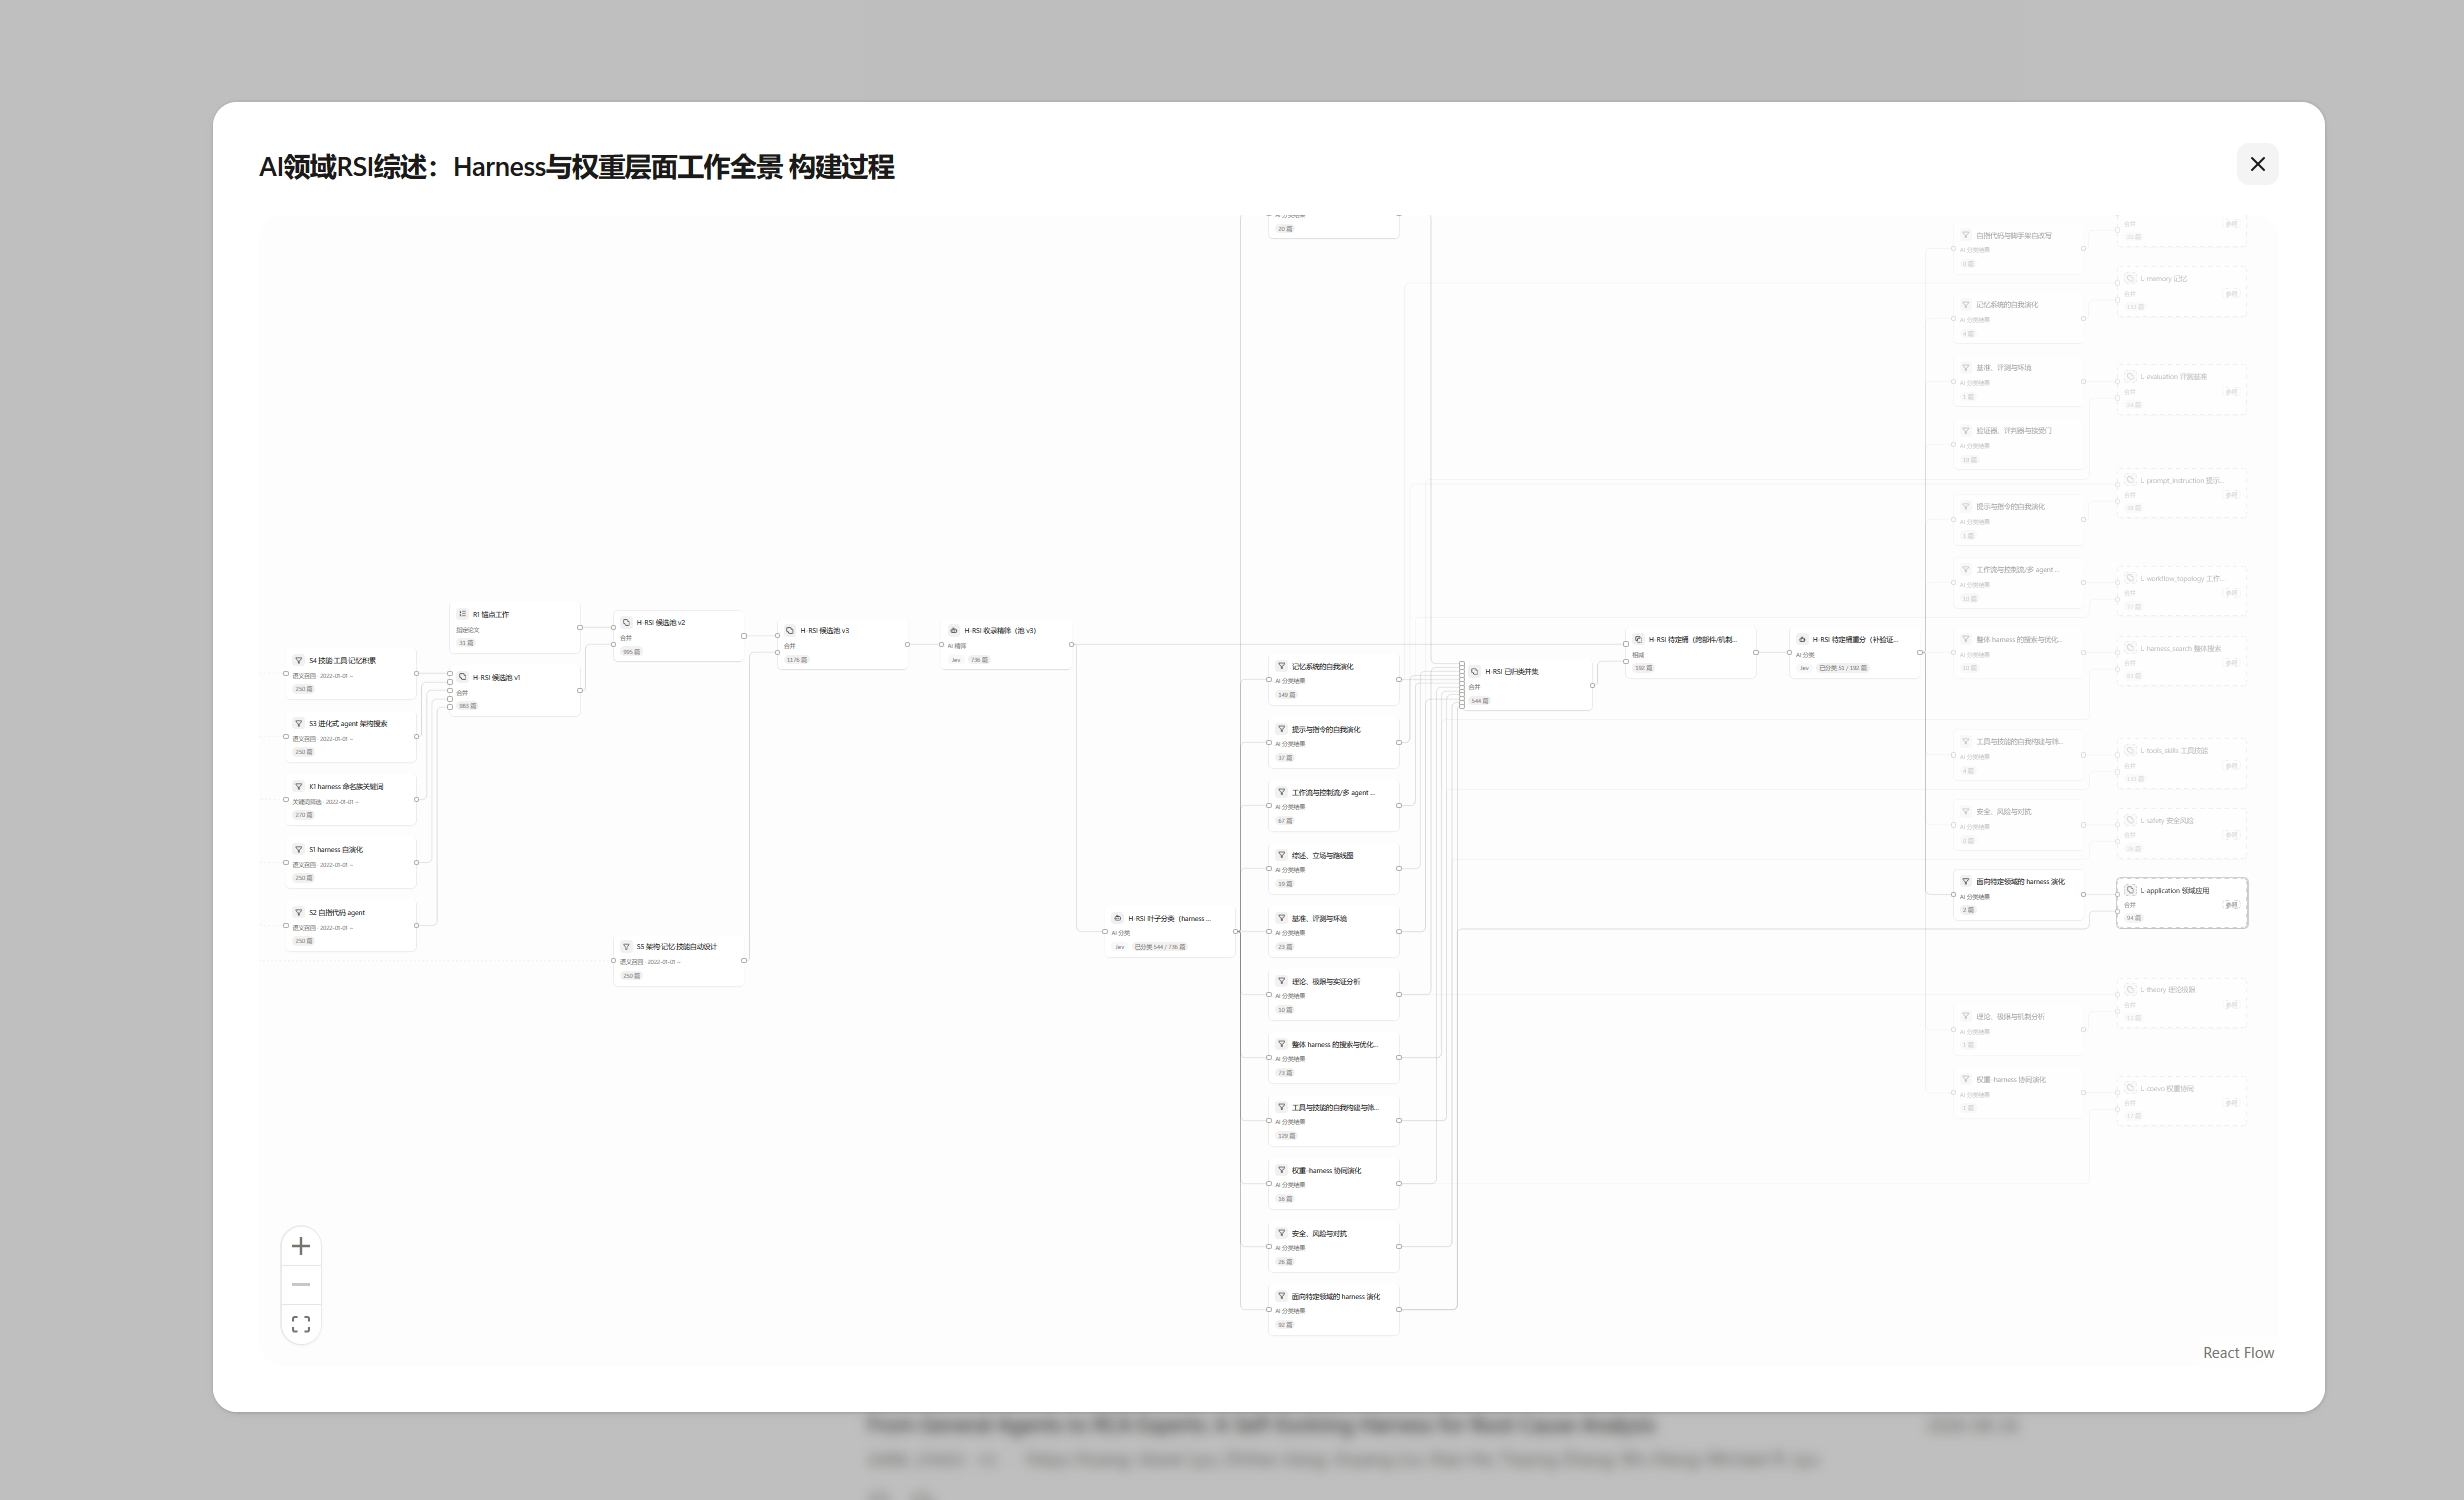
相比于 General/Coding Agent 的文本文件记账直接处理、结构化标记语言( XML/JSON )记账脚本处理,建立在数据库和索引基础上的集合记账能够实现更大规模、更高效的处理;并且将这种大规模处理任务委托给确定性的程序,能够对抗模型的幻觉或者上下文压缩过程中的记忆细节丢失。集合数据结构还可以进一步扩展统计分析接口,以满足更加精细的数据洞察需求。
性能和成本
其实上述的思路非常自然,ComfyUI 等低代码节点图工作流已经深入人心,在很多人的脑海中应该都浮现过类似的文献检索思路。但是让这样的系统能够投入生产使用,最大的问题不是数据抽象,而是面临较大规模数据时的性能优化,以及如何平衡速度、成本、效果这几个维度。
Parallax 目前通过 OAI 接口抓取了 arXiv 下 cs.*分类自 2020 年来的元数据更新,大概有 82 万篇,元数据及其索引约占 7.8GB ;为了实现语义召回,系统接入 Perplerxity 的完成语义嵌入,向量比元数据重得多。每篇论文的摘要经 pplx-embed-v1-0.6b 嵌入成 1024 维向量。按 float32 算单条 4KB ,82 万篇理论上约 3.3GB ;如果压成 halfvec 半精度表示,单条 2KB 共计约 1.65GB 。但这只是裸数据大小。真正落到 PostgreSQL+pgvector 里,为了同时满足精确和快速两个目标,向量实际存了多份,加上索引的总占用达到了约 17GB 。
关于系统的一些优化手段:
- 精确语义检索的召回分批:直接跑一条大规模召回 SQL 时长不可控,并且发生中断缺乏检查点又要重新跑,因此对召回语句按时间窗口进行分批检索 top-K ,最后合并再取总 top-K ,精确性得以确保;分批会带来一定的额外时间开销,但是系统可靠性和资源可控性都获得了提升。
- 近似最近邻( ANN ):系统实测发现在 top-K 召回任务下,随着 K 的增加,召回率相比于精确算法会下降,这是由于 HNSW 索引本身的特点导致的;因此我们采用的策略是在较小的 K 时采用 ANN 进行加速,能从精确版本所需的十多秒降至几秒,并且召回准确率能保持在 90%以上。
- Jev 的批处理和并发:我们的精筛和分类都使用 Jev 的 noul 元语实现,分类也使用 noul 是面向论文主题的多标签场景;在实现上,对同一个节点任务在后台切分批次,并发推进,精筛和分类的批大小并不是固定的,而是根据 Jev 的上下文窗口和当前批内元数据 token 长度自适应调整。
相比于最初使用的 DeepSeek-Flash 进行精筛,九月下旬切换到 Jev 后在生产服务器上实测,新管线对 36,564 篇论文进行精筛判定只花了 5 分钟左右,是 LLM 版本速度的 10+倍,而成本只有不到五分之一。
为什么 LLM 的成本会高延迟会低?因为我们设计的管线会收集判定审计信息(概率或者原因),LLM 并非直接输出 true 或者 false ,而是输出一个带判定结果和原因的 JSON 。如果打开模型的 CoT 思考,模型的思考长度不可控故而延迟不可控;如果关闭模型的 CoT 思考,又会导致批处理时时常出现 JSON 格式错误,要么整批作废重试、要么聚集错误结果开新批次。不管怎么样,在专门为 type-safe 设计的 Jev 面前,LLM 都并非解决这个问题的首选。
实测效果
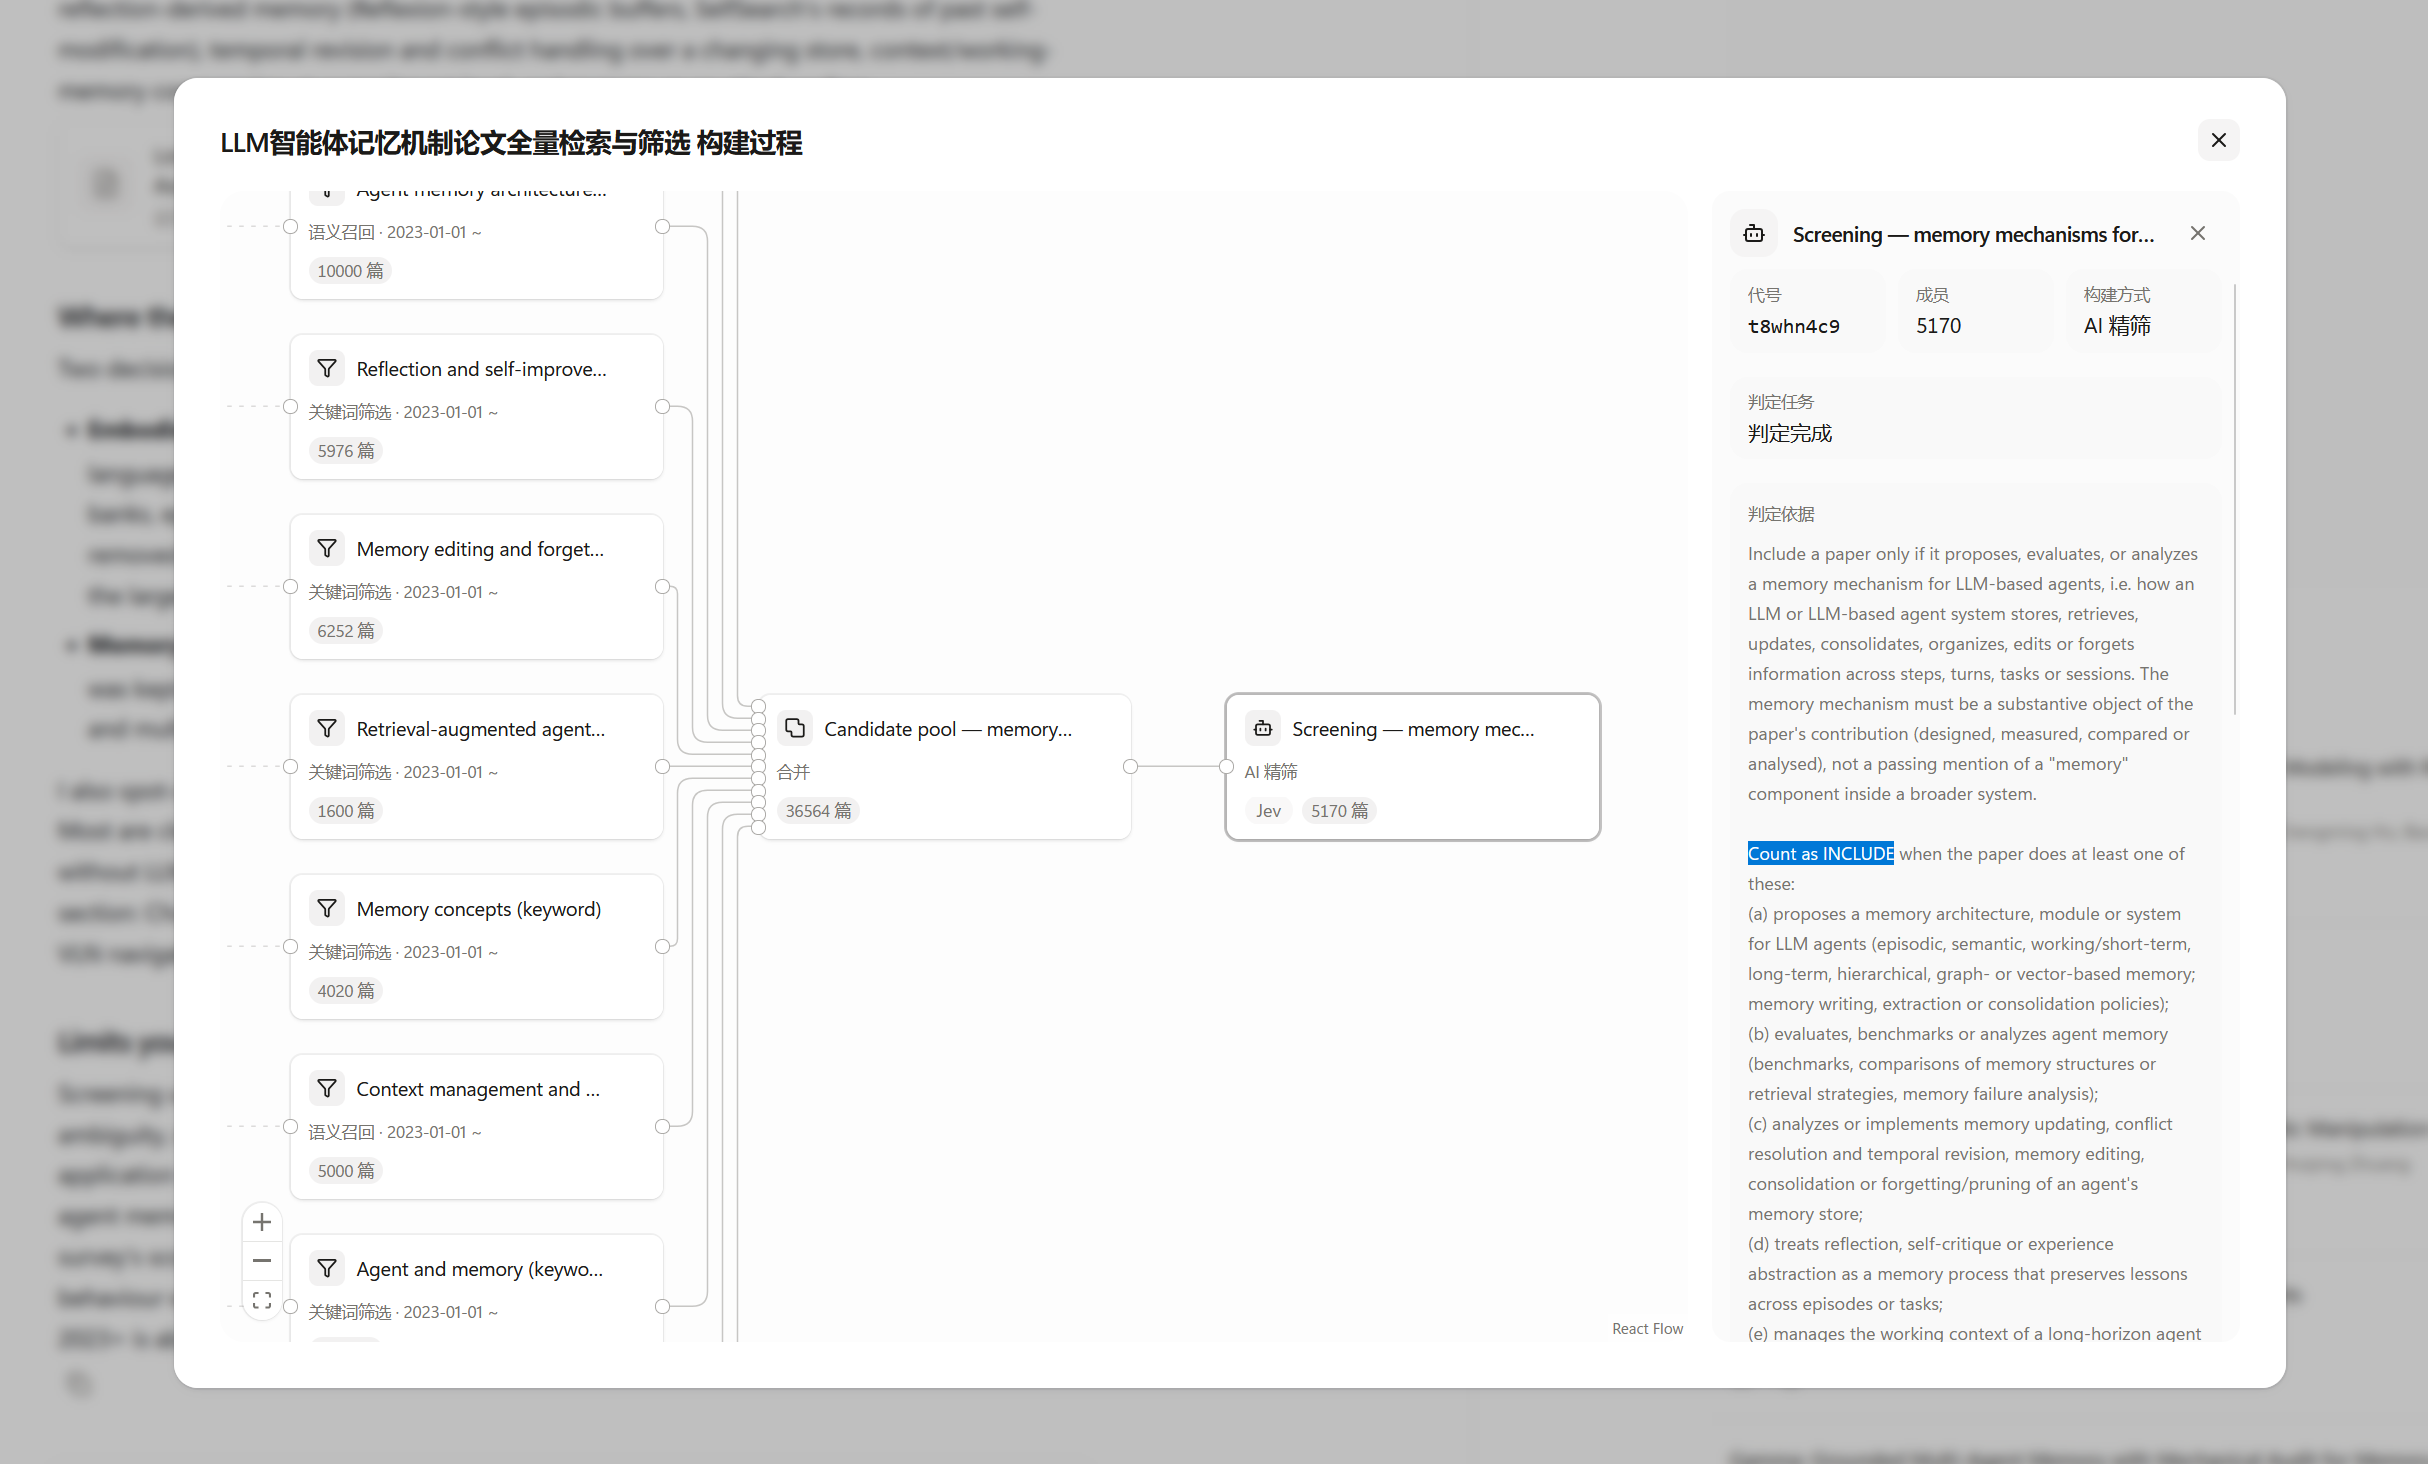
在一个“LLM 智能体记忆机制”主题的论文检索案例中,Agent 会先根据用户提供的线索对库中的论文进行低成本探针( probe )调研搞清楚论文的大致分布情况,然后创建 6 路关键词+5 路语义召回,合并后得到三万多篇候选文献; Agent 会拟定提供给 Jev 进行判定的业务标准,什么样的论文可以被纳入( include ),什么样的论文需要被剔除( exclude ),然后提交后台进行并发批处理判定。
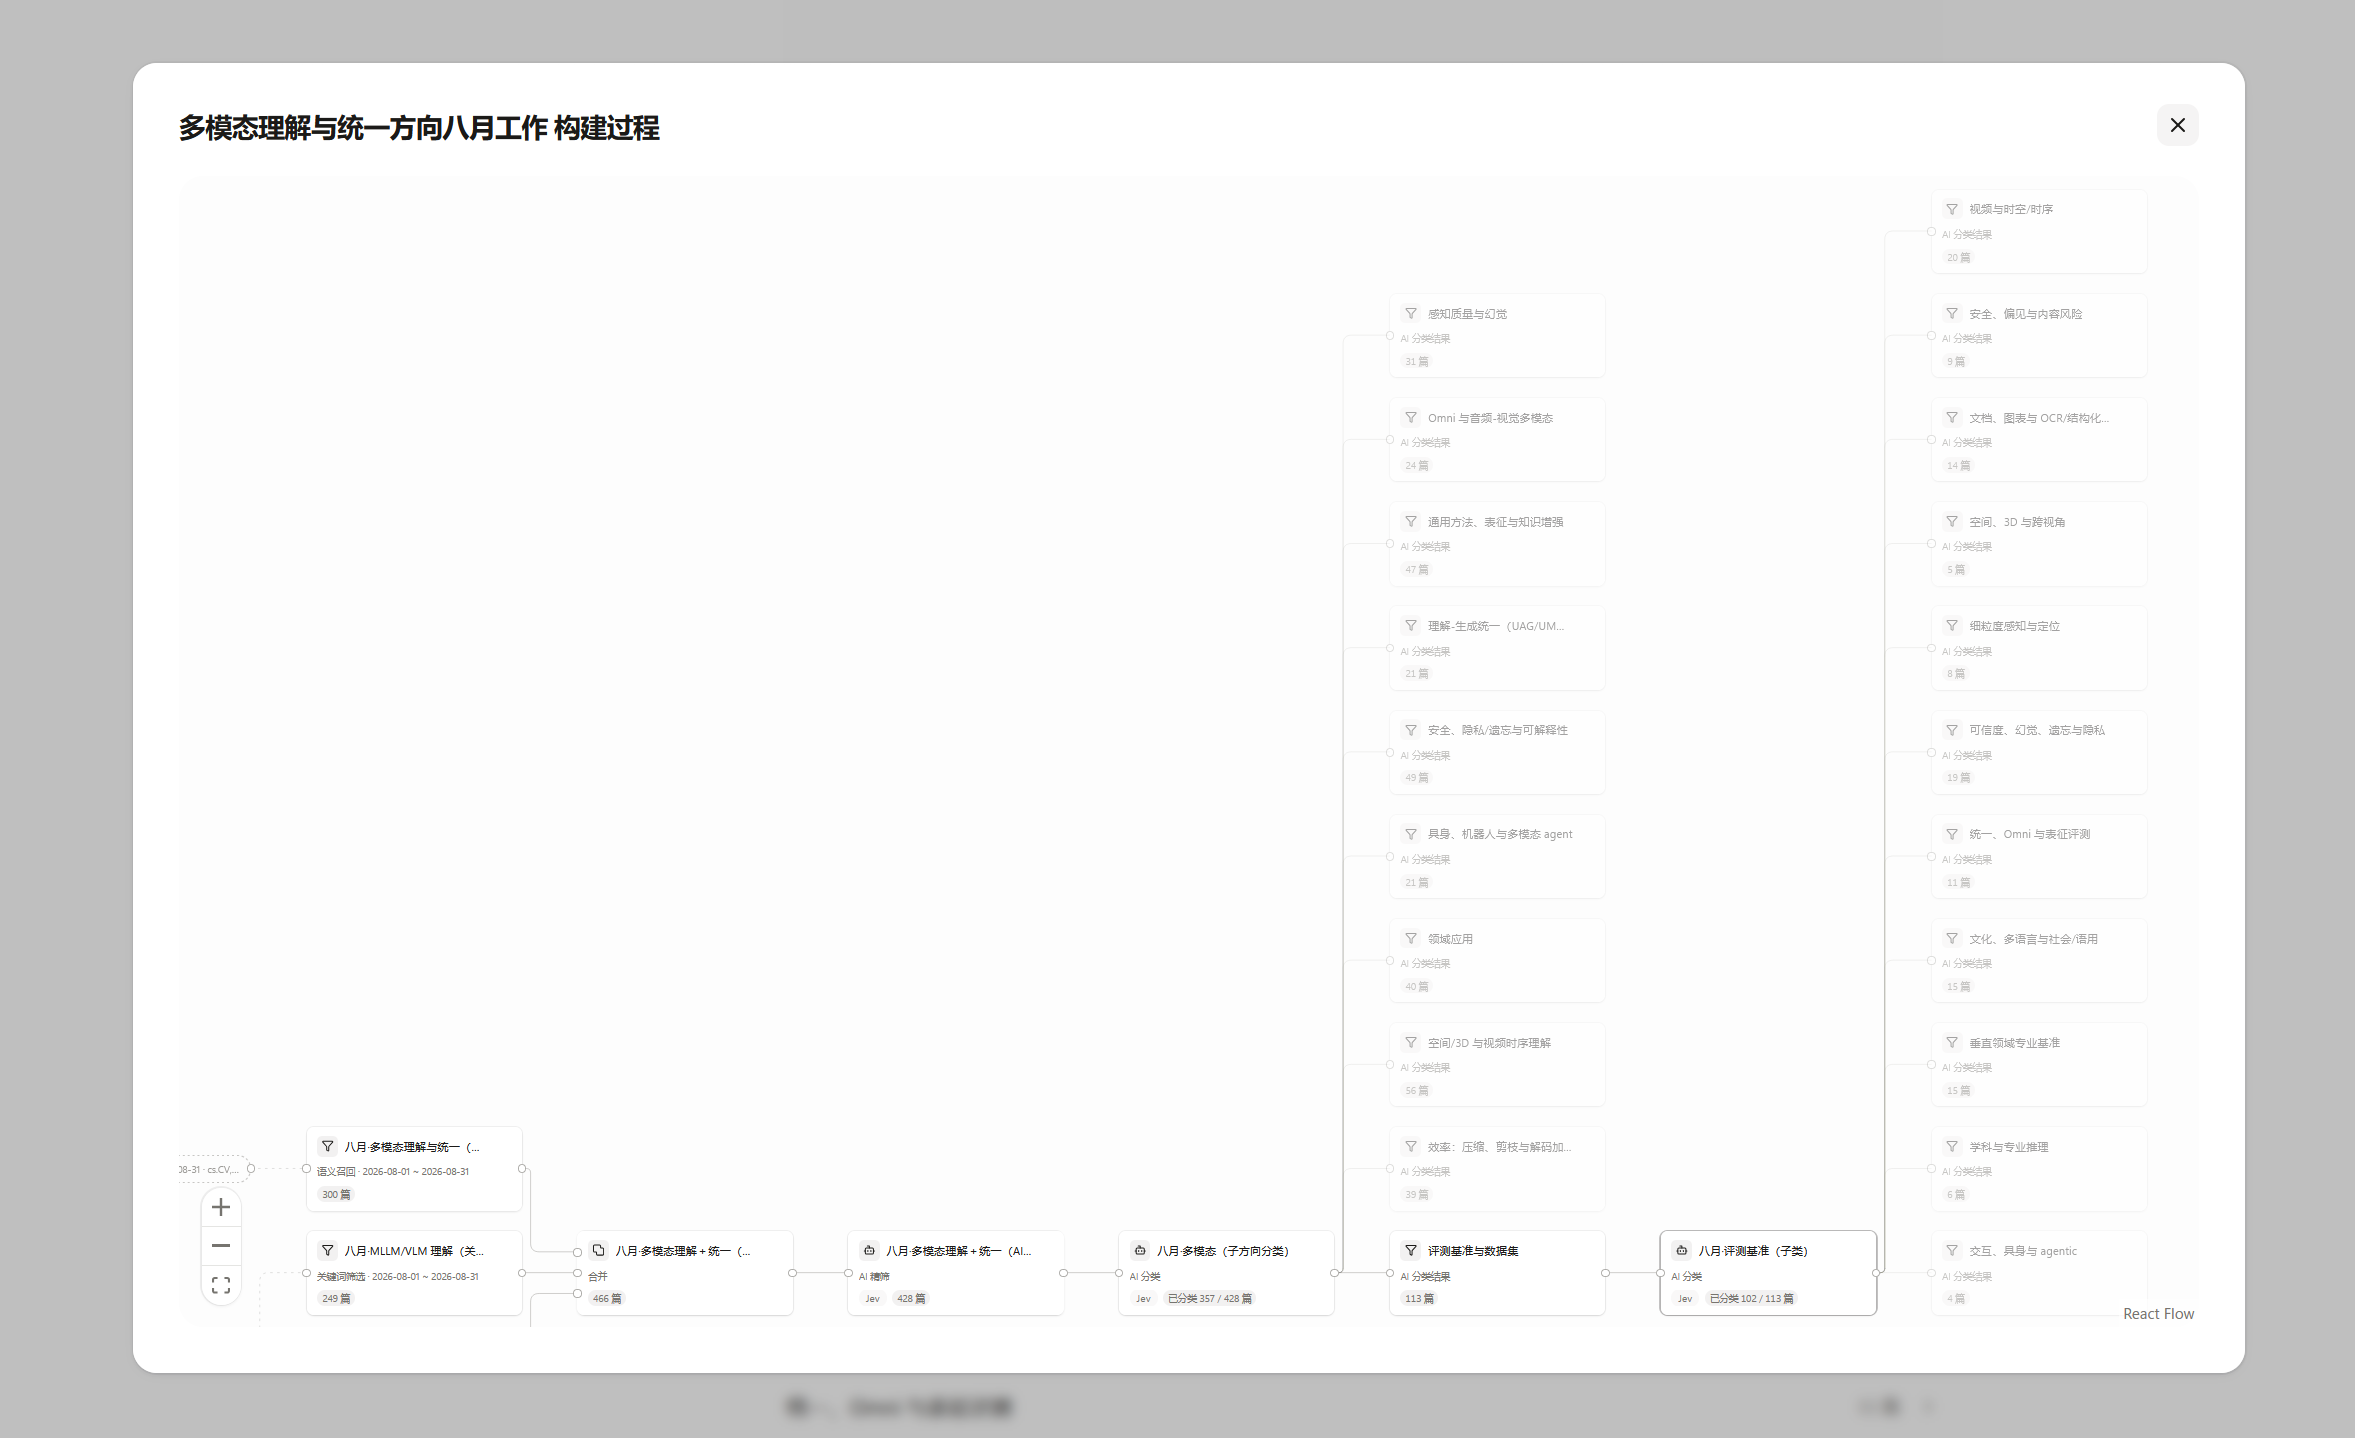
而在另一个“多模态理解与统一多模态方向八月份工作梳理”主题的检索任务中,Agent 通过三路关键词和语义召回得到 466 篇候选文献后进入精筛管线得到 428 篇匹配主题的论文,接着 Agent 读取集合条目标题拟定分类目录后,调用 Jev 分类节点进行分类,得到评测基准与数据集、具身智能、安全隐私、理解生成统一等 10 类。
用户指出评测基准这类还有一百多篇,可以进一步细分,Agent 就继续探查条目,对评测子集进行进一步细分,得到 11 个类别的评测基准与数据子类别。分类过程中 Jev 会提供论文条目关于每一类分类判定标准的纳入概率,这些概率信息都会被持久化到数据库中以供用户和 Agent 审查。
集成工作流
为了让检索的结果能够更便捷地转化为用户对于论文的理解和对领域的洞察,我在数据与检索基础设施之上,构建了整套云原生的 Agentic Workflow 。产品追求智能体原生,所以为所有功能都设计了供 Agent 调用的工具入口;而人类目前仍然需要在学术研究场景进行深度介入,所以我们仍重视用户的交互习惯与系统的可观测性,为大部分功能都构建了可视化的 UI 面板(比如更适合文献阅读场景的衬线+两端对齐阅读排版)。
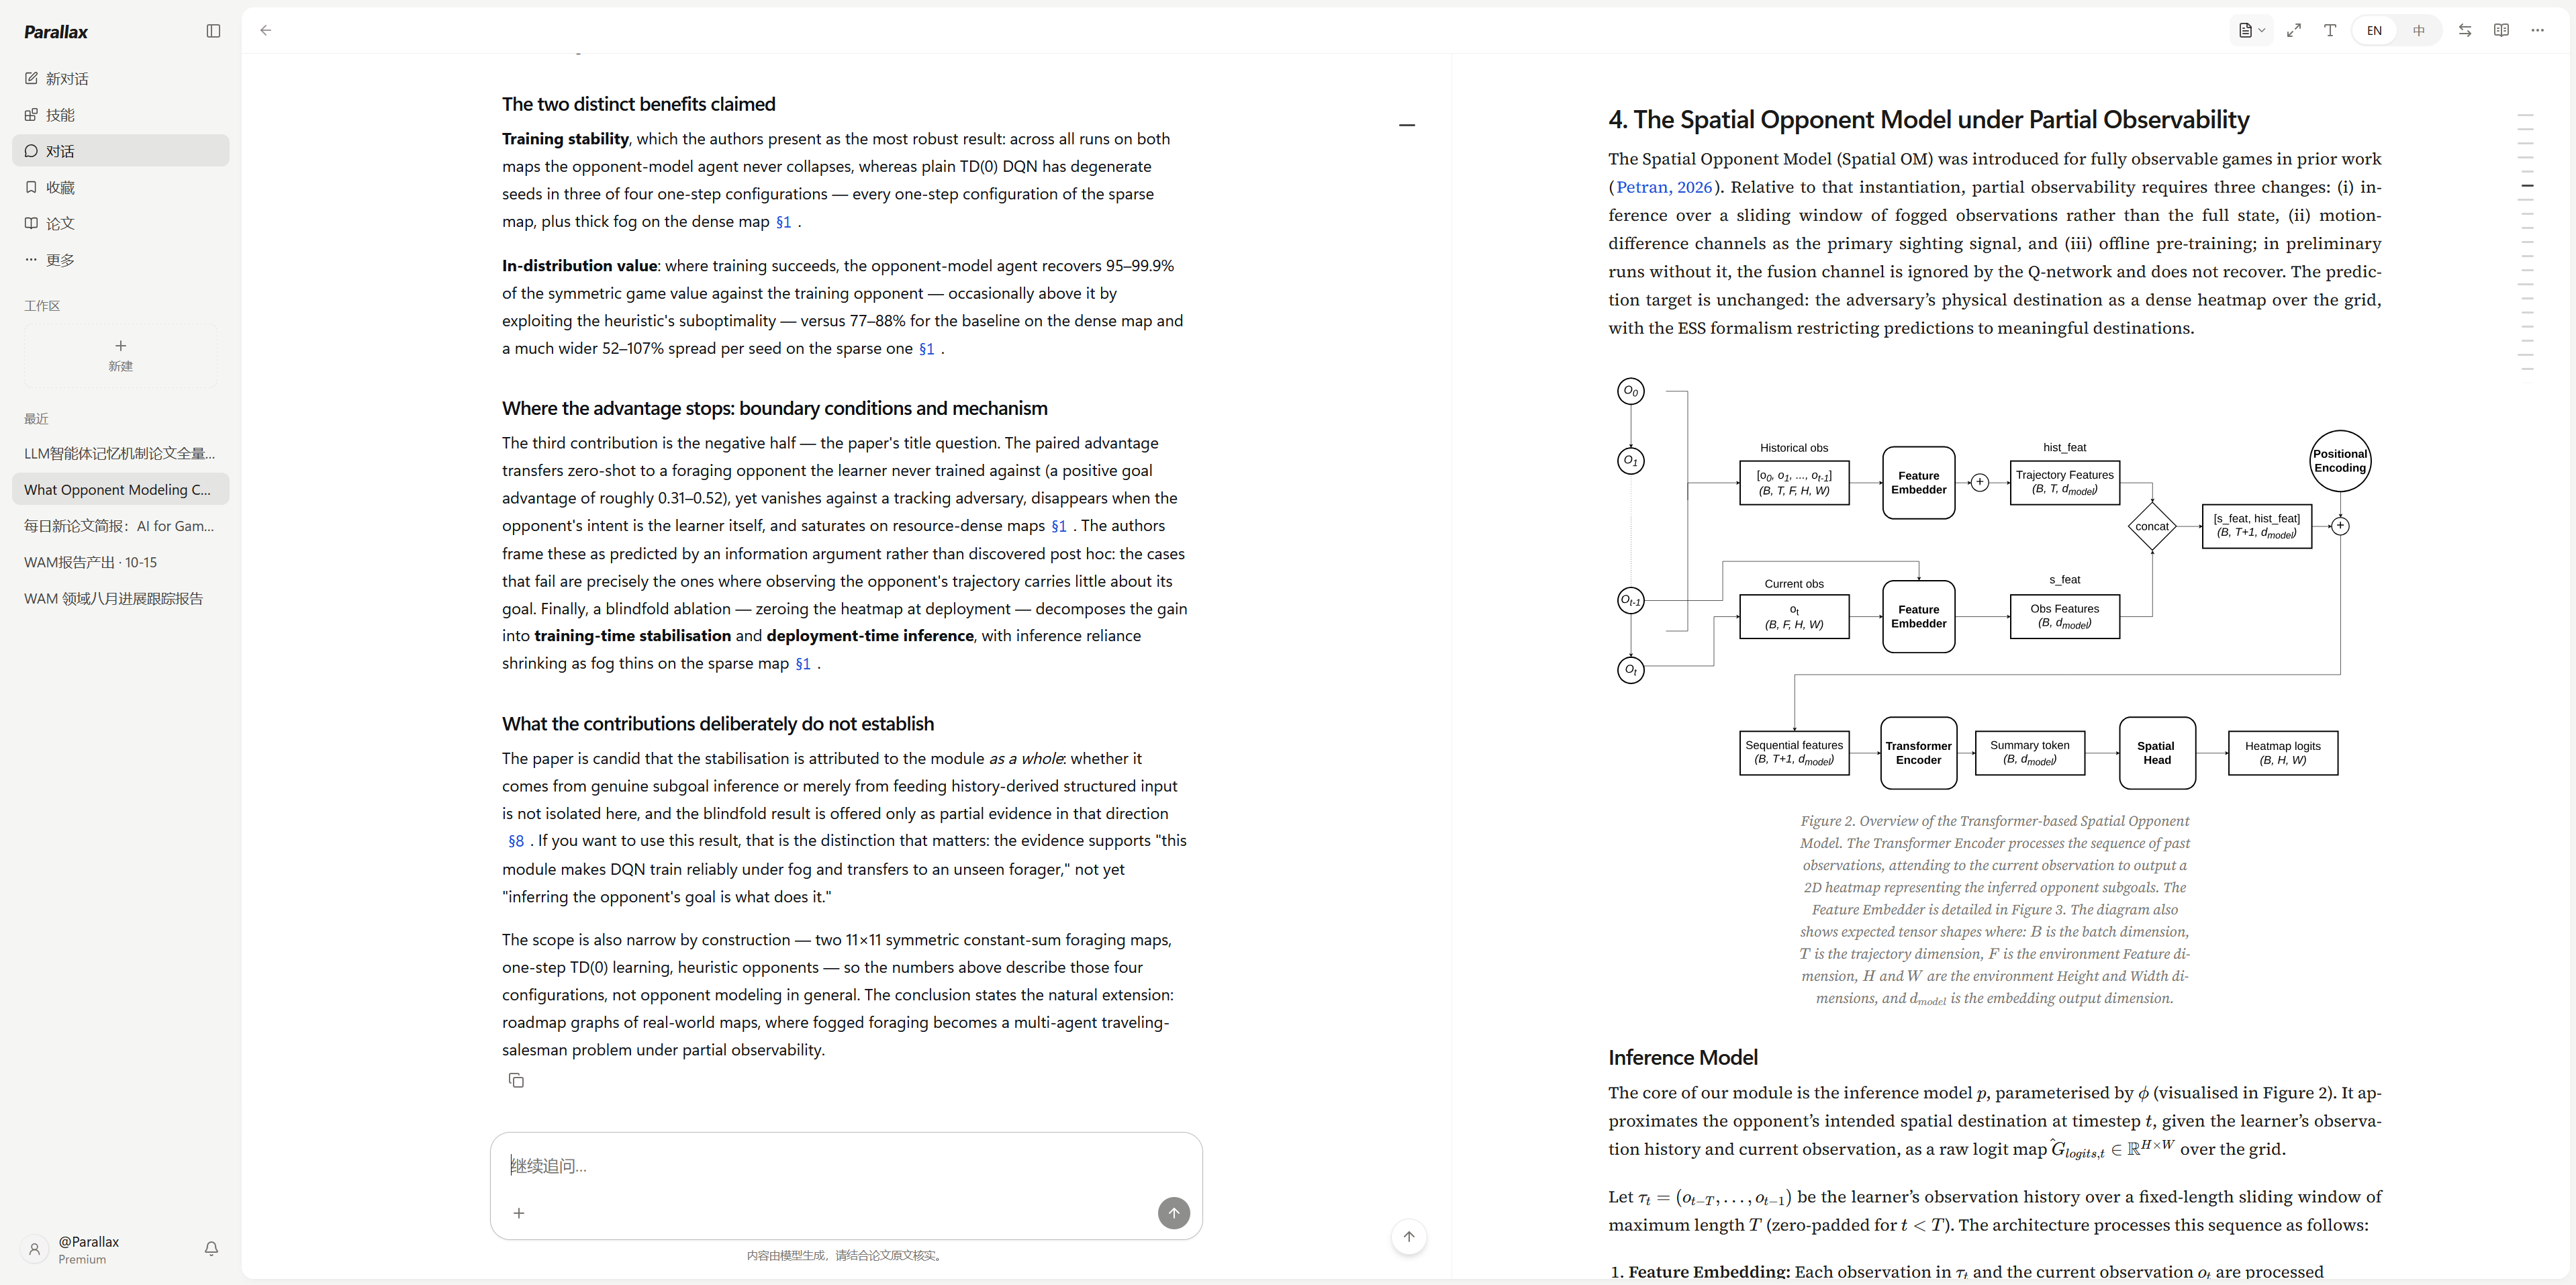
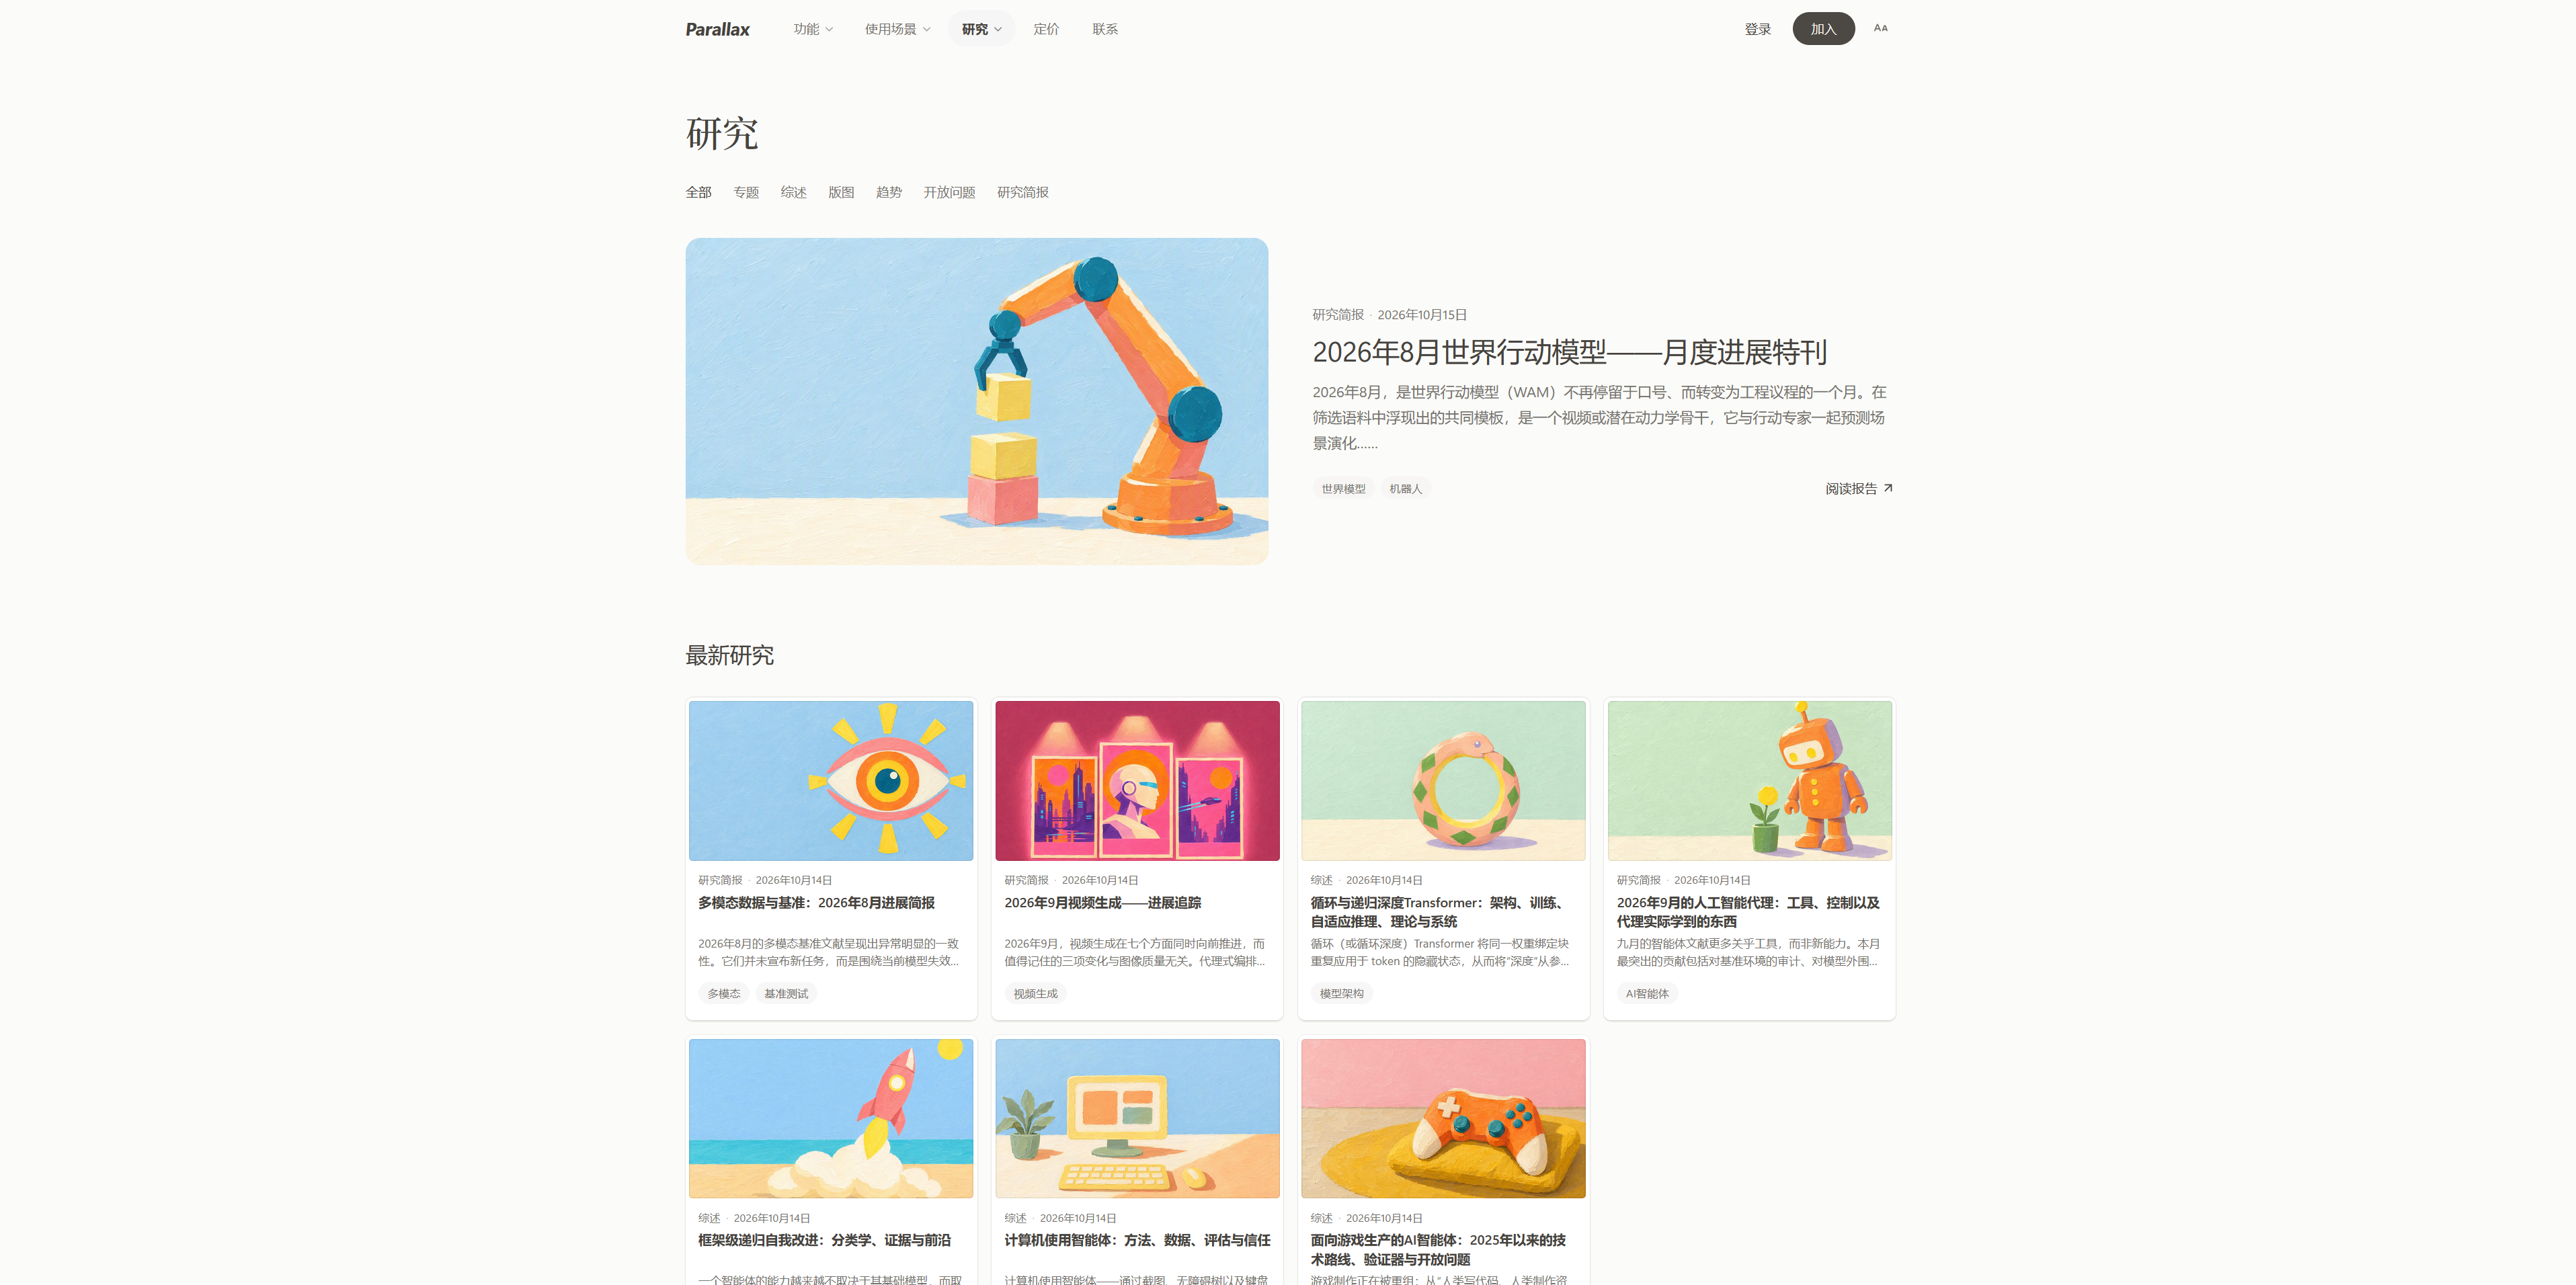
用户可以利用 Parallax 提供的技能,直接产出领域研究综述、每日/每周/每月进展跟踪报告:
Why Parallax?
Why Parallax?
为什么要设计 Parallax ?在 RSI 真正到来、AI 领域论文的价值完全消散之前,对于 Frontier Lab 以外的学者、学生或开发者来说,arXiv 上的论文仍然是第一手的领域信息来源;但现在论文的产出量越来越大、文献所涵盖的总体洞察越来越多,但是人们却越来越难以获得与论文增长相匹配的、对领域洞察和理解的增长。我希望能找全文献,看看整个领域或者某个我所关注的细分方向,在空间或者时间维度上发生了什么,要做到这一点就只能对全量论文做快速的召回扫描,而无法仅仅通过 Google Search 或者 arXiv Search 的 top-K 结果来实现这一点。“找全文献”这件事情的需求,从 GitHub 上琳琅满目的 awesome paper list 就可见一斑;而设计 Parallax 就是为了能快速自助产出 awesome paper list ,并且通过更易用的数据接口和更聚焦的上下文管理来在此基础上更全面地理解领域发生或者正在发生的事情。
我一年半之前还在游戏行业工作的时候曾看过用户研究部门的分享,介绍他们是如何助力游戏战投部门的工作的。游戏玩得多的人都知道,游戏的品类是很难定义的,因为玩法之间的分类往往是模糊的,而一款游戏可以有很多种玩法,品类定义起来也更加麻烦。但是定义品类、预测品类的走向又是用户研究和战略投资绕不开的课题,因为每隔一段时间就会有一种新品类在市面上流行起来,对于大厂来说对未来可能的新品类进行提前布局是必要的商业手段。那如何解决这个问题呢?
Steam 以及一些游戏直播平台上有大量的游戏评价数据,并且 Steam 游戏的标签系统是用户共建的。通过建设评价数据和标签的实时观测系统,能够看到一种标签或者评论区中的概括是如何从零碎的短语,演变成为大部分玩家的共同描述手段,从而成为一种新的“品类”。比如“魂-like”或者“类银河战士恶魔城游戏”就是从用户标签或者评价中起源,并逐步演变为约定俗成的正式品类名称;而最初用户想表达的意思仅仅只是“该款游戏的玩法像银河战士和恶魔城”或者“游戏的操作难度和叙事像黑魂”。
而 arXiv 文献数量的暴涨,也让 AI 学术研究进入了高频、高动态的时期;而 Jev 的到来让我发现能够通过一种更加低成本的方式来灵活地观察领域的变化和动向。
Parallax 现在已经上线生产环境,欢迎来访使用: https://parallax.ink
主楼 - 暂无回复