- littleblack_LB2026-09-10
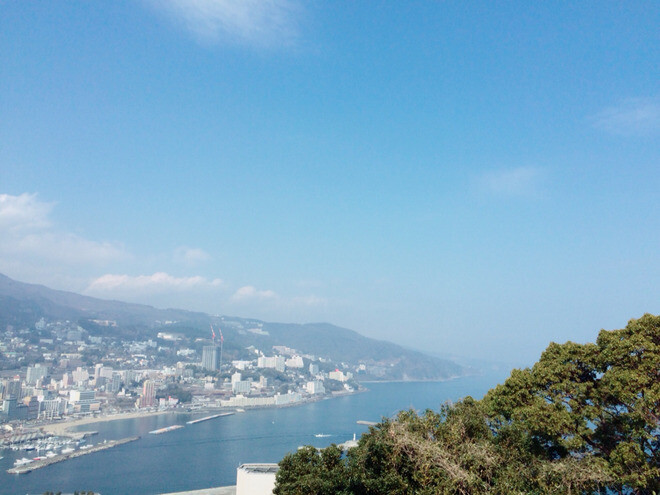
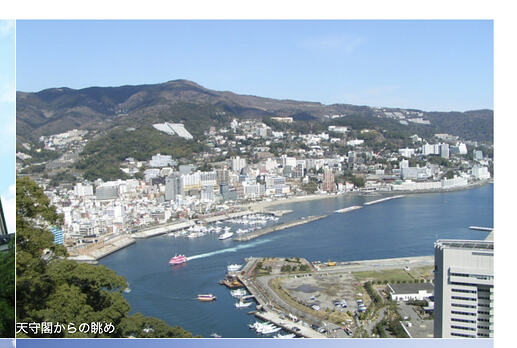
今天看到一张在日本拍的图,出于好奇就丢给 GPT 让它反向定位,结果还真给找出来了…
其实 Gemini 之类我让朋友 @ZhFuwe 也试了。如果完全不给工具,它们也能直接猜个八九不离十,因为这张图本身对应的景点比较出名,画面里也有一些明显特征。(gpt 也是一样的)
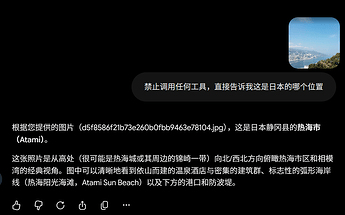
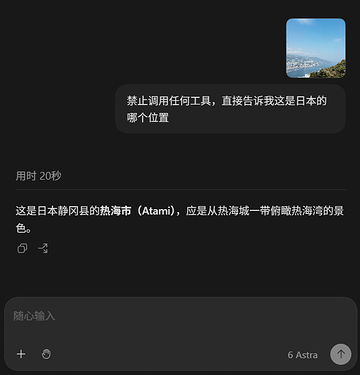
但最震撼的是我开放搜索能力之后,它就去网上搜图,然后拿检索到的图片和我这张图做视觉匹配。
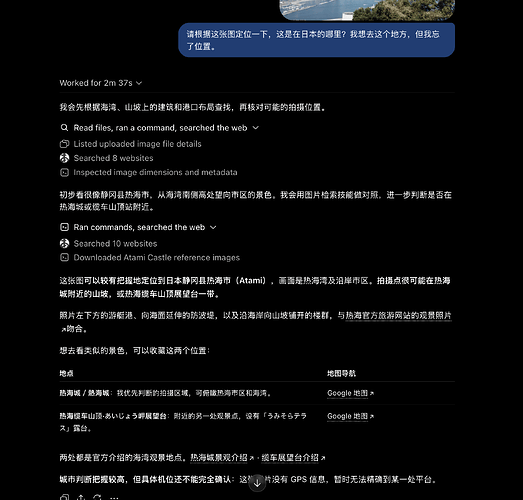
我后来专门看了下它找到的参考图,和我提供的图片在角度、构图上其实差得还挺大的,但它依然能把场景对应上。感觉这里是真的比较吃多模态 Vision 能力。
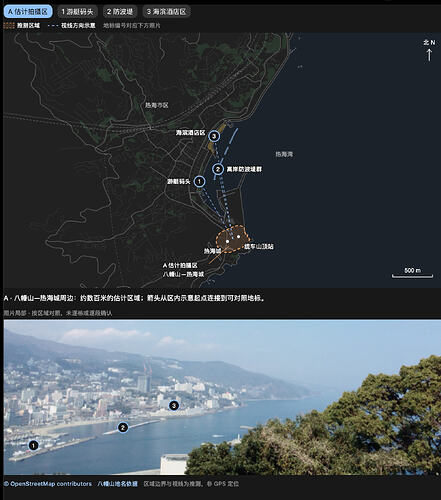
后面我又让它把推测地点和周围几个参照位置直接标到地图上,结果也挺准的。
这种任务感觉还挺适合拿来测模型视觉能力的。感兴趣的佬也可以拿 Sol 或其他模型试试, Astra 这次的效果有点震撼吧。
AGI has come (
ChatGPT
See what I’ve been working on
Someone shared part of their work with you.
主楼 - HGWXX13792026-09-10
这种题豆包基本也能稳定做对的,即使限定不用搜图
- ZhFuwe2026-09-10
其实是影视飓风2月9日的视频让我怀疑AI是否有这样的能力。六分钟的时候Seedance直接推理出了镜头背后的画面。
- littleblack_LB2026-09-10
对的,其实我也是蛮惊讶的,我以前觉得 llm 文字预测能做得这么强,已经很出乎意料了。没想到换到视觉方面也能有这样的效果。
- littleblack_LB2026-09-10
酱紫,还是蛮惊讶的,因为之前没怎么玩过,没想到这个多模态视觉能力特别强悍。