- calendar2026-09-10
还是……做不到吗?ds 系列就像一条毛毛虫,慢慢向上蠕动
主楼 - apparition2026-09-10
- person2026-09-10
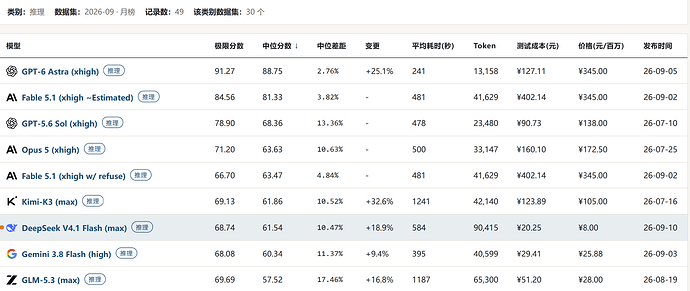
比不上glm-5.3-flash?
- kimi2026-09-10
- lanvent2026-09-10
试试dsh吧,可能又训得过拟合了
- listening2026-09-10
- 白学森2026-09-10
- undefined2026-09-10
- unsafetrait2026-09-10
- Jiopaaaaa2026-09-10
个人体感DeepSeek的还是比glm5.3-flash要好用些,某次任务glm5.3-flash疯狂的来雷霆大思考,干思考不干活儿……还是换了DeepSeek pro快速的响应处理了
- EAR_EAC2026-09-10
嘶。。。这么低吗?我体感感觉是比glm5.3flash好的哇
- wayned2026-09-10
Gemini 3.7 Flash 和 GLM 5.3 Flash 的位置和我的体感有点差距,我感觉 V41F 可能比这两个好一点,当然也可能是场景差异
Gemini 我感觉主要是短小的任务能力尚可,稍微长一点的任务就容易偏离了
GLM 5.3 Flash 则是通过雷霆大思考,时间换的效果,不过鉴于价格便宜,倒是一个比较甜品的模型
其他的感觉差距不太大
- 君葯2026-09-10
看到
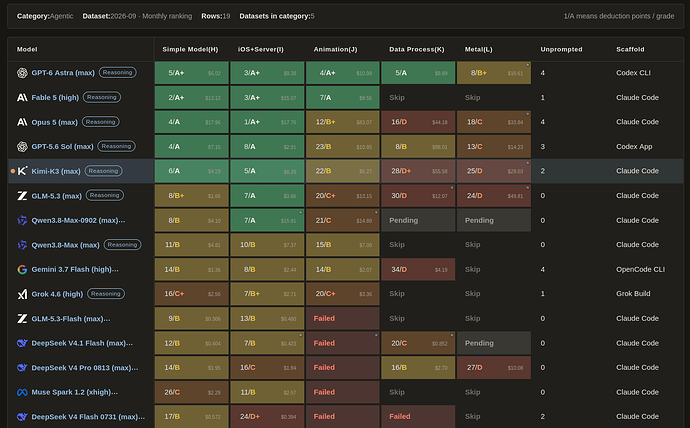
鲲3.8Max排在中游就没必要继续看了,这个榜单无非两种情况①偏科严重②刷分方便但没有针对训练。今天项目跑了一天从GLM-5.3-Flash 切到DP4.1体感提升不少 - Kassdin2026-09-10
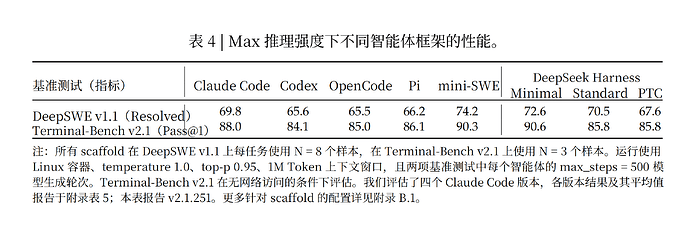
Deepswe 一百道题都快成野榜了,nao 这常年不变五道题是不是有点草台了^-^
- Procyon2026-09-10
- 汉武帝(的大熊猫)2026-09-10
DDDD 声量大的不一定真的好. 现今互联网现状如此. 有些因为太烂挨骂, 有些因为好被骂.
- listening2026-09-10
nao 这常年不变五道题是不是有点草台了
前面有人怀疑公正性/准确性或许还有点道理(毕竟规模还是有限的),但你这里说“常年不变五道题”就是纯云了,J/K/L都是新题。
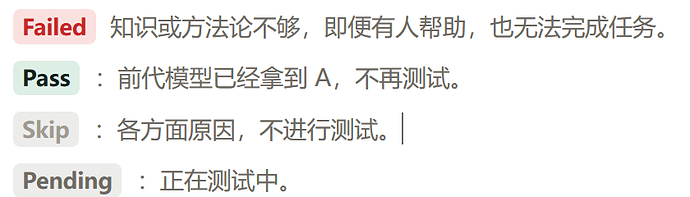
glm5.3flash为什么排的高一位呢?它是8月末发布的,没测K/L。(排序不绝对)
- 9962026-09-10
请问佬们deepseek v4.1 flash 打得过腾讯的hy4吗
- nuJC02026-09-10
这个博主就是hy员工,所以榜里没有,按照他的测试集应该和glm5.3差不多
- 越rrdvdfvd2026-09-10
榜里的qwen和gemini实战中都没人长期用,何必加上去