- 冰原Bill2026-09-11
正在做的一个项目需要把大量爬取到的知识通过重组、提炼、风格重塑成知识卡片。
输入提示词提供了清晰的栏目划分、话术参考、数值提取规范、范文。整体经过两轮压缩,压缩比大致在100:5:1。
结果小参数模型的生成结果比较糟糕,除了遵循不佳,甚至出现了乱码、数值变动等幻觉。
依旧用中文可读性较好的GLM对全部结果打分
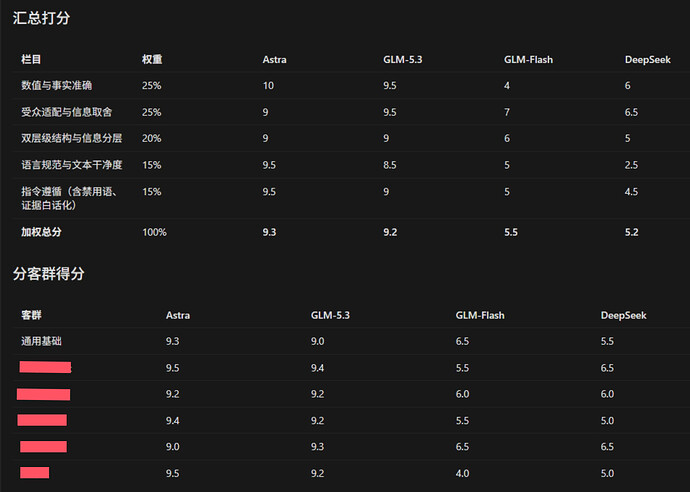 主楼
- hero2026-09-11
事实情况是不是代码。都是一如既往的差。
- Dc01152026-09-11
找到一个效果好的卡片,让 glm5.3 调度子 agent 使用 flash(提示词主 Agent 生成),每次子 Agent 只生成一个卡片(避免上下文干扰,你也提到知识很多)
通常情况下效果不会很差
- 冰原Bill2026-09-11
这个流程里单一卡片的上下文就有这么多,总共大概要跑几千个。
- unsafetrait2026-09-11
写代码还行,不差,就是前端审美不太好
- unsafetrait2026-09-11
这就是coding异化的结果,现在纯往coding靠,不管是opus还是其他模型现在写文章都很差 ^-^ deepseek v4.1 flash有大佬说写文章巨差,没有创意