- 无水硫酸铜2026-09-21
前情提要
猫猫写了一个可以在Gnome桌面上跑的带悬浮歌词的播放器~
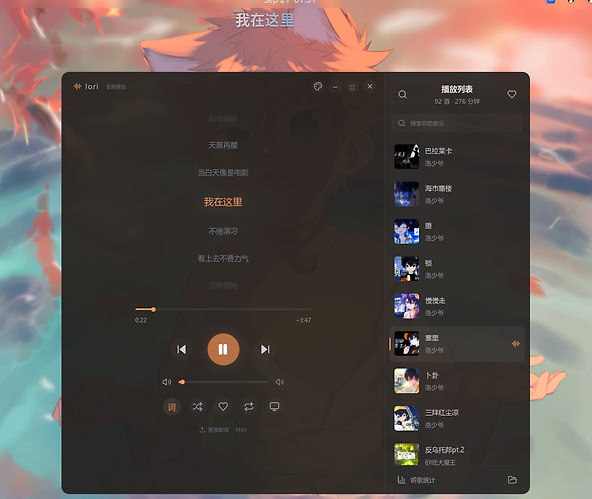
但是叭 从b站收藏夹一键爬下来的音乐里 显然是不带lrc歌词的
可恶… 猫猫手动对了一两首歌词时间轴之后就彻底力竭了w
肿么办呐… 这悬浮歌词总不能浪费了叭
于是咱盯上了
Qwen3-ForcedAlignerQwen3-ASR-0.6B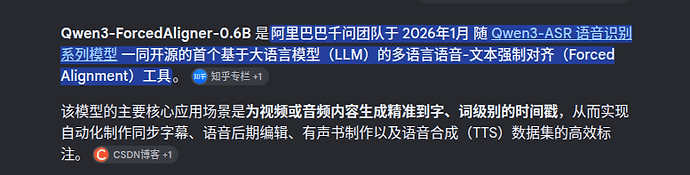
拉上手上跟不要钱一样的ds-v4.1-flash 开始折腾啦~
环境配置
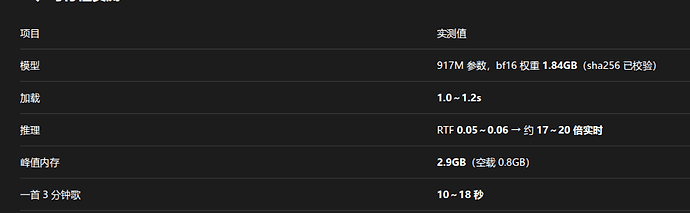
由于模型较小 所以虽然咱电脑没有独显 也可以流畅的运行CPU推理
CPU:
Ryzen 7 PRO 7840U使用ModelScope拉取模型,顺利运行,十分丝滑
工作流思路
网络拉取歌词 → ASR直接从音频提取歌词 → LLM比对网络歌词和ASR提取的歌词 → Aligner对齐轴
将流程发给ds之后 就可以框框开干啦~
网络歌词获取渠道推荐选择多源头聚合~ 猫猫这里聚合了网易云 qq音乐和lrclib,接口非常好找,这里就不分享惹ww
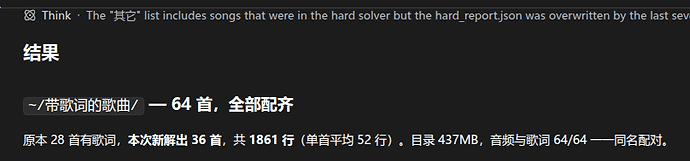
现在 爬下来的64首歌都已经打上歌词啦~!
 主楼
- mh212026-09-21
可以啊佬,想问问网络拉取歌词是怎么做的啊。以及对于其他语种歌曲是不是也可以顺便用llm做个歌曲内容翻译了。
- 无水硫酸铜2026-09-21
- XY2026-09-21
这个效果好吗?感觉千问这个比Whisper ASR+Whisper-X force-aligment轻很多。佬在前面加了Demuc吗?
- 无水硫酸铜2026-09-21
没有哦~ 直接投原始音频 效果很棒 体感准确率90%以上了 少有几个人声非常不清楚的歌错位有点明显 大部分时间轴都很准 另外几个完全对不上的音频都是歌词预处理没做好 不是Aligner的问题
- XY2026-09-21
我确认了下,Qwen3-ASR-0.6B 虽然已经是默认多语言的ASR了,Qwen3-ForcedAligner-0.6B 还是要指定语言,所以还是要做code-switching。
这个千问模型居然还专门跑过歌曲benchmark,之前我拿做对话ASR的Whisper跑,不带Demuc歌词准确度基本上看不下去 ^-^