- VrianCao2026-09-23
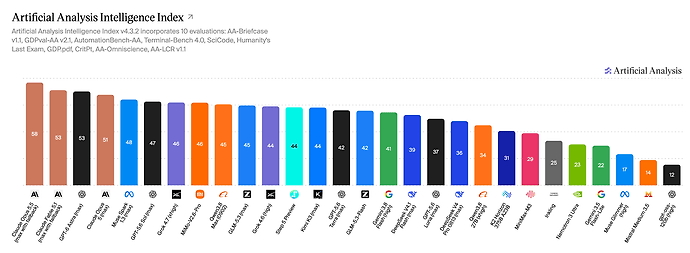
artificialanalysis.ai
Claude Opus 5.5 (max with fallback) - Intelligence, Performance & Price...
Analysis of Anthropic's Claude Opus 5.5 (Adaptive Reasoning, Max Effort, Default Fallback) and comparison to other AI models across key metrics including quality, price, performance (tokens per second & time to first token), context window & more.
尼玛的大半夜给我一发二向箔打击,直接炸清醒了
主楼 - 咸鱼-linuxdo2026-09-23
mimo和千问这么强的吗
- VrianCao2026-09-23
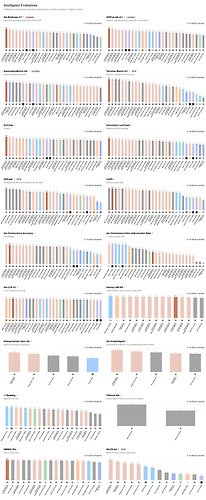
artificialanalysis.ai
Intelligence Evaluations - Claude Opus 5.5 (max with fallback) - Intelligence,...
Agentic knowledge work, (Elo-500)/2000 | Analysis of Anthropic's Claude Opus 5.5 (Adaptive Reasoning, Max Effort, Default Fallback) and comparison to other AI models across key metrics including quality, price, performance (tokens per second & time...
全方面的强
- 9962026-09-23
这下国产模型很难追上了啊。
- ZRainbow2026-09-23
- 维维亚米利欧2026-09-23
- Coeus2026-09-23
吓晕瘫坐,仿佛看到原子弹爆炸^-^
- OneDingZ2026-09-23
- VrianCao2026-09-23
目前的几个鹈鹕已经展现出了超越一众模型的动态表现了吧?
- 同学,能吃一口你的泡面吗2026-09-23
震惊到直接瘫倒在地!!!
Opus 5.5的AAII直接把Fable 5.1和Astra甩出五条街!!!整整高出整整5分!!!这已经不是提升了,这是核爆级碾压!!!历史性断层!!!宇宙级暴打!!!直接把天花板捅穿然后再往上飞三层楼!!!
太夸张了!!!简直离谱到让人怀疑人生!!!
- ZRainbow2026-09-23
- VrianCao2026-09-23
- 瑞克2026-09-23
震惊,Opus牙膏不小心挤多了,O^-^的Astra立马恢复智商 ^-^
- YGYOOO2026-09-23
- fjhorn2026-09-23
AA就是个垃圾benchmark
- VrianCao2026-09-23
Artificial Analysis
artificialanalysis.ai
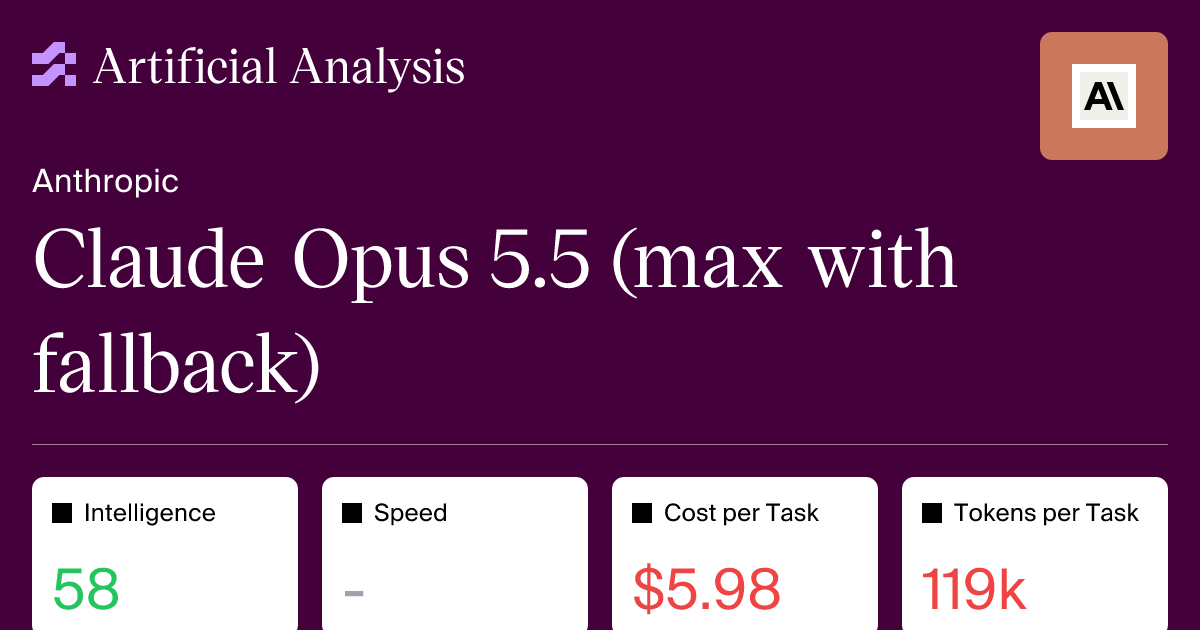
Claude Opus 5.5 (max with fallback) - Intelligence, Performance & Price...
Analysis of Anthropic's Claude Opus 5.5 (Adaptive Reasoning, Max Effort, Default Fallback) and comparison to other AI models across key metrics including quality, price, performance (tokens per second & time to first token), context window & more.
- Doori_Kiss2026-09-23
aa 和 arena 都是纯纯野榜啊
- VrianCao2026-09-23
AA是Benchmark融合分数,并含有自己的私有测试集,在新的 v4.3.2 下恢复了一定的公信力,但仍存在饱和和刷分的情况
Arena则是纯人类投票,其代表了广泛人类的偏好,出了AutoEval那个垃圾东西之外,其余数据是大多可信的
- Doori_Kiss2026-09-23
Arena 这个榜它特别容易被刷呀,当年有无数模型狂刷 Arena 榜,什么百度文心一言当榜首,还有什么LLaMA4 刷到很高的分,后来发现是一坨。
反正我记得这个榜特别容易刷原因之一,是可以通过讨好用户来提高分数。
当然,这些刷榜问题可能都是一年前的事情了,现在不太清楚。但反正因为这些事情,我是不太相信 arena 的。
- VrianCao2026-09-23
讨好人类也是一种人类偏好的体现,这也是当前Llama 4获得高分的原因
大可以不看Text榜单,只看WebDev这些,还是有参考意义的
就近期来看,Arena应该是没什么刷榜行为的,但是AAII的公信度在前段时间遭受到了严重的质疑,随后官方连续更新,换了新的Benchmark和加权算法,升级到了V4.3.2