- VrianCao2026-09-23
综合了多个Cost/Intelligence数据来分析,目前看来Opus的甜点档位为Medium/High,在更多数的任务中,High会是更好的选择
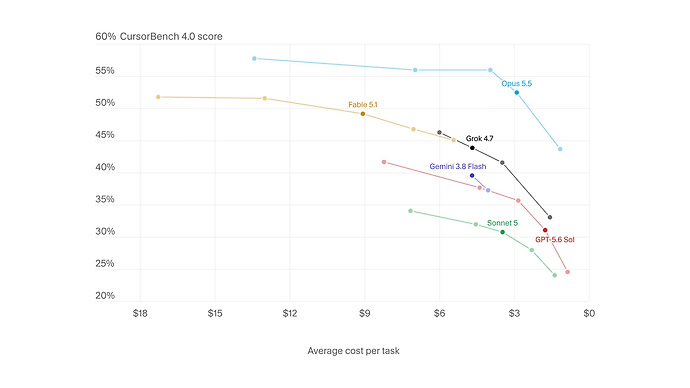
在CursorBench 4.0中,Opus 5.5实现了近乎平地起高楼的效果,实现了智价比的飞跃
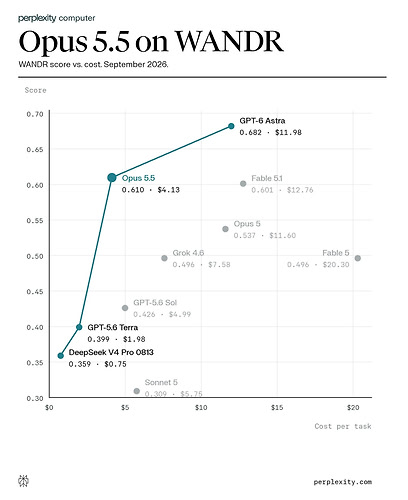
在PPLX的WANDR测试中,Opus 5.5在分数略微超越Fable 5.1的情况下,仅使用了其三分之一的费用,整体的点位大幅向左上角的帕累托前沿推进
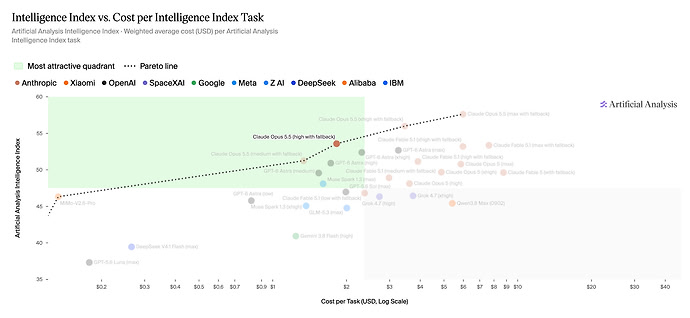
在AAII中,Opus 5.5的所有Reasoning Effort均处于帕累托前沿,每个档位都领先于所对标的模型
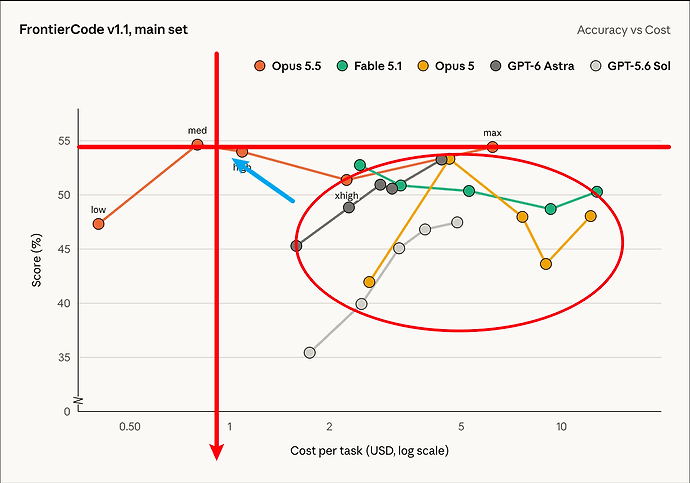
FrontierCode V1.1中领先当前的全部模型,且大幅推进帕累托前沿
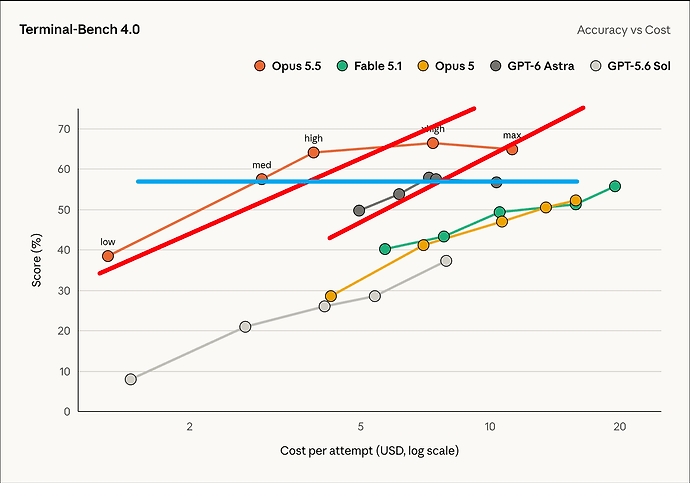
Terminal-Bench 4.0依旧领先所有模型,且只需要约三分之一的费用即可实现与Astra同等水平
 主楼
- apparition2026-09-23
- VrianCao2026-09-23
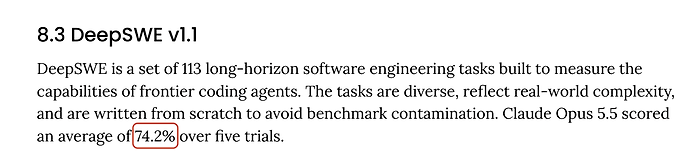
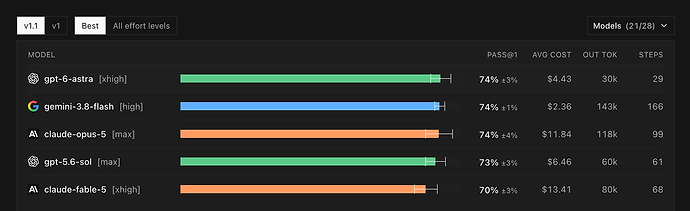
关于DeepSWE分数:
我倾向于是因为当前的DeepSWE V1.1已实际饱和,其理论最高分即~80%,而且这玩意实在是太好刷了,Anthropic没理由不公布
更详细的信息可参考:
[image]
Epoch AI在前几天完成了对多个Benchmark的审计,证明了DeepSWE V1.1是存在缺陷的,当前已实际饱和,前沿模型已实际追进了可获得的最高分
参考: - OneDingZ2026-09-23
- 木南城2026-09-23
gpt-6系列已出 蹲一手看看有没有新的对比
- 维维亚米利欧2026-09-23
=。=我一直都是ultracode用opus的,不然根本用不完周限额
- VrianCao2026-09-23
- OneDingZ2026-09-23
这个benchmark也差不多了。
- VrianCao2026-09-23
孩子们 OpenAI 变成价格屠夫了,这下真是不好说了