国产AI还赶的上吗
1619
- physics2026-09-23
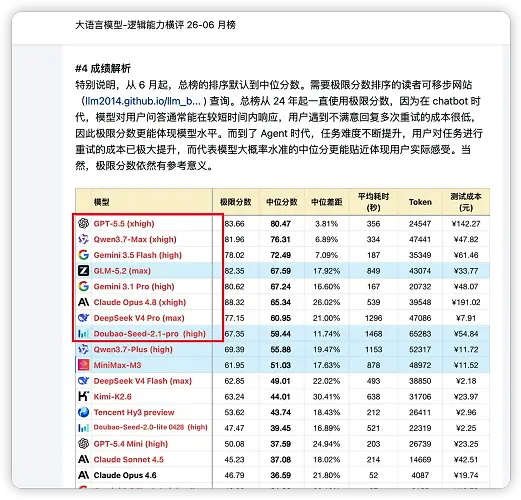
我看claude gpt都发了新模型,感觉国产的好像又落后一节了,心里焦急,中国不能输啊,还是这是我的错觉
主楼 - pony2026-09-23
我只能告诉你,在模型方面,中国只要跟在后头就行,而老美那是真的不能输,国本都在上面了。
- 小粉星2026-09-23
每次有新顶尖模型出来,就会出来一批这样的帖子,说法,好几年了吧( ´_ゝ`)
- hero2026-09-23
opus5.5 跟gpt6 国内可不止落后一节,那是两三节了。(除了kimi3)
- Monster_Dump2026-09-23
请问你是基于什么基准得出落后两三节的结论?
- crepe2026-09-23
- 忆洛2026-09-23
起码落后了两年,而且国模太依赖于蒸馏海外模型了
- hero2026-09-23
基于我自己的体验感,我应该说一个除了kimi3.除此之外,我只能说是一坨。
- 不曰2026-09-23
一直都在说有3个月的差距,你可以拿现在的国模和3个月前的OA比,其实没那么悲观
- jcc2026-09-23
- Monster_Dump2026-09-23
哦,这样,主观感受的话,那我没资格讨论了
- runner_dhero2026-09-23
其实大伙最没底气的时候是deepseek r1还没出来的时候,那时候是真觉得中文互联网语料就是一坨,有算力也练不出什么东西,至于现在其实也就是缺算力,但是像阿里和deepseek都要推动下一个2T 4T级模型的训练,说明缺卡问题应该会随着产能提升相对缓解,毕竟华为什么的还是能造出算力卡的,只是交付需要时间,而阿里有自己的卡。
- QuickHarbor662026-09-23
用了就知道了,如果astra打100分,国产模型现在最多70分
- hero2026-09-23
是主观感受,我是比较重度的代码开发,逆向之类的工作,我能表达的是我所处的行业里的评价。
- 一个合格的复读机2026-09-23
- Monster_Dump2026-09-23
- anbuzhidao2026-09-23
- yricky2026-09-23
轻轻松松好吧,也就三个月的差距,算力上来了超越也不是没可能
- Martini2026-09-23
类似zcode的问题可能很多都看不见,价格也摆在眼前,怎么弄?
- Monster_Dump2026-09-23