- 落寞书生2026-09-18
llama.cpp 折腾日记
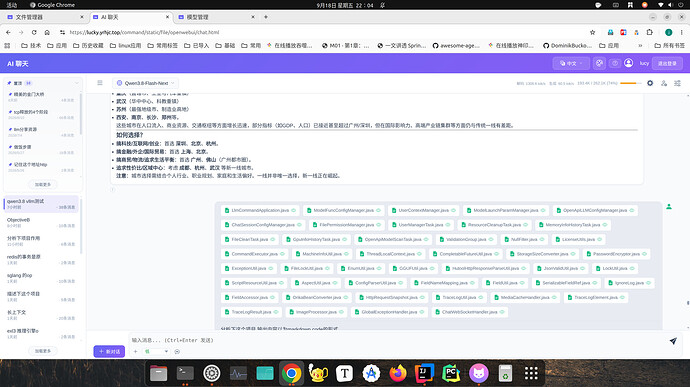
之前主力用的是 Qwen3.8-Flash-Next(从 Qwen3.8 27B 切过来的),部署方案是经典的
llama.cpp+Unsloth UD-Q4_XL量化。说实话,短上下文(比如几千字对话)体验确实不错,速度能稳在 40 t/s,质量也没啥问题。但一旦遇到长文档场景(比如 100k 上下文),直接崩盘:
- Decode 速度腰斩:从 40 t/s 掉到 20 t/s,生成速度肉眼可见地变慢,基本没法用。
- Prefill 太慢:刚开始读文档那会儿(Prefill阶段),峰值也就 500 t/s 左右,随着上下文累积,速度还会进一步掉到 300+ t/s。处理一个长 PDF 得干等着,体验极差。
^-^ 换引擎vllm
最近看到社区有个针对长上下文优化的版本:huggingface上面的 albucino/Qwen3.8-Flash-Next-W4A16-FP8PLE`。我让本地qwen3.8 27b折腾了下部署,效果炸裂.
^-^ 实测数据对比(100k 长上下文场景)
指标 |
旧方案 (llama.cpp) |
新方案 (vLLM + W4A16) |
提升幅度 |Prefill (读入速度) |
~300-500 t/s |
> 1000 t/s |
^-^ 2-3 倍 |Decode (生成速度) |
~20 t/s |
> 50 t/s |
^-^ 2.5 倍+ |代码编写场景 |
18-25t/s |
~60 t/s |
^-^ 流畅 |^-^ 我的“垃圾佬”硬件配置
这套方案是在消费级魔改卡上跑的,配置如下:
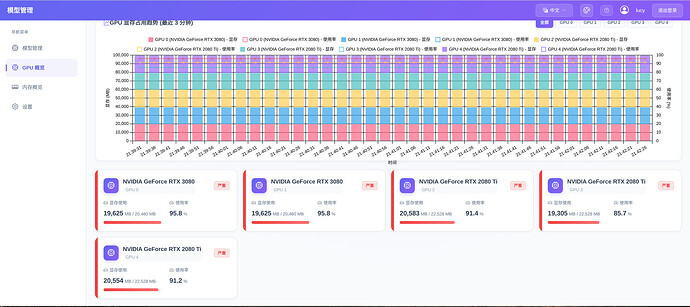
GPU:2x 魔改 RTX 3080 20GB(部署qwen3.8 flash next) 3x 魔改 RTX 2080 Ti*(部署qwen3.8 27b)
CPU:AMD 7543
内存:32GB x 8 DDR4-2666MHz
显存占用
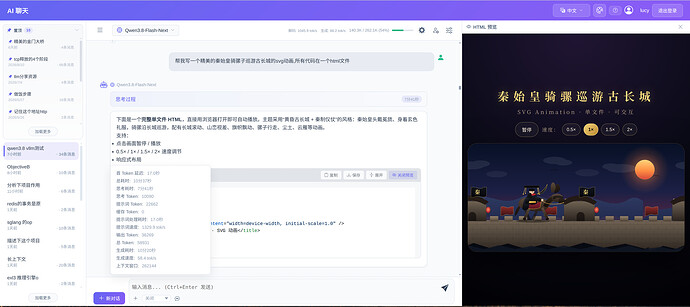
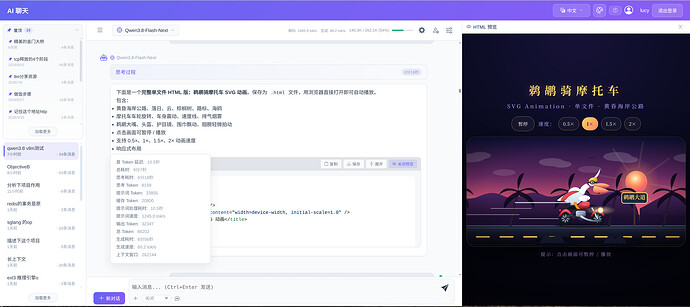
测试了几道常见题目效果(xhigh模式)
秦始皇骑骡子巡游古长城svg动画
鹈鹕骑摩托车svg动画
 主楼
- 落寞书生2026-09-18
这个模型就有一个问题,不支持多模态呀
- qppq54s2026-09-18
厉害了佬友,这么看还得是flash模型啊,不然得多富的佬友才能本地部署
- 落寞书生2026-09-18
我也是之前没想到vllm性能这么炸裂,gpu基本能够跑慢,他的官方文档是两张3090,能够跑到100t/s
- 小风小浪2026-09-18
40g 够么
- 落寞书生2026-09-18
足够了,我就是双卡3080 一共40gb,内存要大点
- 落寞书生2026-09-18
- 落寞书生2026-09-18
模型本身支持,他这个版本而不支持
- 小风小浪2026-09-18
剔除掉n gram 也不够啊。 vllm支持专家卸载了吗 。 那我16g显存能带不 我在llama里是25token/s 预填充大概800/s
- lynn1682026-09-18
佬 你是在啥系统下部署的啊,之前用vllm在windows下太蛋疼了。。
- 落寞书生2026-09-18
ubuntu系统,windows系统下不稳定
- 落寞书生2026-09-18
- 秋枫冷夜2026-09-18
佬,请教一个问题, 我主板是B760M小主板,怎么上两张显卡呢, 现在是4060ti 16G , 如果能加一张是不是可以跑了, 现在连玩个comfyui都吃力
- 落寞书生2026-09-18
你看下主板上有没有两个显卡插槽,如果没有的花,消费端大部分普通主板显卡应该不支持通道拆分的,估计搞不了
- Star2026-09-25
你这个双卡配置部署flash,内存要多大啊
- zengraoli20122026-09-25
晚上试试这个,2卡3090不用起来有点浪费了