- Jack_min2026-09-28
最新国模
Naive-N0.5-Flash 是一款面向编程与 AI 研发的 MoE 模型,总参数量为 309B,激活参数量为 15.5B。
- 原生 1M 上下文,不含全局注意力机制。
Naive-N0.5-Flash 将滑动窗口注意力机制(SWA)与采用 GQA4 的轻量化 DeepSeek 稀疏注意力机制(DSA)相结合,主要采用每 5 层 SWA 搭配 1 层 DSA 的布局。整个网络结构仅使用局部或稀疏注意力机制,不含任何全局注意力机制。
- AI 优化推理,速度最高可达 2,000 tokens/s。
NaiveRT 是为 Naive-N0.5-Flash 构建的推理系统,其构建与优化均采用以 AI 为中心的研发方式。通过 mega-kernel fusion、程序化依赖启动(Programmatic Dependent Launch,PDL)与投机解码,标准模式下每位用户的输出速度为 50 tokens/s,而极速模式下最高可达 2,000 tokens/s。
- 开放权重与 API。
模型权重与推理代码均以 MIT 许可开源发布。同时将提供API访问,API 输入、输出和缓存读取价格分别为每百万 tokens 0.6、2.6 和 0.07 人民币。
评测结果
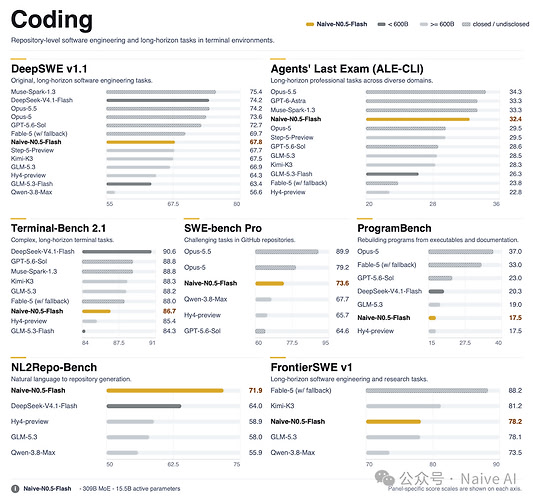
目前是邀请制注册的

NaiveAI
NaiveAI
Naive AI, the lab where AI builds AI. Frontier models running at 2,000 tokens/sec, faster than you can read, with open weights you can run anywhere.
主楼 - wg19292026-09-28
这又是基于哪个底座的,太多了眼花缭乱
- Q_A2026-09-28
这么牛吗,直接等第三方部署
- 一只猪2026-09-28
mimoV2.5,两个小时前才上传hugging face
huggingface.co
NaiveAI/Naive-N0.5-Flash · Hugging Face
We’re on a journey to advance and democratize artificial intelligence through open source and open science.