- 狐狸汉克2026-03-22
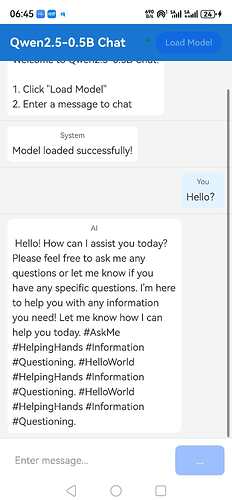
设备是Mate70 Pro,鸿蒙6.0.0.130,完全本地部署千问2.5 0.5b参数模型。使用llama.cpp作为后端推理模块。
感觉NPU根本没发力,纯CPU硬算的,速度大概1秒一个token,目前还在优化,但是至少证明是可行的。
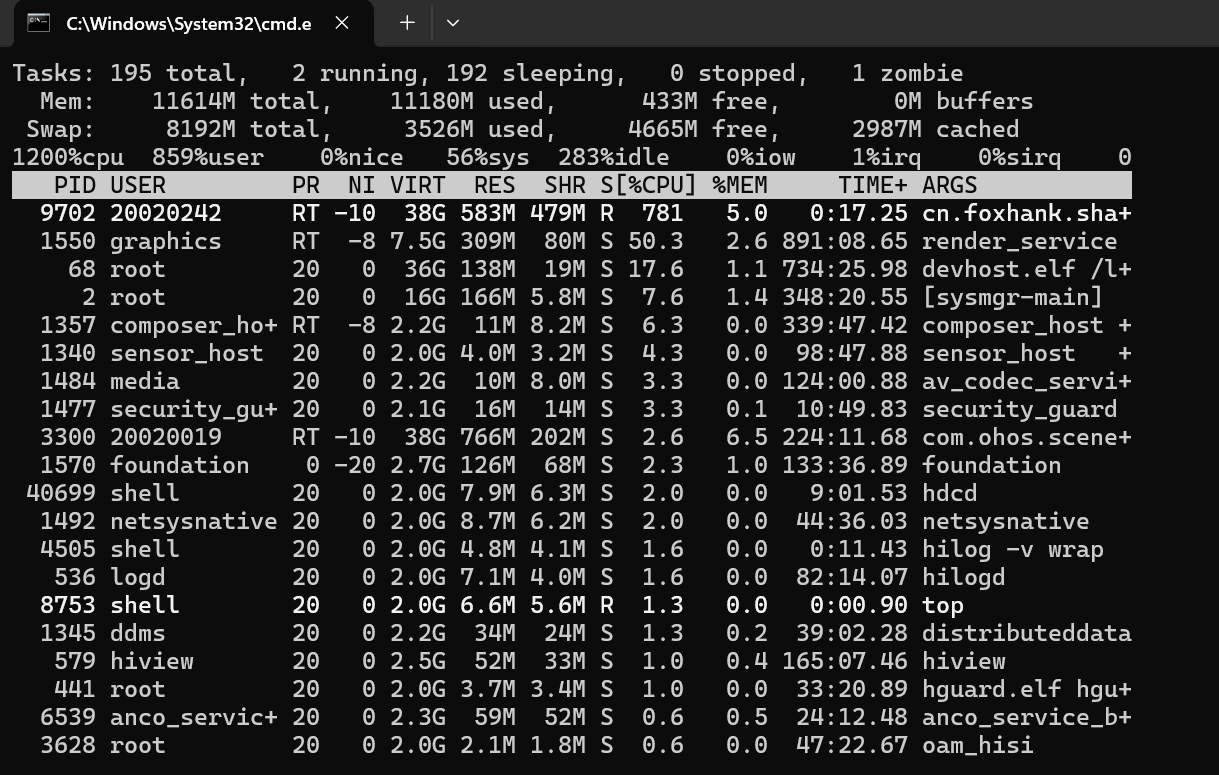
破案了,我没开SIMD指令并行处理,开了之后能跑到50多token/s,CPU基本上能吃满,就是NPU不知道在干嘛,如何才能调用
 主楼
- Febonacci2026-03-22
- 匿名者2026-03-22
50个还是可以啊。
- 狐狸汉克2026-03-22
- 菠菠菠萝2026-03-22
佬,部署0.5B模型的作用是 ^-^
- Meiko_Mei2026-03-22
没作用,为了证明它能
- 菠菠菠萝2026-03-22
也很强了,需要什么硬件资源吗?手机端部署最终是形成了一个什么文件
- Grogu2026-03-22
可以在无聊的时候和它瞎扯 ^-^
- 狐狸汉克2026-03-22
目前是证明了:
- 纯血鸿蒙可以跑大语言模型(这是我们去年华为揭榜挂帅竞赛的方向),目前还在继续探索极限
- 麒麟芯片性能还不错,毕竟是跑在手机端上的芯片,性能调度做的也不错
还在探索极限,打算整理一下在国产替代区写一篇文章 ^-^
手机端使用的是gguf格式的模型文件,还在研究怎么转化成鸿蒙专用的om格式文件
- john.wick2026-03-22
太厉害了佬,仰望佬
- missylusi2026-03-24
这样手机就是ai智能手机了吗。能做啥东西啊
- 狐狸汉克2026-03-24
应该不算,我在mate70 Pro上测千问3.5 2B可以到达10token/s,但是Nova 12Pro上只能有1Token/s,对硬件要求还挺高的。不过我感觉跑点简单对隐私要求强的(比如日程管理之类的)应该还不错?
- Jerry_Hou2026-03-24
wow,看起来不错啊~继续努力~
- 越小越可怜2026-03-24
我是mate x6应该也能跑跑吧
- JulieSapir2026-09-29
