- 往事随风k2026-10-15
叠甲:本人非计算机专业出身,以下内容仅供参考,如有建议和意见欢迎指出,以后还会发类似的内容,喜欢我内容的佬可以关注一手。
书接上回:
先放一张封面图
[封面图]
叠甲:以下内容为个人观点,仅供小白参考。本人非计算机专业,如有问题欢迎在评论区指正。
今天来说说如何正确使用agent进行vibecoding,或者说进行相对正规的长期项目开发(适用于中大型项目)。以codex为例,其它平台也适用。
先把你的codex切换到codex模式
[image]
1.不要反复造轮子。
[以我自己的项目为例]
不管你有什么创…我觉得以下几个习惯都是vibe coding普遍适用而且应该长期坚持的:
1.不要反复造轮子
上期讲过,但这期还是得放到开头。不管你在开发什么东西,都应该先让AI去GitHub和站里逛逛,说不定就能找到现成的开源项目或者相关的技术讨论帖,这样开发绝对是事半功倍的。
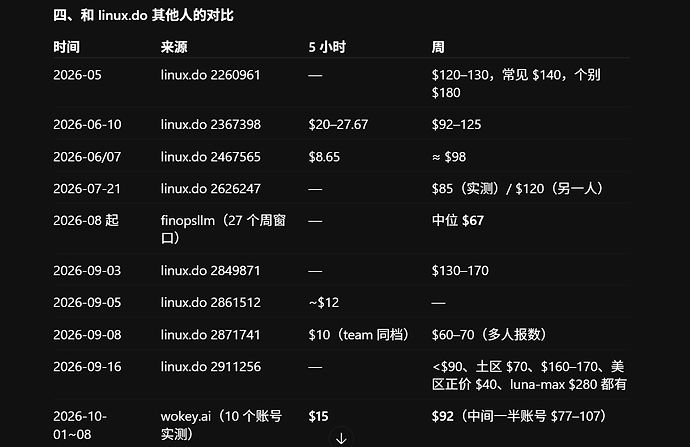
我平时用codex比较多,图方便就直接在codex的内置浏览器里登录了linuxdo,让AI帮我在浩如烟海的帖子里找到需要的东西。
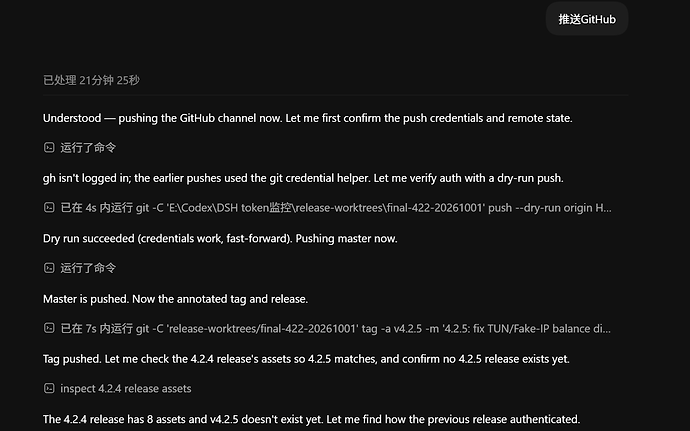
GitHub就更方便了,codex对GitHub的访问支持做得很好。只要在codex里完成一次授权,之后让AI帮你完成开源项目搜索、issues和pr审查、项目更新推送等一系列操作。
2.坚持定时换窗
很多人喜欢一直用一个对话进行开发,甚至一个对话用好几天到半个月。这个习惯非常不好,每一次压缩都会增加模型的幻觉降低工作效率。大约在经历5到6次上下文压缩之后模型就会逐渐忘记之前的任务,更容易进入死循环。而且对你的钱包也非常不友好,长时间用一个对话做任务token消耗也会越来越多。那么如何确保新建对话之后新的窗口和清空上下文的模型能继续接续开发任务呢?答案在上一篇文章。做好基础的项目持久记忆和基础开发文件就好了,新建对话之后很快就能顺利接手之前的任务。
我之前用一个对话开发了大约一个月左右,大约跑了几百轮任务,切换了DeepSeek、GPT在内的多个模型,最明显的感受就是token消耗越来越高、模型效率越来越低。这条习惯是用我的巨量token消耗换来的。下面给一个全局agent md,仅供参考:
换窗与交接
- 完成约 2–3 个独立功能、约 2–3 次压缩、连续工作约 60–90 分钟,或转向不同项目与独立目标时,在最近可验收闭环评估换窗;无法观察的次数或时长不编造。
- 同一功能的实现、测试和修复通常属于一个闭环,不因细小步骤切换强行换窗。继续会明显增加状态混淆或操作风险时,在下一阶段前提醒。
- 交接保留目标、范围、验证、未完成项、必要运行状态、授权依据及文件入口,用短摘要续接,不复制完整历史;未经用户要求不自动创建新任务。只读任务在报告中交接,不因此写项目状态文件。
3.让AI按需检索它需要的东西,不要通读文档。
如果你让AI去读一份工程文件或者其它文档类的东西,它一般会选择全读一遍。但大部分情况下它只需要按需检索需要的内容就可以了。否则它读过的东西会变成对话的上下文,在压缩文本的过程中反复输入输出,最后产生大量额外的token消耗。这也是我在周期性整理过程中发现的一个问题,我也写了对应的指令来规范。
按需读取与持久记忆
- 使用完成任务所需的最小充分上下文。先利用已提供且仍有效的信息,不因文件存在或可能有用就默认读取;适用的规则和安全边界不得跳过,已加载内容无需重复读取。
- 需要项目定位或路由时读取小型 PROJECT_INDEX md 或等价入口。大文件先查标题、索引或关键词,再读命中片段及必要上下文;证据不足或有冲突才逐步扩读,足以支持下一步判断时停止。无索引先做限定范围搜索,不遍历全部历史。
- 阅读清单是按任务选择的路由,不是全文必读清单。NOW 仅在接续进度或排期等需要当前任务状态时读;路径与发布、运行验收、设计决策、风险分别定位对应专题。历史和旧对话仅在追溯、回归或当前材料不足以解决冲突时搜索。
- - 全文审计或整体分析确有必要时可扩大读取,不用固定行数限制破坏理解。源码和现场状态用于核验事实,项目文档保存项目约定与状态,Obsidian 保存个人和跨项目背景。
4.定期做一次蒸馏
你过往的任务历史是非常宝贵的财富,不仅对模型厂商有用,对提升你自己的开发效率、形成更贴合你实际使用的工作流也有重要意义。非常推荐你每隔一段时间就让AI通读一下你这段时间的对话历史。无论是把你气到爆炸、破口大骂的对话历史,还是一段非常愉快、不烧心的对话历史都可以让AI进行分析,然后把高频出现的任务固化为skill,把模型经常犯的错写进agent md里进行约束,把用户不好的开发习惯指出来。这些东西都是只能从你提供的宝贵对话历史中才能蒸馏出来的,多做几次蒸馏,你也能有一套更适合自己的工作流,让vibecoding不烧心。
推荐先用性价比模型完成基础的数据整理,DeepSeek、6.1sol都适合干这个活。性价比要做的是对对话历史进行归纳和打分,最后形成一份带有索引的报告。归纳主要是按照任务类型归纳,例如按照代码、UI设计、搜素或者模型经常出现的坏习惯来分类。然后根据用户在任务完成后的下一条指令对单次任务进行打分。比如一个任务一次就通过,就可以打正向分。如果一个任务返工了好几轮用户还是不满意,就可以打负分作为反面例子。模型的坏习惯和用户经常出现的一些坏习惯也可以先单独归纳出来。
当性价比模型整理完这些材料之后,就可以新开一个对话让Astra、肥波这些旗舰顶级模型来做数据分析和蒸馏了。最终让模型分别针对全局agent md、项目工程文件、用户使用习惯、本地持久记忆这些地方分别提出修改意见并落实。就我目前应用的效果来说,提升非常巨大。
5.编不下去了,欢迎佬友们在评论区分享自己的coding好习惯或者坏习惯。
10.18更:
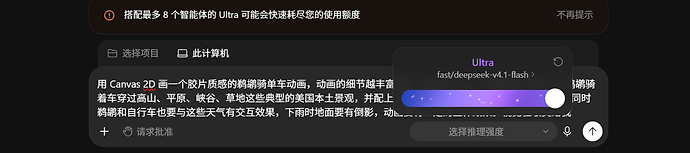
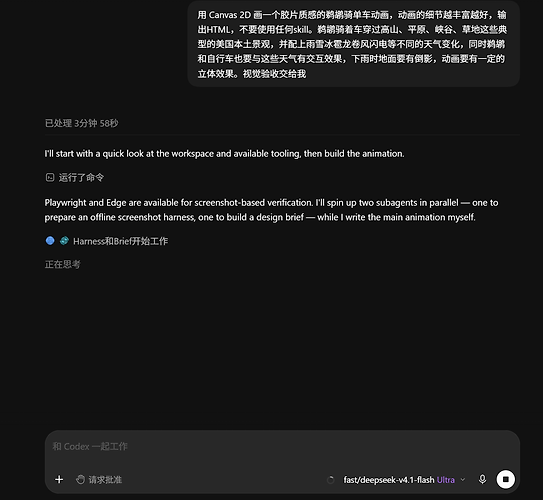
想到了第5点:非必要不使用max、ultra等推理强度进行任务,正常任务用high或者high以下就行。根据我的过往经验和模型推理轻度的实际情况来看,使用xhigh、ultra、max等档位执行大部分任务会使模型进入过度思考状态,至于ultra这个档位,本质上是在xhigh的基础上增加了一套提示词用来鼓励模型开子代理执行任务,任何模型都可以在codex中使用ultra模式,在该模式下模型会选择统筹安排任务执行计划,然后拉起子代理开始做调查或者开发。以画鹈鹕为例,Astra high档位画鹈鹕大约只需要6分钟左右(在不检查的情况下),而开启ultra之后,Astra选择开启子代理来帮它画鹈鹕,最后用时大概在20分钟左右。有提升吗?有,但是和你消耗的时间和token相比就是维护其微,下面附上一张DeepSeek开启ultra之后的截图。
 主楼
- MUZIMI2026-10-15
很中肯的建议,关于定期蒸馏,这点我非常认同,在AI能力非常强大,大家统一起跑线的时候,个人的能力越来越关键和重要,特别是你提到的定期蒸馏,本身就是对个人能力的提升和复盘。
其实我补充一下,就是毕竟AI蒸馏也是根据你全局的聊天记录来的,必然会有一些幻觉和上下文扩大之后造成的模型能力的下降。我建议是自己完成了一个项目或者开发之后,就对这整个项目进行一次系统的复盘和归档,并让AI提取出这次参考中实际学习的点,并且人工要参与这次复盘,整理成一个文档,按照yy-dd-SS的和序号的方式进行总结,同时对自己研究的项目归为已完成、已暂停和开发中三个档位进行台账式的整理。这样下来一个月就可以根据自己整理的点,对自己的能力也进行一次大的总结蒸馏,同时也能复盘提高自己。
- 花辞树2026-10-15
当你在感觉不是你在驾驭ai的时候,就该停下来去给你的项目做减法
- 往事随风k2026-10-15
非常有哲理的一句话,只有停下来纠错才能更快的进步
- 往事随风k2026-10-15
是这样,我每次在蒸馏的时候会引导AI先解决最影响我coding体验的事。平时如果发现token消耗异常的高或者被AI气晕也会及时停下来解决这些问题。每次蒸馏的记录都会留在我的本地持久记忆里,修改agent md之前也会留备份。
- ℰ𝓉𝒽𝒶𝓃2𝒫ℯ𝓇𝓉𝒽2026-10-15
无论是把你气到爆炸、破口大骂的对话历史,还是一段非常愉快、不烧心的对话历史都可以让AI进行分析,然后把高频出现的任务固化为skill,把模型经常犯的错写进agent md里进行约束,把用户不好的开发习惯指出来。这些东西都是只能从你提供的宝贵对话历史中才能蒸馏出来的,多做几次蒸馏,你也能有一套更适合自己的工作流,让vibecoding不烧心
这段话读着不烧心
- 往事随风k2026-10-15
我每次读都会想起来被GPT和DeepSeek气晕的经历
- 邪恶老登2026-10-15
- yzzliang2026-10-15
这是一个很好的习惯。现在开发都是vb总是感觉自己好像废了,没有什么进步收获。其实每次在vb过程中不论是一次完成的开发,还是纠正AI犯错修改问题都是可沉淀的经验。这也许就是AI时代真正宝贵的吧
非常推荐你每隔一段时间就让AI通读一下你这段时间的对话历史。无论是把你气到爆炸、破口大骂的对话历史,还是一段非常愉快、不烧心的对话历史都可以让AI进行分析,然后把高频出现的任务固化为skill,把模型经常犯的错写进agent md里进行约束,把用户不好的开发习惯指出来。这些东西都是只能从你提供的宝贵对话历史中才能蒸馏出来的,多做几次蒸馏,你也能有一套更适合自己的工作流,让vibecoding不烧心。
- 往事随风k2026-10-15
我目前只感受到了长期对话带来的效率下降,至少实测下来体验不好。每次连续跑2小时以上的长任务之后模型很容易偏移原本的计划
- johnlanni2026-10-15
第4点很认同,尤其是按任务类型看“做完的效果”,再让不同模型各干擅长的部分。这份复盘还能反过来帮助下一次选模型。
可能可以看看我在做的开源项目 HiRoute: 让 Codex / Claude Code 的订阅更耐用:HiRoute 开源了
也是在往这个方向做:整理、分析可以配成不同任务分支,各阶段的表现单独记录,再结合当前任务复杂度选择模型。让省钱有个质量门槛,也不用整个任务从头到尾都用最贵的模型。
- 往事随风k2026-10-15
人和工具都要进化才能提高效率,我想这个道理亘古不变
- kvvvv2026-10-15
有时候你一直在一个会话停滞不前,缝缝补补,往往把你在这个会话的全部需求(包含后续新增的)都整合成一个Prompt,新开会话,往往就能解决得很好
- yzzliang2026-10-15
我基本都是一个问题如果3次会话都没有解决就应该/rewind。或者重新梳理思路启动新会话重新开始
- 往事随风k2026-10-15
我一般会直接让新对话读旧对话,然后接手任务继续干。有项目工程文件兜底做接手,效率会高很多
- 往事随风k2026-10-15
用DeepSeek官key的时候经常得这样,有时候DeepSeek在旧对话会陷入死循环或者消极怠工,跑个几秒就停下来报告进展。新建对话之后就完全不会这样
- upup猫猫2026-10-15
感谢分享,果然上L站总能学习到一些技巧,蒸馏skill这个我感觉真的非常可行的,每个对话都重新认识太折磨了
- 往事随风k2026-10-15
如果不想每个对话都重新认识其实还应该做好本地持久记忆,自己建一个本地记忆库
- 常天awa2026-10-15
半小时前在小黑盒上刷到,开l站摸鱼又看到了 ^-^
- 往事随风k2026-10-15
是的,这次其实是L站首发