- Eeevan3天前
由于近期模型发布都大量刷榜,导致最近野榜盛行,和实际体验严重不符。
因此我选择发布更野的榜单。
无权威、纯主观、仅个人、无参考价值、仅娱乐价值。

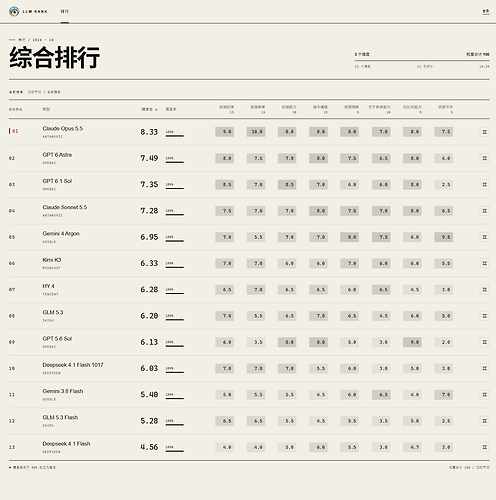
地址:https://llm-rankings.evan-ai.xyz/
模型仅涵盖我用过的。评分仅代表个人体验
主楼 - Crain3天前
dsf 1017没那么低
- D的意志-AI3天前
佬,DeepSeek V4.1 Flash 10-17的,评分有点低了实际体感感觉和5.6的sol差不多
- Hyperion_WB3天前
1017在我这体验比hy4好一些,4.1f感觉比5.3好一些,但是这两总体不相上下
- Eeevan3天前
可以看看子项,1017 的问题在指令遵循退化了一点,前端能力和审美大幅跃升,幻觉改善,但是因为不讲人话,我这分偏低。
- Seabiscuit3天前
我看论坛好多说 gpt-6.1-sol 蠢笨,这两天AG开放不限时,用了下感觉还可以,看来佬的排名感觉对我后端来说6-astra没啥必要用了
- Zard3天前
怎么没有fable5.1 ,感觉fable5.1也挺厉害的
- Eeevan3天前
因为 Pro 套餐用不上 Fable
- 粥粥3天前
我觉得可以优化下表单,把每项能力最高、最低得分重点标示出来,可以看出来这项能力哪个模型最强、最弱
- xinghong3天前
看到hy4就释怀了