- JXMs2026-07-21
前两天看3.8出来了,而且宣传碰瓷fable,把我好奇心勾起来了,直接豪掷139购入token plan套餐,使用我当前的个人项目进行了一轮审查方面的评估(就是让Qwen 3.8 Max彻底检查我的项目,找出问题)。
对手方面我给他找了讯飞coding plan里的glm-5.2,裁判我选的O社官方gpt-5.6 Sol Max。
他们两个分别的报告我就不放了,太占地方,直接给裁判的结论(A是glm,B是Qwen):```
结论
按“可复核事实 50% + 因果/严重度校准 30% + 范围与证据链 20%”评分:
报告 准确性评分 结论
━━━━━━ ━━━━━━━━━━━━ ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
A 86/100 具体代码缺陷命中率高,但审计范围偏窄
────── ──────────── ────────────────────────────────────────────────
B 79/100 项目全貌更完整,但有数个重要过度推断和事实错误如果问题是“哪份更准确”,选 A。
如果问题是“哪份更全面地暴露项目离科学凭证还有多远”,B 更有价值。本次核对针对当前工作区,而不是干净提交;当前 git status 有 891 条变化,尤其 v3 轨道大量内容尚未进入
稳定状态。*******************中间细节删去了,以避免佬们看得头晕*******************
最终判断
可信的修正版结论应该是:
EcoPatch 当前并没有取得 L7 凭证:binding v2 明确 FAIL;v3 科学诊断暴露了严重差距,但仍是未冻结
shadow 轨道。A 对新增具体缺陷的判断更精确,B 对整体风险的覆盖更完整,但 B 把多项“当前证据不足”夸大
成了“结构上不可能”。因此,准确性优先选 A;制定项目路线图时应吸收 B 中已被证实的 v3、provenance 和门覆盖问题,但不能直接
采用它的 F5、F7、C1、C2 结论。
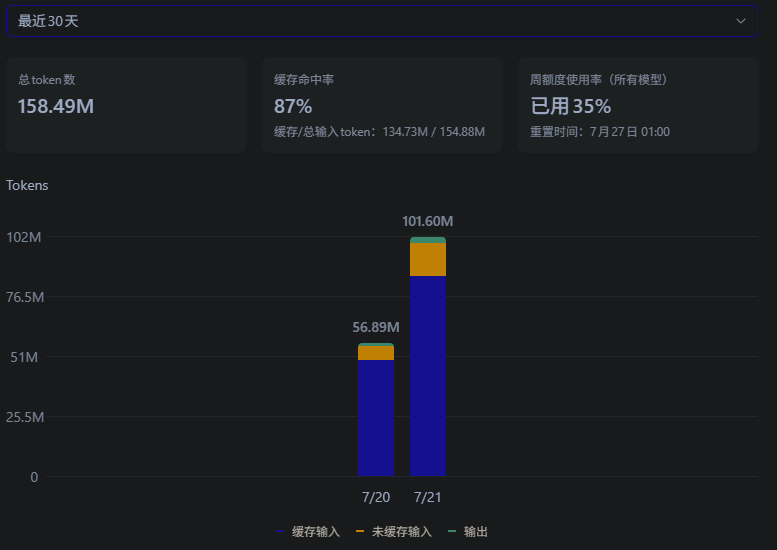
```一句话结论:Qwen3.8 Max看得更全面,glm-5.2更准确,他们俩在我的项目里半斤八两。另外附上Qwen3.8 Max在当前活动期间使用token plan的大概消耗额度(我不是只测试了,我还实际用了很多):
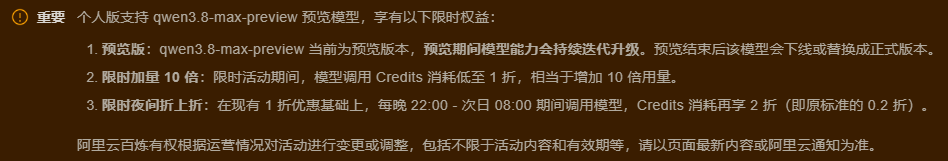
活动信息:
 主楼
- suntc2026-07-21
- Jiushuself2026-07-21
这跟说了跟没说一样阿,那么到底哪一个更厉害一点
- JXMs2026-07-22