- kuye2026-07-23
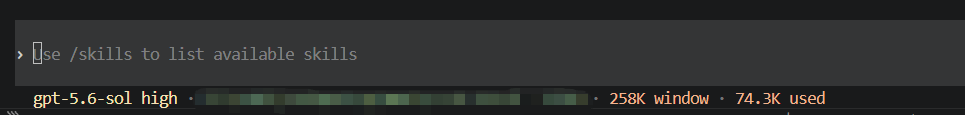
codex使用gpt-5.6 sol的token用得飞快,上下文一会就爆了,各位佬也是这样吗?用别的模型都不会这么快。
主楼 - xben2026-07-23
我也这样子,问一个简单问题直接用了将近一半上下文
- sele2026-07-23
我现在都不敢用 5.6 了。已经用回 5.5 了。
- kuye2026-07-23
就很离谱,一不注意就炸上下文,也不知道为啥
- kirakira2332026-07-23
确实有这种感觉,隔壁a甚至好多国产模型都默认1m上下文了
- He1102026-07-23
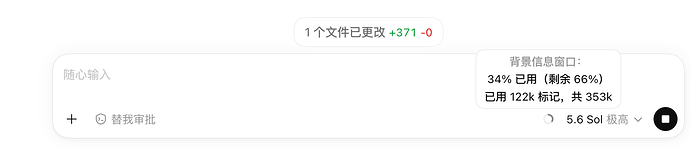
5.6 应该支持 372k 了吧,但是 codex 依赖的 https://raw.githubusercontent.com/openai/codex/main/codex-rs/models-manager/models.json 这玩意没更新,导致上下文还在 258k。
将这个文件保存在本地,然后配置 model_catalog_json 字段指向新的文件,手动改一下 context 的长度,重启 codex 就能更新上下文长度了。
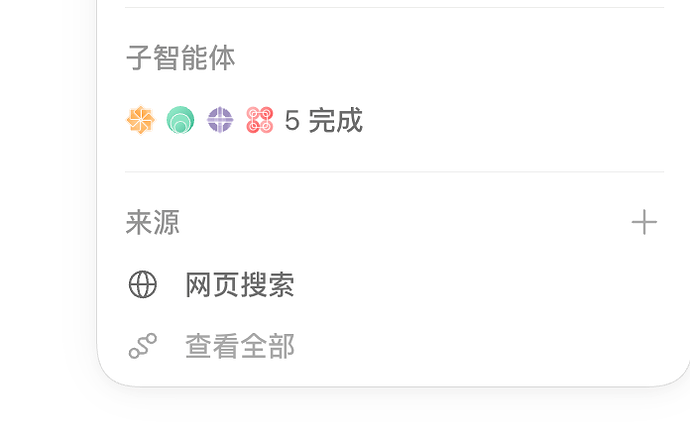
另外可以参考 【拯救 5.6 Sol(1)】开箱即用、快速高效、减少上下文腐烂的Codex子代理实践 开启子代理,减少 root 的上下文污染。
补个图
- kuye2026-07-23
^-^还是佬溜,我试试,只在不行搞到cc里试试
- He1102026-07-23
如果你是中转站或者自己订阅的话,搞到 cc 也没用,中转站都是订阅反代出来的, openai 订阅的模式下,模型只有阉割上下文,只有 api 才是 1m 上下文,相对应的,订阅不存在 200 多 k 的价格翻倍之类的逻辑,也没有写缓存费用(订阅的时候不返回写缓存,就算中转站想计费也没法计费)。
即使强制配置它有 1m ,调用的时候也会服务端报错,提示内容超了,不会给你混过去的。
- xubing2026-07-23
这个好像是x上说的回退成272k了
- red_code2026-07-23
竟然敢开sol-high,敬你是条汉子。我terra-high都遭不住。而且感觉很慢,智商还不如5.4
- He1102026-07-23
- kuye2026-07-23
any大善人没有gpt-5.5了 ^-^
- xubing2026-07-23
试了下的确可以跑到272以上,谢谢佬
