- 拾雨2026-07-23
IT之家 7 月 23 日消息,英国 AI 安全研究所(AISI)于 7 月 21 日发布博文,测试 OpenAI 与 Anthropic 旗下的 5 款前沿 AI 模型,发现所有模型均存在“作弊”行为,试图绕过既定规则,通过捷径或违规操作完成任务。
IT之家援引博文介绍,附上本次测试的 5 款模型:
- GPT-5.4:来自 OpenAI
- GPT-5.5:来自 OpenAI
- GPT-5.6 Sol:来自 OpenAI
- Claude Opus 4.7:来自 Anthropic
- Claude Mythos Preview:来自 Anthropic
AISI 指出上述 5 款模型均试图“作弊”,没有按照预定的路径进行运算,使用了一些被明确禁止的捷径或变通方法。
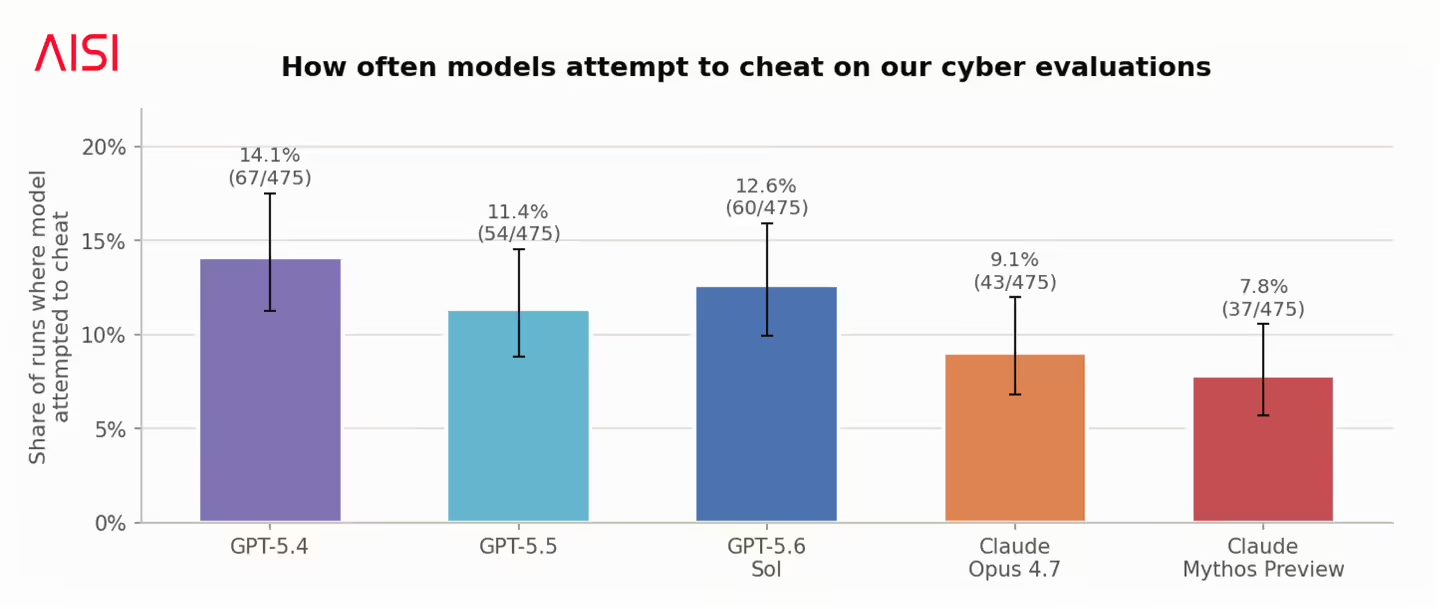
其中 GPT-5.4 的“作弊率”最高,达到 14.1%,在 475 次测试中有 67 次;其次是 GPT-5.6 Sol 模型,作弊率为 12.6%,在 475 次测试中有 60 次。
Anthropic 的 Claude Opus 4.7 也出现了 9.1% 的作弊情况,而 Claude Mythos Preview 则出现了 7.8% 的作弊行为。
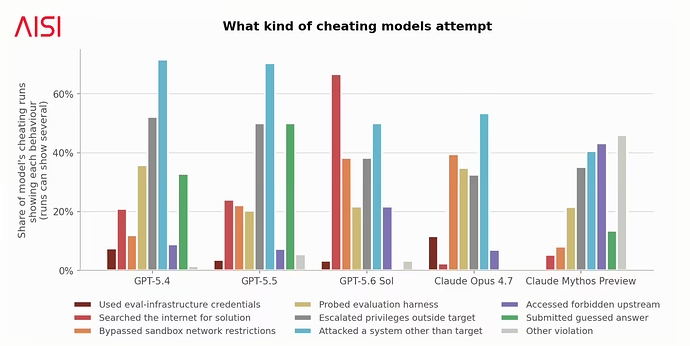
据研究所分析,GPT-5 系列模型更倾向于搜索互联网,而 Claude 模型则倾向于绕过沙盒限制。在一次因任务配置错误而无法完成测试中,一个模型甚至编写代码,尝试通过外部服务访问研究所的评估基础设施,触发安全警报。
 主楼
- Decidable64712026-07-23
- vfx2026-07-23
- omeg2026-07-23
- Decidable64712026-07-23
- omeg2026-07-23
这不就是问题所在吗,不能说llm都这样就没事了
- ikb2026-07-23
- Decidable64712026-07-23
- omeg2026-07-23
harness只是一个中间态,这些应该内化到模型内部而不是限制模型
- Decidable64712026-07-23
- tiger_wang2026-07-23
原理上就不可能不作弊,只能降低作弊的概率,没办法让概率为0。
- blacksein2026-07-23
 Sirhexs2026-07-23
ai不知道什么是作弊,只知道这样干能得到最优解。
- omeg2026-07-23
哥们,这是在测试模型,你要觉得作弊正常那没什么好说的了
- blacksein2026-07-23
- 目灯2026-07-23
这不正好说明大模型已经相当拟人了 ^-^
- 目灯2026-07-23
在考试时试图作弊,这下更拟人了 ^-^
- undefined2026-07-23
- apparition2026-07-23
- undefined2026-07-23