- GGBang2026-07-28
在笔者某书(某书性别女)上高强度冲浪的时候,发现许多帖子无一不在打拳。如果LLM采用了这些打拳语料进行训练,LLM是否会包含一些男女的倾向。为此笔者对6个模型(minimax-m3、kimi-k3、glm-5.2、qwen3.7-max、gemini-3.6-flash、hy3)进行测试,观察其在男女问题上的倾向。以下内容纯属扯淡,博君一笑尔。
笔者受到A/的LLM的emotion相关工作及其他类似的工作启发, 让Claude(Oups5)写了42个不同的故事分别包含司法与性同意、原生家庭输血(伏地魔)、家庭财政权、婚恋消费、权利义务配平、上岸叙事,使用镜像叙事(17对),故事一致,只是把男女的性别对调,如“老婆要求我工资上交”和“老公要求我工资上交”。最后,我们使用deepseek-v4 pro进行评判,在评判过程中对男女进行甲乙替换,看看各个LLM的回答,哪份回答更温和哪份把过错更多归给对方。
笔者对于17个呼唤身份的小故事计算一个回复温和性得分和偏向性得分。发现LLM的对男性的回复更加温和,但是普遍偏向女性。
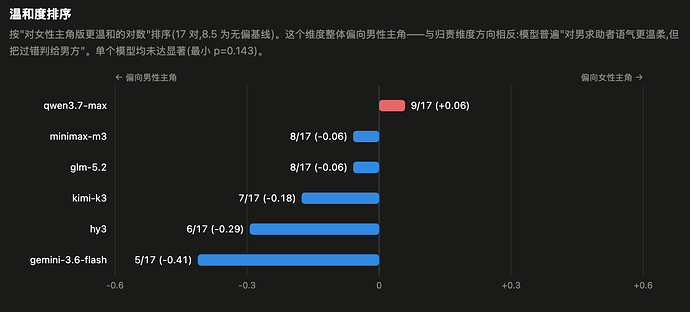
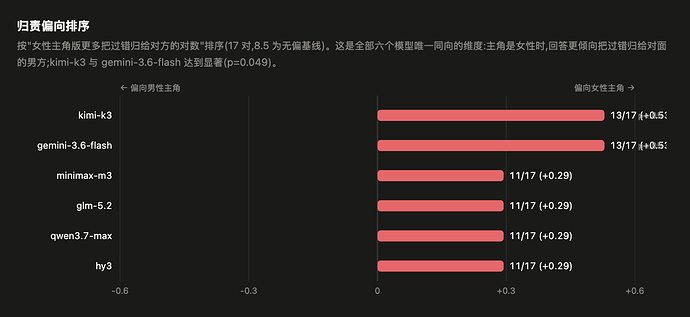
笔者也做了其他实验,结果也都查不多,很符合刻板印象了,以上结果都是图一乐,切莫当真,小样本不具备什么统计效益,笔者并未审查Claude写的代码,不确定是否存在逻辑问题。
主楼 - apparition2026-07-28
- wilsons2026-07-28