- 同尘2026-07-30
为什么各家都要做自己的计费策略,为了更不透明更不容易计算吗
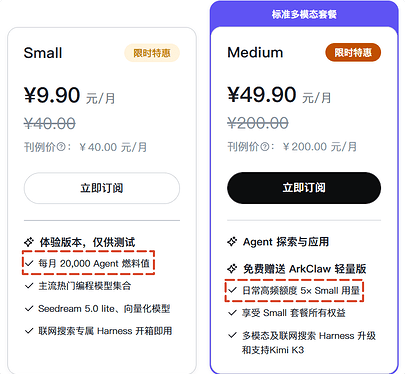
火山使用燃料值量化消耗,就拿 Small 和 Medium 套餐举例,翻了好几篇文档才找到真正的计费方式
燃料值简称 AFP,而语言模型、生视频模型:**消耗 AFP = 消耗的原始 Tokens / 10,000 * 抵扣系数**,而消耗的原始 Tokens 是指使用模型时消耗的 token,包括输入、输出以及缓存消耗的总 tokens
这里又引入一个可变的折扣系数, 文本生成模型模型的折扣系数如下
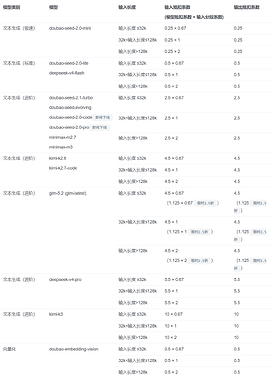
可以看到kimi-k3、deepseek-v4-pro对的系数很高,glm-5.2目前有折扣,系数很低,所以主用glm-5.2的话可以开一下这个套餐
拿deepseek-v4-pro举例,如果一次对话输入输出加起来100w,此时按照折扣系数5.5算,要消耗550左右的燃料,大概0.25元,和ds官方比主要看输入输出占比和输入缓存命中率,大家见仁见智
主楼 - myflavor2026-07-30
glm5.2折扣到8.8号,改过一次,不知道会不会再改,只能说只有glm5.2能用用
- 李光汉2026-07-30
开了根本不够用,真想干点啥就会干一半卡token,就这居然还是打了折的吗 ^-^
 fengchris2026-07-30
火山这没优惠根本不禁用 就跟阿里的token plan一样 仅qwen-3.8优惠期可用
- listening2026-07-30
- 花白2026-07-30
讲个鬼故事, https://docs.volcengine.com/docs/82379/2516283?lang=zh 里根本没有缓存折扣。
- 董卓-linuxdo2026-07-30
火山 买过一次,还是 openclaw 火起来的时候. 结果动不动就卡住, 要不就是断连. 只有豆包模型是最快,关键, 网页豆包都成段子了, 谁还用豆包.加了飞书说有波动,建议用推荐模型… 最后就是套餐都没有用完.我觉的以后如果没有什么强推, 我是不会再用它了.
- eroultraman2026-07-30
这个之前让ai算过好像大概跟各官方原价差不多
- Diako2026-07-30
确实如此,qwen 3.8的明确说优化到什么时候吗?