- cmkbviurg2026-08-15
心血来潮,用opus-5部署了 Qwen3.8-27B-UD-Q8_K_XL.gguf,分别测试了鹈鹕骑车和秦始皇骑北极熊。
部署环境
配置 |
详情 |GPU |
1 × AMD gfx1100(Navi31 XTW,RDNA3),96 CU,48 GB GDDR6,带宽 864 GB/s |ROCm |
7.2.4 |推理引擎 |
llama.cpp commit7e4c0a9(2026-08-15),HIP 后端 |模型 |
Qwen3.8-27B-UD-Q8_K_XL.gguf(unsloth)· 31.46 GB |部署性能
开启投机解码,输出速度约32tok/s
任务一
输入:创建一个HTML,内容是SVG绘制一个鹈鹕骑自行车的2D动画
思考等级:low
点击直接访问
思考等级:medium
点击直接访问
思考等级:xhigh
点击直接访问
任务二
输入:创建一个HTML,内容是SVG绘制一个秦始皇骑北极熊的2D动画
思考等级:low
点击直接访问
思考等级:medium
点击直接访问
思考等级:xhigh
点击直接访问
总结
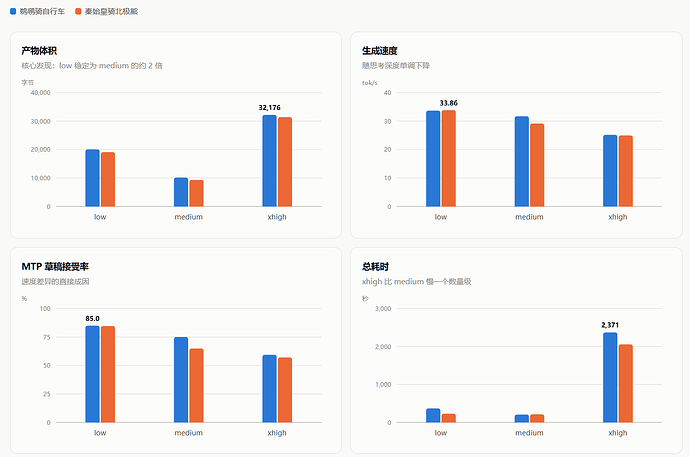
xhigh是真的慢,不过毕竟是稠密模型,带宽能达到的上限速度也没多少,也因为这个,估计没多少人部署。
同时请opus5出了个详细报告,可访问:详细报告
主楼 - cmkbviurg2026-08-15
另外还有个小插曲,一开始测xhigh模式设置的max_token是32k,结果光思考长度就达到上限截断了…
- Zxkws2026-08-15
看着还不错呢,实际使用效果如何呀