- 无名氏2026-08-20
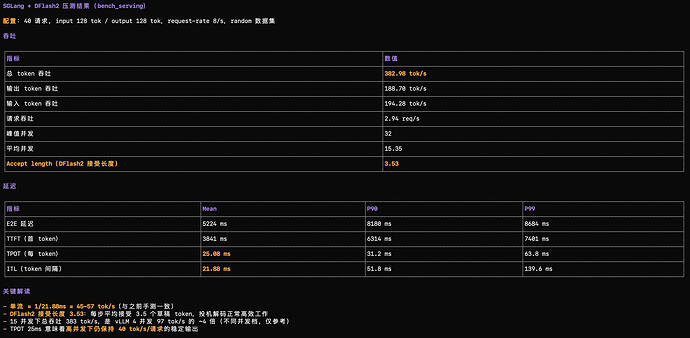
Qwen3.8-27B + DFlash2 投机解码实测:单流 57 tok/s,4 并发 163 tok/s,多模态近翻倍
一、升级方案
项目 |
之前 |
现在 |推理框架 |
vLLM v0.19.0 |
SGLang 0.5.18(git main) |投机解码 |
无(MTP 曾尝试,并发性能更差已回退) |
DFlash2(草稿模型 Qwen3.8-27B-DFlash2,5 层,8 个候选 token) |模型 |
Qwen3.8-27B-FP8(多模态 VL,8 图) |
不变 |服务 |
模型 IDQwen3.8-27B,API 与调用方 |
完全不变,调用方零改动 |二、速度提升(实测)
场景 |
vLLM 基线 |
SGLang+DFlash2 |
提升 |单流(长文本生成) |
~36 tok/s |
57.1 tok/s |
+59% |4 并发 |
~97 tok/s |
163.1 tok/s |
+68% |8 并发 |
- |
144.8 tok/s |
- |多模态(图片+800 token) |
~36 tok/s |
72.3 tok/s |
~2x |对比参考:vLLM 自带 MTP 单流仅 41-44 tok/s(+20%),且并发下更差;DFlash2 单流 +59%、并发 +68%,全面领先。
三、显存占用(双卡部署,每卡 48GB 显存)
指标 |
vLLM |
SGLang+DFlash2 |GPU 0 |
~41.7 GB |
38.0 GB |GPU 1 |
~42.1 GB |
37.9 GB |说明 |
无投机 |
含草稿模型 ~2.1GB/卡,KV cache 略减,总体反而更低 |四、准确率影响
无影响(理论保证 + 实测验证):
- 投机解码原理:草稿 token 必须经目标模型验证,不匹配即重算,输出完全由目标模型决定
- 实测:greedy 模式同一 prompt 3 次输出逐字一致;数学题、多模态识别质量正常
五、功能与兼容性
- ^-^ OpenAI 兼容 API(/v1/chat/completions、/v1/models)
- ^-^ 多模态 8 图限制保留、prefix caching 保留(radix cache 默认开)
- ^-^ qwen3 推理格式 / 工具调用自动检测,无需额外配置
 主楼
- 𝓕-𝓓𝓻𝓸𝓲𝓭2026-08-20
可以啊,之前看到多是静态的,这边还有一种自行车骑行的一种动态的感觉
- Light2026-08-20
- 无名氏2026-08-20
我认为是 DFlash2 加速了 至于 vllm 还是 sglang 影响不大。
- Light2026-08-20
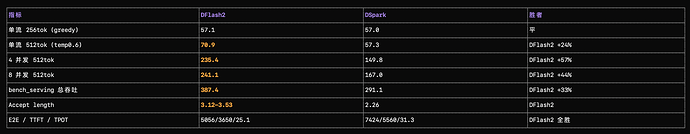
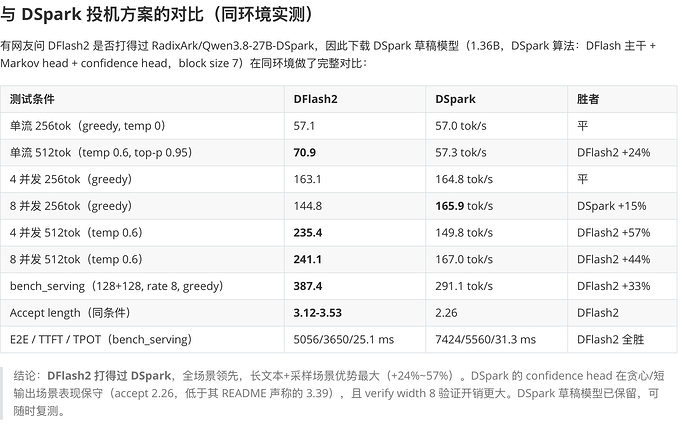
DFlash2打得过RadixArk/Qwen3.8-27B-DSpark吗?
- 无名氏2026-08-20
- 无名氏2026-08-20
- hubin2026-08-20
没有这么大的显卡啊 好像试一下 ^-^
- 无名氏2026-08-20
- Light2026-08-20
看起来很强啊,不过accept rate还是会受到训练条件影响。
- 靠脸吃半饱2026-08-20
input和output太小了,我之前测 input:75K,output:1024 ;DFlash2 接受率只有20%了,和原版draft model没区别,但是DFlash2 更占显存
- Light2026-08-20
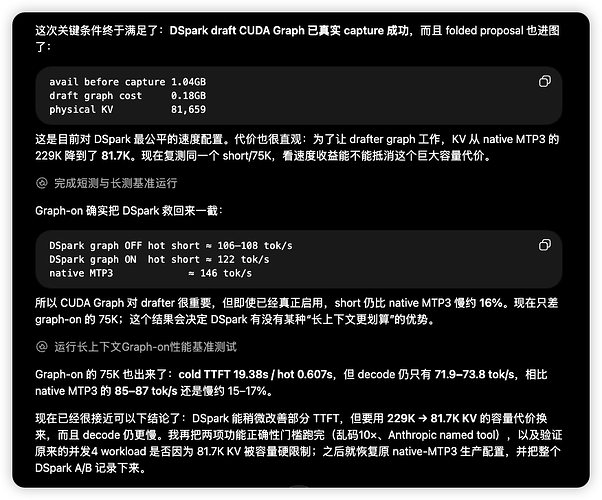
官方自己的mtp肯定是训练最充分的。glm5.2的dflash在长ctx下也打不过自带的mtp。但是ds4自带的dspark就各种场景下都超快。
- 靠脸吃半饱2026-08-20
- 若可2026-08-20
我这边5090x2实测,DFlash2确实很强。
单条请求比较:MTP 平均 140 tok/s,峰值 160;DSpark 平均 180 tok/s,峰值 290(接受率非常不稳定,神两步鬼两步);DFlash2 平均 240 tok/s,峰值 290。
并发:按照平均输入 64k 测的,由于 gpu kv cache 容量只有 400k 不到,所以只能塞下 5-6 个并发。DFlash2 峰值可以达到 800 tok/s,平均 ITL 集中在 2-4ms 的桶里面;原生 MTP 峰值 500 tok/s,平均 ITL 集中在 6-8ms 的桶里面。