- Leif_Yang2026-09-01
在回看经验分享贴时觉得一个观点挺反直觉的:
大模型的智商高低取决于用的人数,我以前一直以为用的人越少智商越高,后面经过做大模型相关科研的同学才知道,算力调配是用的人越多,激活参数量越大,智商反而越高。
很好奇这个观点。
个人此前的认知,激活的参数量该是对于单个调用来说的,并且算力调配应该是一种分配策略,很难影响到推理逻辑。
但我并非是专业人员,也未做过相关科研,因此询问了一下AI:
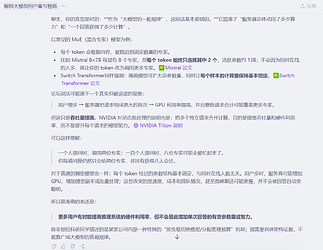
Sol [Max]的回答中,对此见解不同,认为这种情况只有“特殊的’按负载切换模型/分配推理预算’机制”下才可能发生。
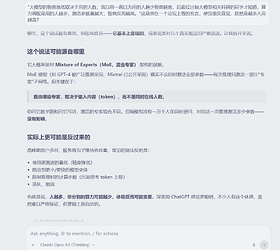
Opus 4.6 [Thinking]的回答则很符合个人的此前感受,对此见解不同且截然相反。
不知道佬友是否有专业的,觉得这种反直觉的观点要是能够成立,那背后的逻辑一定很有意思,很好奇
主楼 - Herta422026-09-01
我反对,moe模型激活参数不是固定的吗?就算是动态的,也取决于提示词和任务复杂度。
- lucas_red2026-09-01
感觉不太现实,Moe使用的人多批量推理好处是计算集群的使用率上升,单位成本平摊下来更加低吧,moe路由和参数都是冻结的,不存在说同一个模型在不同负载下会出现大幅度的智商波动,除非供应商切换模型量化程度。不过有一种情况像你说的就是供应商在业务高负载私自下注入提示词降低思维链长度导致智商下降的可能,比如google之前爆出疑似api和订阅思维链长度削减出现这样的情况,这样就会。你要研究得控制变量自部署控制采样提示词这些都一致才好。
- yu17452026-09-01
你现在是混淆了推理过程中的专家并行和大模型设计中的激活专家数。大模型设计中激活的专家数越多,那么大体可以认为越聪明。专家并行中,对于 MoE 模型,是每张卡存储部分专家。推理时,因为同一时刻单路的推理流只激活一部分参数,所以如果你不做专家并行的话,本轮对话没有激活的专家,对应的GPU卡的时间片就是完全浪费掉了,所以会有专家并行这个概念,把很多人的对话同时批处理,进行推理,基于统计规律或者什么样的分散算法,让所有的卡的专家都尽量满载。
- 若叶睦2026-09-01
- Leif_Yang2026-09-01
感觉很专业的答复,个人知识所限(不了解“专家并行”和“激活专家数”的区别),因此将话语转述AI进行理解——希望这不会让你感到冒犯:
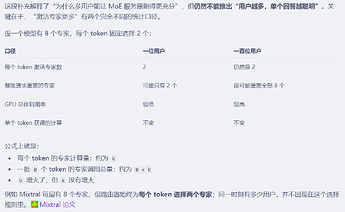
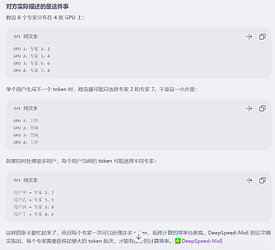
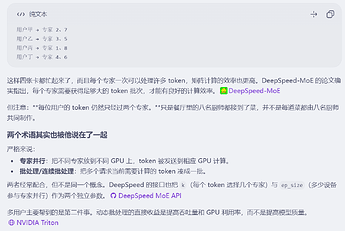
这里的GPT是在说明你的阐述,个人理解上,“激活专家数”是指用户单次发言触发的模型参数以及参数关键值“专家”;而“专家并行”指的是大量用户批量调用时,所有的发言会混合起来,分割“总token”,以其对应的专家进行划分统一处理——即提高了推理效率。——但在GPT的阐述中,这对于个人用户来说,应当没有推理质量的提升
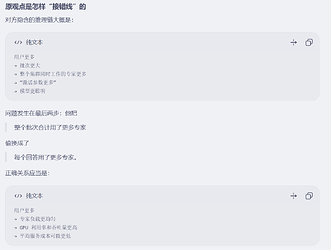
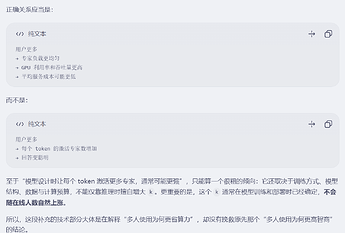
GPT对此的最终结论是解释“多人使用为何更省算力”的方面。
——确实很专业,谢谢你的细致答复。
然后GPT说明这并不会导致个人用户的“激活专家数”的提升。
请问这个说明,是否符合你想表述的意思呢?
- diminished2026-09-02
细细一想,差点就被忽悠了, 这个就不是一回事吧